
1/2
Je pensais avoir un contexte de 1M dans Codex.
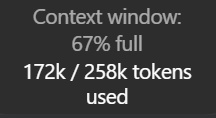
Puis j’ai remarqué que mon chat Astra affichait 172k utilisés sur 258k.
La spécification de l’API d’Astra indique bien 1,05M de tokens, mais Codex peut utiliser par défaut une fenêtre de contexte plus petite.
Dans ma configuration, la valeur par défaut était de 272 000 tokens.
Avec le facteur de fenêtre utilisable de 95 % du client, cela explique les 258k affichés dans l’application.
La limite maximale de mon catalogue de modèles local était de 872 000 tokens, ce qui correspond à environ 828k utilisables.
Votre configuration peut avoir une limite différente ; il vaut donc mieux demander à Codex de vérifier avant de la modifier.
Un compromis à prendre en compte : conserver davantage d’historique dans le contexte actif peut consommer une plus grande partie de votre quota.
Relever la limite à lui seul ne fait pas que chaque requête utilise toute la fenêtre.
Pour Codex connecté via ChatGPT, il n’y a pas de multiplicateur distinct pour les contextes longs, mais le traitement d’un plus grand nombre de tokens est tout de même comptabilisé.
L’utilisation de votre propre clé API suit la tarification de l’API.
Si vous voulez la fenêtre la plus grande prise en charge par votre configuration, collez ceci dans Codex :
---------------------------
Je pensais avoir un contexte de 1M dans Codex.
Puis j’ai remarqué que mon chat Astra affichait 172k utilisés sur 258k.
La spécification de l’API d’Astra indique bien 1,05M de tokens, mais Codex peut utiliser par défaut une fenêtre de contexte plus petite.
Dans ma configuration, la valeur par défaut était de 272 000 tokens.
Avec le facteur de fenêtre utilisable de 95 % du client, cela explique les 258k affichés dans l’application.
La limite maximale de mon catalogue de modèles local était de 872 000 tokens, ce qui correspond à environ 828k utilisables.
Votre configuration peut avoir une limite différente ; il vaut donc mieux demander à Codex de vérifier avant de la modifier.
Un compromis à prendre en compte : conserver davantage d’historique dans le contexte actif peut consommer une plus grande partie de votre quota.
Relever la limite à lui seul ne fait pas que chaque requête utilise toute la fenêtre.
Pour Codex connecté via ChatGPT, il n’y a pas de multiplicateur distinct pour les contextes longs, mais le traitement d’un plus grand nombre de tokens est tout de même comptabilisé.
L’utilisation de votre propre clé API suit la tarification de l’API.
Si vous voulez la fenêtre la plus grande prise en charge par votre configuration, collez ceci dans Codex :
---------------------------