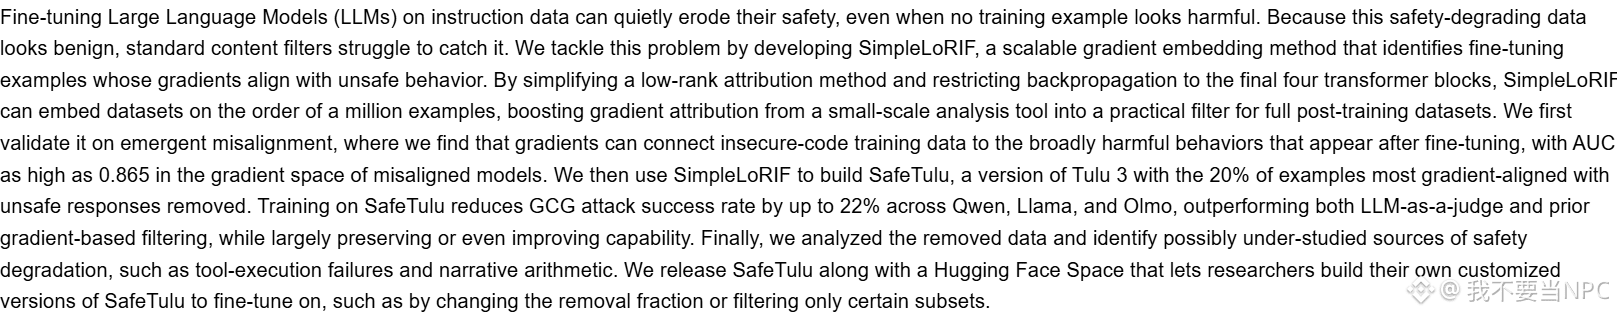
给大模型做微调数据过滤,这次盯上了梯度。SimpleLoRIF 是论文里提出的方法:它把梯度归因做简化,只回传到 Transformer 最后四层,让原本只能小规模跑的梯度分析能处理百万量级样本的微调数据集。
研究团队用它从 Tulu 3 里剔掉梯度上最贴近不安全回答的 20% 样本,做出 SafeTulu。按摘要,在 Qwen、Llama、Olmo 上用 SafeTulu 训练,GCG 攻击成功率最多降 22%,效果超过 LLM 裁判和此前的梯度过滤方法,模型能力基本保住甚至略有提升。
值得留意的是被剔掉的那部分数据长什么样——摘要点名了工具执行失败和叙述型算术题,这些内容表面看不出有害,标准内容过滤很难拦。
arXiv 预印本,未见同行评审;以上结论限于摘要给出的实验范围。SafeTulu 和可自定义剔除比例的 Hugging Face Space 已放出。
$BTC
研究团队用它从 Tulu 3 里剔掉梯度上最贴近不安全回答的 20% 样本,做出 SafeTulu。按摘要,在 Qwen、Llama、Olmo 上用 SafeTulu 训练,GCG 攻击成功率最多降 22%,效果超过 LLM 裁判和此前的梯度过滤方法,模型能力基本保住甚至略有提升。
值得留意的是被剔掉的那部分数据长什么样——摘要点名了工具执行失败和叙述型算术题,这些内容表面看不出有害,标准内容过滤很难拦。
arXiv 预印本,未见同行评审;以上结论限于摘要给出的实验范围。SafeTulu 和可自定义剔除比例的 Hugging Face Space 已放出。
$BTC