Que se passe-t-il lorsque la véritable liquidité d’un token se trouve en dehors d’Ethereum ?
Prenons vDOT, le token de staking liquide de Bifrost pour le DOT.
Si un marché de prêt sur Hydration doit évaluer le collatéral vDOT, l’activité de trading pertinente peut être concentrée dans des pools de liquidité natifs de Polkadot plutôt que sur de grandes plateformes d’échange centralisées.
C’est pourquoi l’intégration de DIA à Hydration présente un intérêt technique.
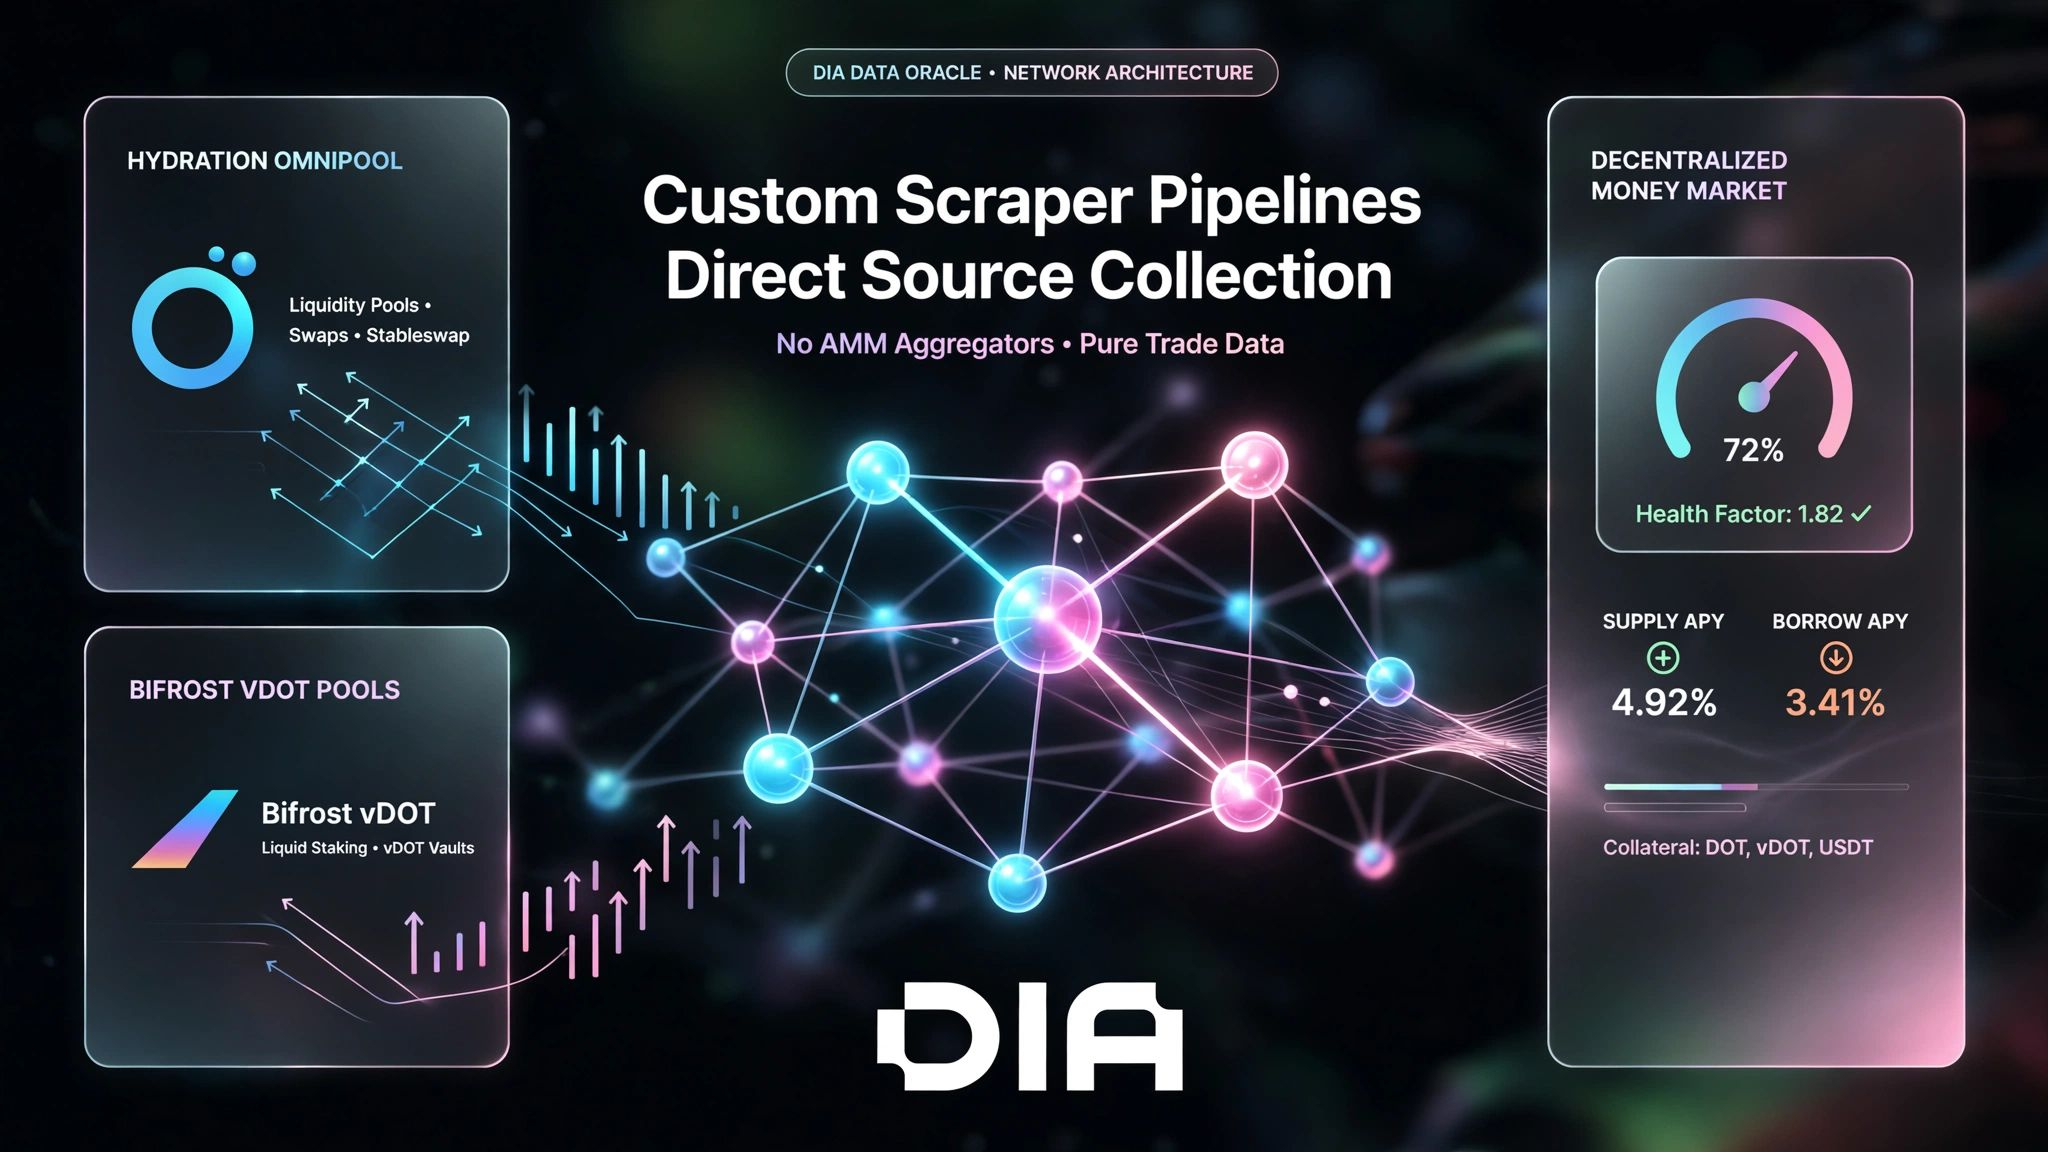
Au lieu de s’appuyer exclusivement sur des prix agrégés par des tiers, DIA a développé des scrapers sur mesure pour deux sources natives :
• Hydration Omnipool
• Les pools DEX natifs de Bifrost
Ces scrapers collectent directement les données de trading et de liquidité auprès des marchés concernés. $DIA traite et agrège ensuite ces données afin de produire des flux d’oracle pour les applications onchain.
Pour un protocole de prêt, c’est important, car les prix des oracles influencent la valorisation du collatéral et les seuils de liquidation.
La collecte de données natives peut améliorer la transparence et rendre compte de l’activité de marché que des flux externes génériques ne refléteraient peut-être pas aussi directement. Elle n’élimine pas, à elle seule, le risque de manipulation ; la profondeur de la liquidité, le filtrage et la configuration des flux restent essentiels.
La leçon générale pour les infrastructures multichaînes est simple :
Prendre en charge une chaîne ne consiste pas seulement à y déployer un contrat. Il faut aussi comprendre où ses actifs s’échangent réellement et collecter les données en conséquence.