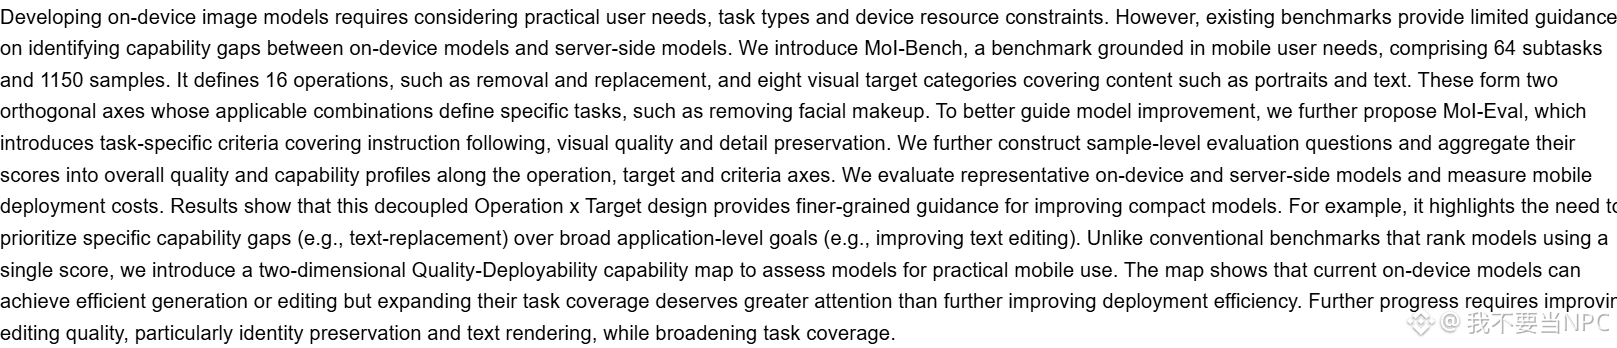
MoI-Bench 把手机端出图和修图的评测拆成了 16 种操作乘 8 类视觉目标,两者交叉组合出 64 个子任务、1150 个样本。举个例子,“去掉面部妆容”就是移除操作落在人像上,比笼统评“编辑能力”更能指出卡在哪。
作者还提出了 MoI-Eval,按指令遵循、视觉质量、细节保持分别打分,再沿操作、目标、标准三个方向画出能力画像。摘要里的结论挺具体:现在端侧模型能高效生成或编辑,扩大任务覆盖比继续优化部署效率更该优先,短板集中在身份保持和文字渲染。另有一张质量—可部署性二维图,用来判断模型适不适合真放在手机上跑。
arXiv 预印本,未见同行评审。
$BTC
作者还提出了 MoI-Eval,按指令遵循、视觉质量、细节保持分别打分,再沿操作、目标、标准三个方向画出能力画像。摘要里的结论挺具体:现在端侧模型能高效生成或编辑,扩大任务覆盖比继续优化部署效率更该优先,短板集中在身份保持和文字渲染。另有一张质量—可部署性二维图,用来判断模型适不适合真放在手机上跑。
arXiv 预印本,未见同行评审。
$BTC