

Dans l’épisode précédent, nous avons accordé la même importance au score du modèle et au momentum. Sur la période de test, nous avons obtenu un rendement de +172.93 %, un drawdown de -18.44 % et un ratio de Sharpe de 2.076. À la fin, j’ai annoncé que, dans le prochain épisode, nous ajouterions un buffer et un stop-loss à la combinaison, puis que nous la testerions sur la période de validation.
Avant de commencer, je me suis arrêté un instant. Les résultats des neuf stratégies les plus performantes étaient éparpillés dans différents scripts d’ablation et répertoires de cache ; les paramètres figuraient dans des dictionnaires de configuration et les fichiers de signaux n’étaient pas nommés de manière uniforme. Si je changeais de machine ou si je revenais deux semaines plus tard, pourrais-je retrouver exactement ces neuf résultats ? La réponse est non.
Alors, dans cet épisode, pas question de chercher davantage de rendement : je vais d’abord regrouper les neuf stratégies dans un répertoire permettant de les reproduire en un clic. Un backtest impossible à reproduire, ce n’est pas différent d’une histoire inventée.
Cette livraison comprend trois éléments : neuf fichiers de stratégie, six fichiers de signaux et un notebook unifié. Les neuf stratégies ont toutes été exécutées avec succès : les 9/9 résultats correspondent aux valeurs attendues, point par point.
I. Pourquoi commencer par reproduire les résultats plutôt que continuer à ajuster les paramètres
Les deux premiers volets de cette série portaient respectivement sur le nettoyage de l’univers des monnaies et la correction de l’interface de sélection. À ce stade, il y a déjà neuf stratégies. Il est facile de continuer à ajouter des paramètres, mais chacun d’eux rend la reproduction un peu plus difficile.
Les neuf stratégies précédentes provenaient des dictionnaires de configuration de `robust_ablation.py` et `risk_guard_ablation.py`. La même logique de sélection était recopiée dans différentes configurations, avec des paramètres codés en dur. En modifiant un signal, impossible de savoir si le signal a changé ou si le chemin d’exécution du code a changé. Plus gênant encore, lorsqu’on voit un chiffre, impossible de déterminer quelle version du code, quel fichier de signaux et quels paramètres l’ont produit.
La reproduction n’est pas un exercice purement formel. Elle transforme les sorties ponctuelles de scripts en fichiers que l’on peut citer, comparer et transmettre à d’autres pour vérification. Qu’il s’agisse ensuite d’ajouter les frais de financement, de prendre en compte le slippage ou de réaliser un walk-forward, il faut un point de départ stable.
II. Neuf fichiers de stratégie : fixer les paramètres sans recopier la logique
Le nouveau répertoire est `alpha/crypto/strategy_catalog/` ; les neuf fichiers de stratégie y sont placés. Chaque fichier correspond à une stratégie :
- Fusion top5
- Modèle buf4 stop-loss 35
- mom10 top5 long buf5
- Modèle buf4 stop-loss 10
- Modèle long buf5 stop-loss 10
- mom10 top5
- Modèle buf4
- Modèle long buf5
- mom10 top20 long buf5
Les neuf fichiers sont de fines sous-classes qui ne recopient pas la logique des classes de base. La sélection des monnaies, le buffer de classement et la machine à états du stop-loss restent définis dans `CryptoRobustStrategy` et `CryptoRobustGuardedStrategy` ; les sous-classes ne font que fixer les paramètres.
Chaque fichier exporte uniformément six objets : le nom de la stratégie, la famille de signaux, la classe de stratégie, les paramètres de backtest, les indicateurs attendus pour la période de test et les valeurs de référence pour la période de validation. Ces dernières ne sont renseignées que pour les trois stratégies mom10 ; elles restent pour l’instant vides pour le modèle et la fusion. Le notebook assemble automatiquement les éléments à partir de ces objets, sans qu’il soit nécessaire d’écrire neuf blocs de code de backtest à la main.
Pourquoi ne pas créer neuf implémentations indépendantes ? Parce que recopier la logique de sélection des monnaies dans neuf fichiers créerait neuf sources potentielles de bogues. Une modification de la classe de base profite aux neuf stratégies ; une modification de paramètres se limite à un seul fichier et n’affecte pas les huit autres.
La documentation en chinois en tête de chaque fichier précise quatre points : comment sélectionner les positions longues et courtes, quelle famille de signaux et quelles colonnes sont nécessaires, ce que signifient les paramètres fixes et dans quelles circonstances la stratégie échouera. Ce dernier point est important. Si un fichier de stratégie explique seulement comment gagner de l’argent, sans préciser quand elle peut en perdre, on risque facilement de continuer à ajuster les paramètres d’une stratégie déjà défaillante.
Voici un piège concret. Les paramètres `stop_pct` et `stop_cooldown` des trois stratégies avec stop-loss doivent tous deux figurer dans `BACKTEST_SETTING`. En effet, le moteur de backtest lit `setting.get("stop_pct")`, et non l’attribut de la classe. Si le paramètre ne figure que dans la classe, la stratégie détectera bien le stop-loss, mais le moteur n’effectuera pas la correction a posteriori du P&L. Le backtest produira quand même un résultat, mais les comptes du jour du stop-loss seront erronés. Une assertion a été ajoutée au notebook : l’attribut de la classe et la valeur de `setting` doivent correspondre, sinon une erreur est déclenchée.
Autre limite : `on_bars` dans `CryptoRobustGuardedStrategy` utilise p5 et p0 en dur. Cette classe ne prend en charge que la sélection par niveau, et non la sélection fusionnée. Aucune des neuf stratégies ne combine fusion et stop-loss ; la classe de base n’a donc pas été modifiée cette fois-ci. Cette limite est simplement précisée dans la documentation des trois fichiers avec stop-loss. Pour combiner fusion et stop-loss à l’avenir, il faudra d’abord extraire l’interface de sélection de la classe de base.
III. Six fichiers de signaux : trois familles, chacune avec une version de test et une version de validation
Les neuf stratégies partagent trois familles de signaux ; il n’est pas nécessaire d’en créer neuf copies :
- Signal du modèle : p5, p0, score, issus d’un modèle LightGBM à cinq classes
- Signal mom10 : momentum des 10 derniers jours de trading
- Signal fusionné : moitié du classement du score du modèle et moitié du classement du momentum
Chaque famille de signaux comporte deux fichiers, un pour la période de test et un pour la période de validation, soit six fichiers au total.
Pourquoi ne pas copier un signal pour chaque stratégie ? Parce que le signal est une entrée et que la stratégie est une manière de l’exploiter. Un même signal de modèle peut être exploité de différentes façons : top5, buffer4, stop-loss à 10. Le copier neuf fois rendrait les vérifications de hash inutiles et augmenterait le risque de modifier une copie en oubliant les autres.
Tous les signaux utilisent le même schéma. Les fichiers fusionnés comportent trois colonnes de diagnostic supplémentaires :
| Colonne | Type | Signification |
|---|---|---|
| datetime | Datetime("us") | Minuit le jour de trading, heure sans fuseau |
| vt_symbol | String | Code du contrat |
| signal | Array(Float64, 6) | Probabilités des cinq classes |
| p5 | Float64 | signal[5], probabilité d’entrer dans la classe la plus élevée |
| p0 | Float64 | signal[0], probabilité d’entrer dans la classe la plus basse |
| score | Float64 | p5 moins p0 |
| mom_return_10 | Float64 | Momentum sur 10 jours |
| score_rank_pct | Float64 | Rang centile transversal du score du modèle, uniquement dans les fichiers fusionnés |
| mom_rank_pct | Float64 | Rang centile transversal du momentum, uniquement dans les fichiers fusionnés |
| blend_score | Float64 | Moitié de chacune des deux colonnes, uniquement dans les fichiers fusionnés |
Avant l’écriture, quatre points sont vérifiés : l’unicité de la clé composée de la date et du contrat ; l’absence de chevauchement entre les contrats et la liste d’exclusion des cryptomonnaies pures ; le maintien de `signal` au type `Array(Float64, 6)`, sans conversion en `List` ; la cohérence entre p5, p0 et score.
Il y a aussi un détail facile à oublier : l’ordre des lignes ne doit pas changer.
Lors de la sélection des monnaies, si plusieurs sont à égalité à la limite du classement, le tri stable utilise l’ordre initial des lignes pour décider lesquelles sont retenues. Trier le fichier de signaux par date ou par contrat peut donc modifier les positions, et par conséquent les rendements. Toutes les projections et l’ajout de colonnes conservent donc l’ordre des lignes du fichier source ; le tri est interdit. Ce n’est pas une question de style de code, mais de reproductibilité des résultats.
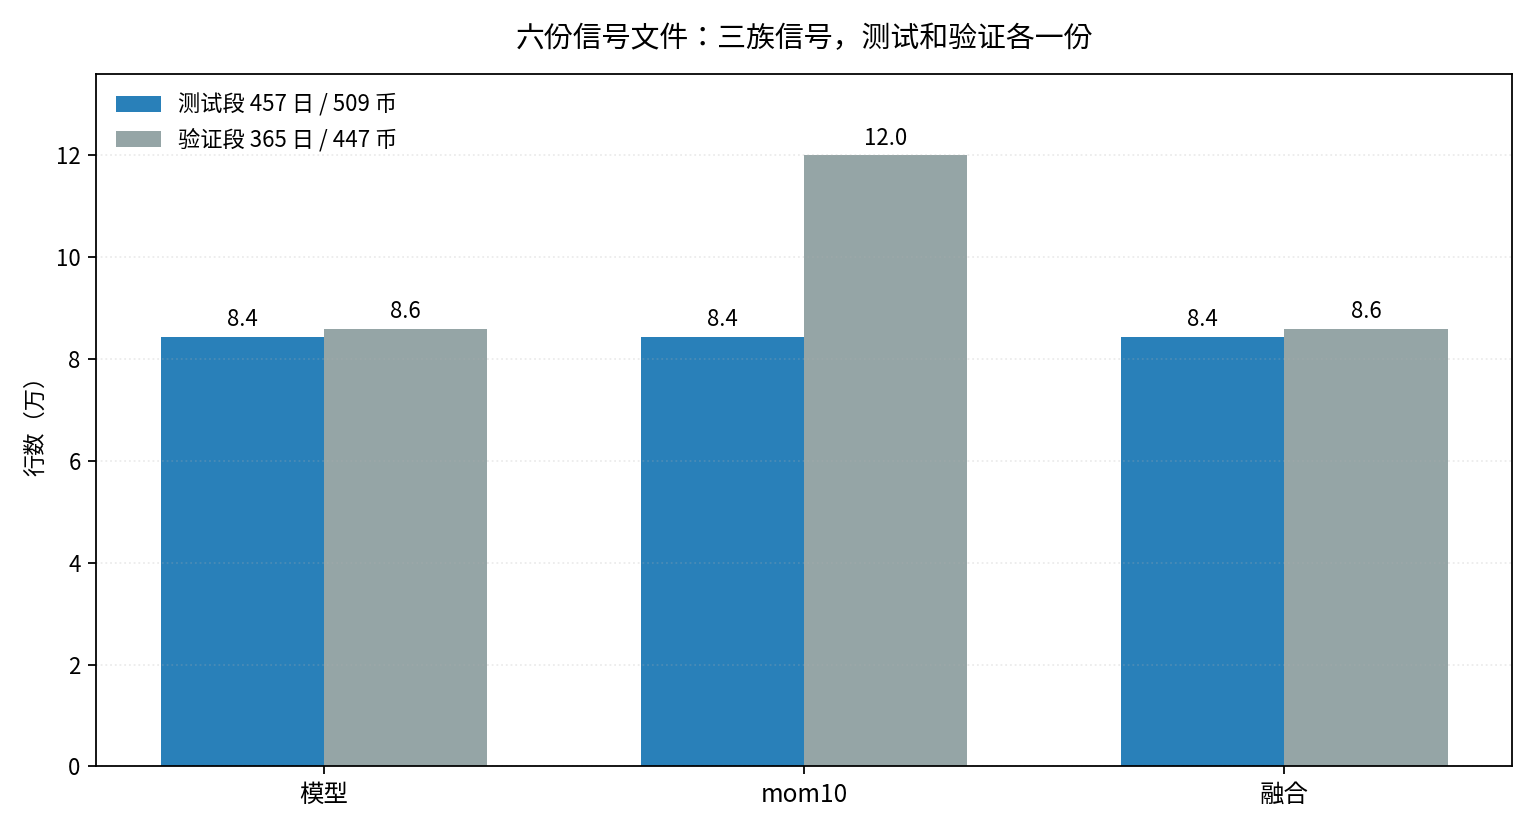
Figure 1 : chaque fichier de la période de test comporte 84 000 lignes. Pour la période de validation, les fichiers du modèle et de la fusion en comportent 86 000, et celui de mom10 en comporte 120 000. Le nombre supérieur de lignes pour mom10 en validation ne signifie pas qu’il y a davantage de monnaies, mais que la convention d’encodage est différente.
IV. Les périodes de test et de validation de mom10 ne sont pas interchangeables
C’est le piège le plus facile à rencontrer cette fois-ci.
Pour la période de test de mom10, on utilise `mom_return_10`, tronqué lors de la préparation du jeu de données et limité à l’intervalle [-3, 3]. Pour la période de validation de mom10, on utilise `mom10` dans la table de risque, sans troncature. Les deux fichiers semblent contenir le même signal, mais leur encodage est différent.
Ils ne sont pas interchangeables et on ne peut pas recalculer l’un à partir de l’autre. Il faut d’abord vérifier la convention utilisée avant toute comparaison entre périodes. En concaténant directement les résultats des deux périodes, on pourrait croire qu’ils mesurent tous deux mom10, alors qu’en réalité ils ne mesurent pas la même chose.
La période de validation du modèle comporte une autre limite. VALID participe à l’arrêt anticipé quotidien selon l’IC ; `model_valid` n’est donc qu’à moitié hors échantillon. Pour ce modèle, `best_iteration` vaut 290 et l’IC quotidien de la période de validation est de 0.0373. Ce chiffre ne peut pas être considéré comme un résultat hors échantillon fiable ; il faut donc le relativiser dans les conclusions tirées de la période de validation.
Pour garantir l’absence de dérive entre l’entraînement et la projection, un contrôle de parité sur le jeu de test a été ajouté au notebook : les prédictions sur la période de test sont recalculées et comparées ligne par ligne à celles de `model_test` déjà enregistrées. L’écart absolu maximal doit être inférieur à `1e-6`. Cette fois, l’écart observé est de 0.0.
V. Un notebook pour tout vérifier, charger, backtester et rapprocher
Le point d’entrée unifié est `strategy_catalog_backtest.ipynb`. Quatre paramètres contrôlent le mode d’exécution :
- `RUN_SEGMENTS=["test"]` : commencer par exécuter uniquement la période de test
- `FORCE_REBUILD_SIGNALS=False` : reconstruire les signaux uniquement s’ils sont manquants
- `RETRAIN_MODEL=False` : par défaut, ne pas réentraîner le modèle et utiliser directement celui en cache
- `ALLOW_MODEL_MISMATCH=False` : arrêter l’exécution si le modèle ne correspond pas, sans poursuivre silencieusement
Le processus comporte six étapes :
1. Charger AlphaLab, les composants de CRYPTO.LOCAL et le filtre des cryptomonnaies pures
2. Vérifier ou générer les six fichiers de signaux
3. Importer dynamiquement les neuf modules de stratégie et assembler le catalogue de stratégies
4. Charger les trois familles de signaux et les données OHLC pour chaque période, puis appeler le moteur de backtest pour chacune
5. Écrire les indicateurs JSON de chaque stratégie et les fichiers parquet de valeur liquidative quotidienne
6. Générer un tableau de rapprochement regroupant les valeurs réelles, les valeurs attendues, les écarts et le résultat de la vérification
Le backtest réutilise `risk_guard_ablation.run_config` ; aucun nouveau moteur n’est écrit. Celui-ci comprend déjà le remplacement du P&L le jour du déclenchement du stop-loss, la remise à zéro du reliquat le lendemain, le maintien des frais et le recalcul des indicateurs. Réécrire un moteur de backtest pour ce catalogue finirait tôt ou tard par produire des résultats différents entre les deux moteurs.
Les critères de rapprochement sont fixes :
- L’écart de rendement et de drawdown maximal ne dépasse pas 0,01 point de pourcentage
- L’écart du ratio de Sharpe ne dépasse pas 0,001
- L’écart du ratio de Calmar ne dépasse pas 0,01
- Le nombre de transactions et le nombre de stop-loss doivent être exactement identiques
Cette fois, les 9 stratégies sur 9 ont passé les vérifications. La valeur liquidative quotidienne de chaque stratégie comporte 457 lignes, et la valeur finale des fonds est égale à 10 millions multipliés par 1 plus le rendement. Les trois stratégies avec stop-loss comptent respectivement 121, 646 et 652 déclenchements, exactement comme dans les enregistrements des stratégies.
Il ne s’agit pas de résultats à peu près similaires : ils correspondent point par point.
VI. Résultats des neuf stratégies
Voici les neuf stratégies dans un même tableau, classées par rendement décroissant :
| Stratégie | Signal | Rendement | Drawdown maximal | Sharpe | Nombre de transactions | Nombre de stop-loss |
|---|---|---:|---:|---:|---:|---:|
| Fusion top5 | Fusion | +172.93% | -18.44% | 2.076 | 7251 | 0 |
| mom10 top5 long buf5 | mom10 | +152.67% | -30.13% | 1.577 | 5879 | 0 |
| Modèle buf4 stop-loss 35 | Modèle | +151.47% | -31.42% | 1.635 | 4787 | 121 |
| Modèle buf4 | Modèle | +137.55% | -54.80% | 1.368 | 4745 | 0 |
| mom10 top5 | mom10 | +134.22% | -39.03% | 1.385 | 6201 | 0 |
| Modèle buf4 stop-loss 10 | Modèle | +130.86% | -16.25% | 1.906 | 4719 | 646 |
| Modèle long buf5 | Modèle | +115.08% | -51.89% | 1.174 | 4855 | 0 |
| Modèle long buf5 stop-loss 10 | Modèle | +114.01% | -14.39% | 1.846 | 4743 | 652 |
| mom10 top20 long buf5 | mom10 | +68.98% | -21.81% | 1.563 | 22474 | 0 |
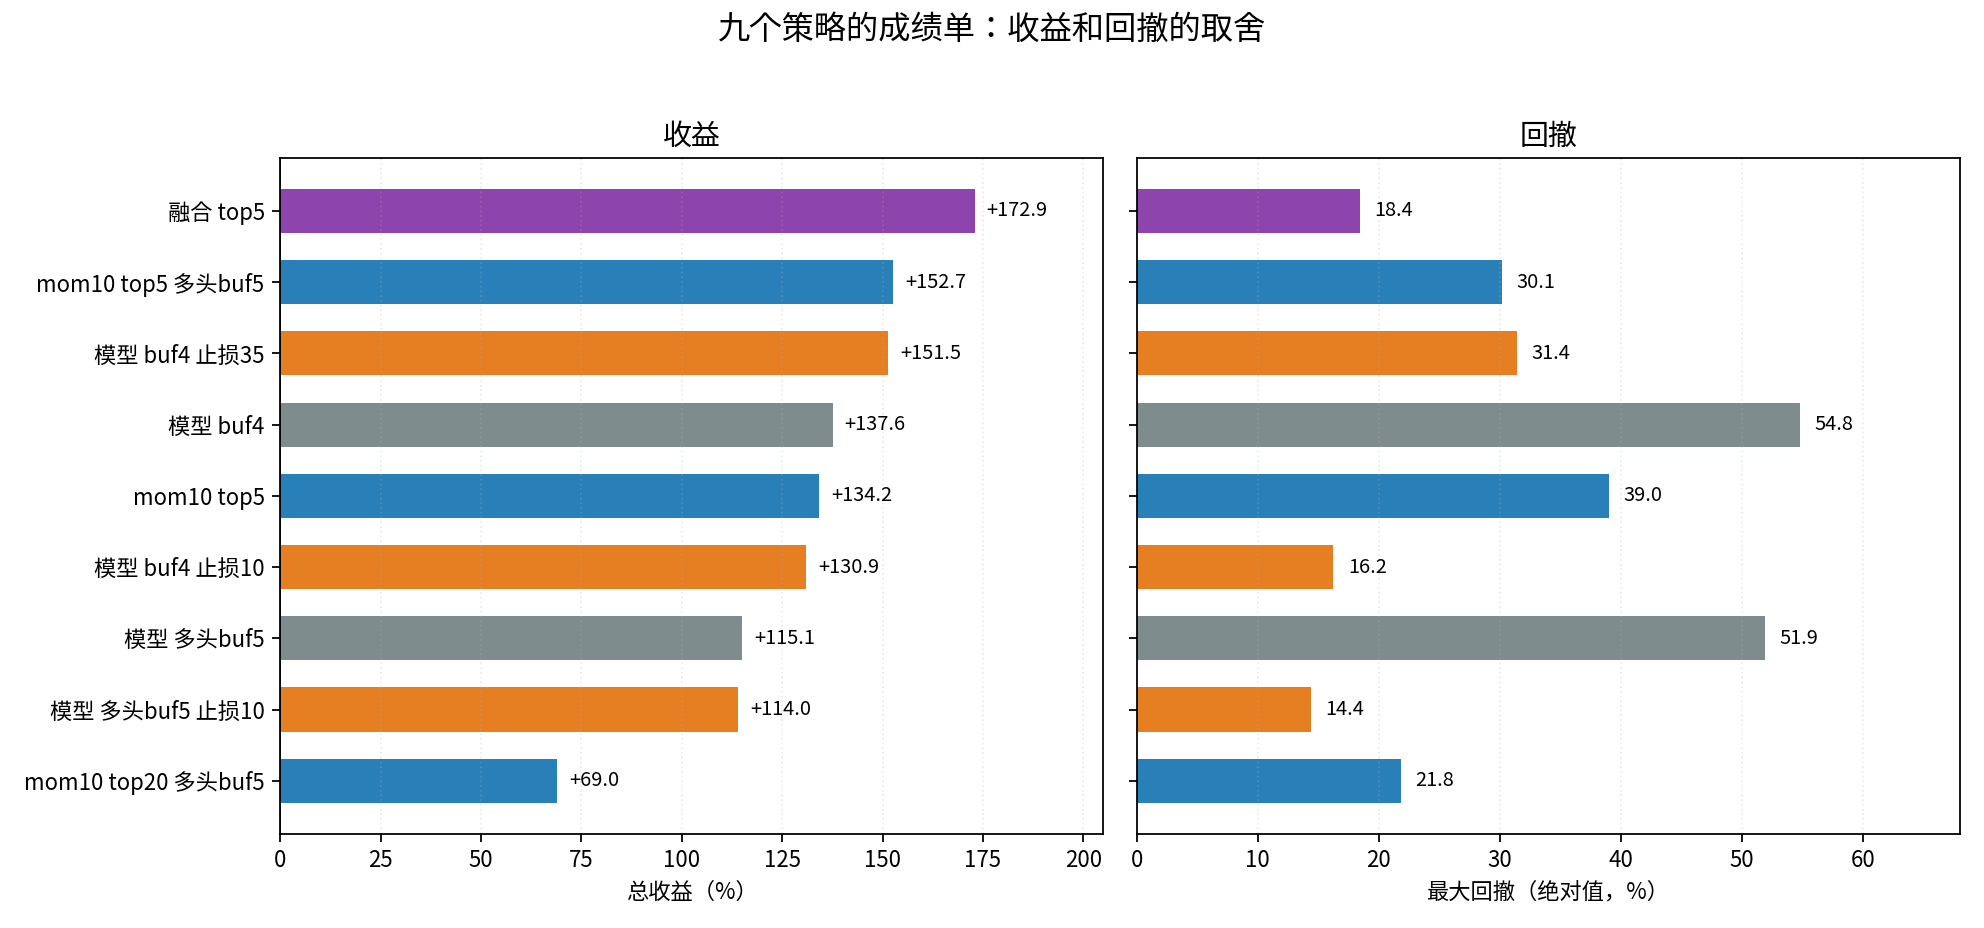
Figure 2 : le graphique de gauche montre les rendements, celui de droite la valeur absolue du drawdown, dans le même ordre. L’orange représente les stratégies du modèle avec stop-loss, le gris celles sans stop-loss, le bleu mom10 et le violet la fusion.
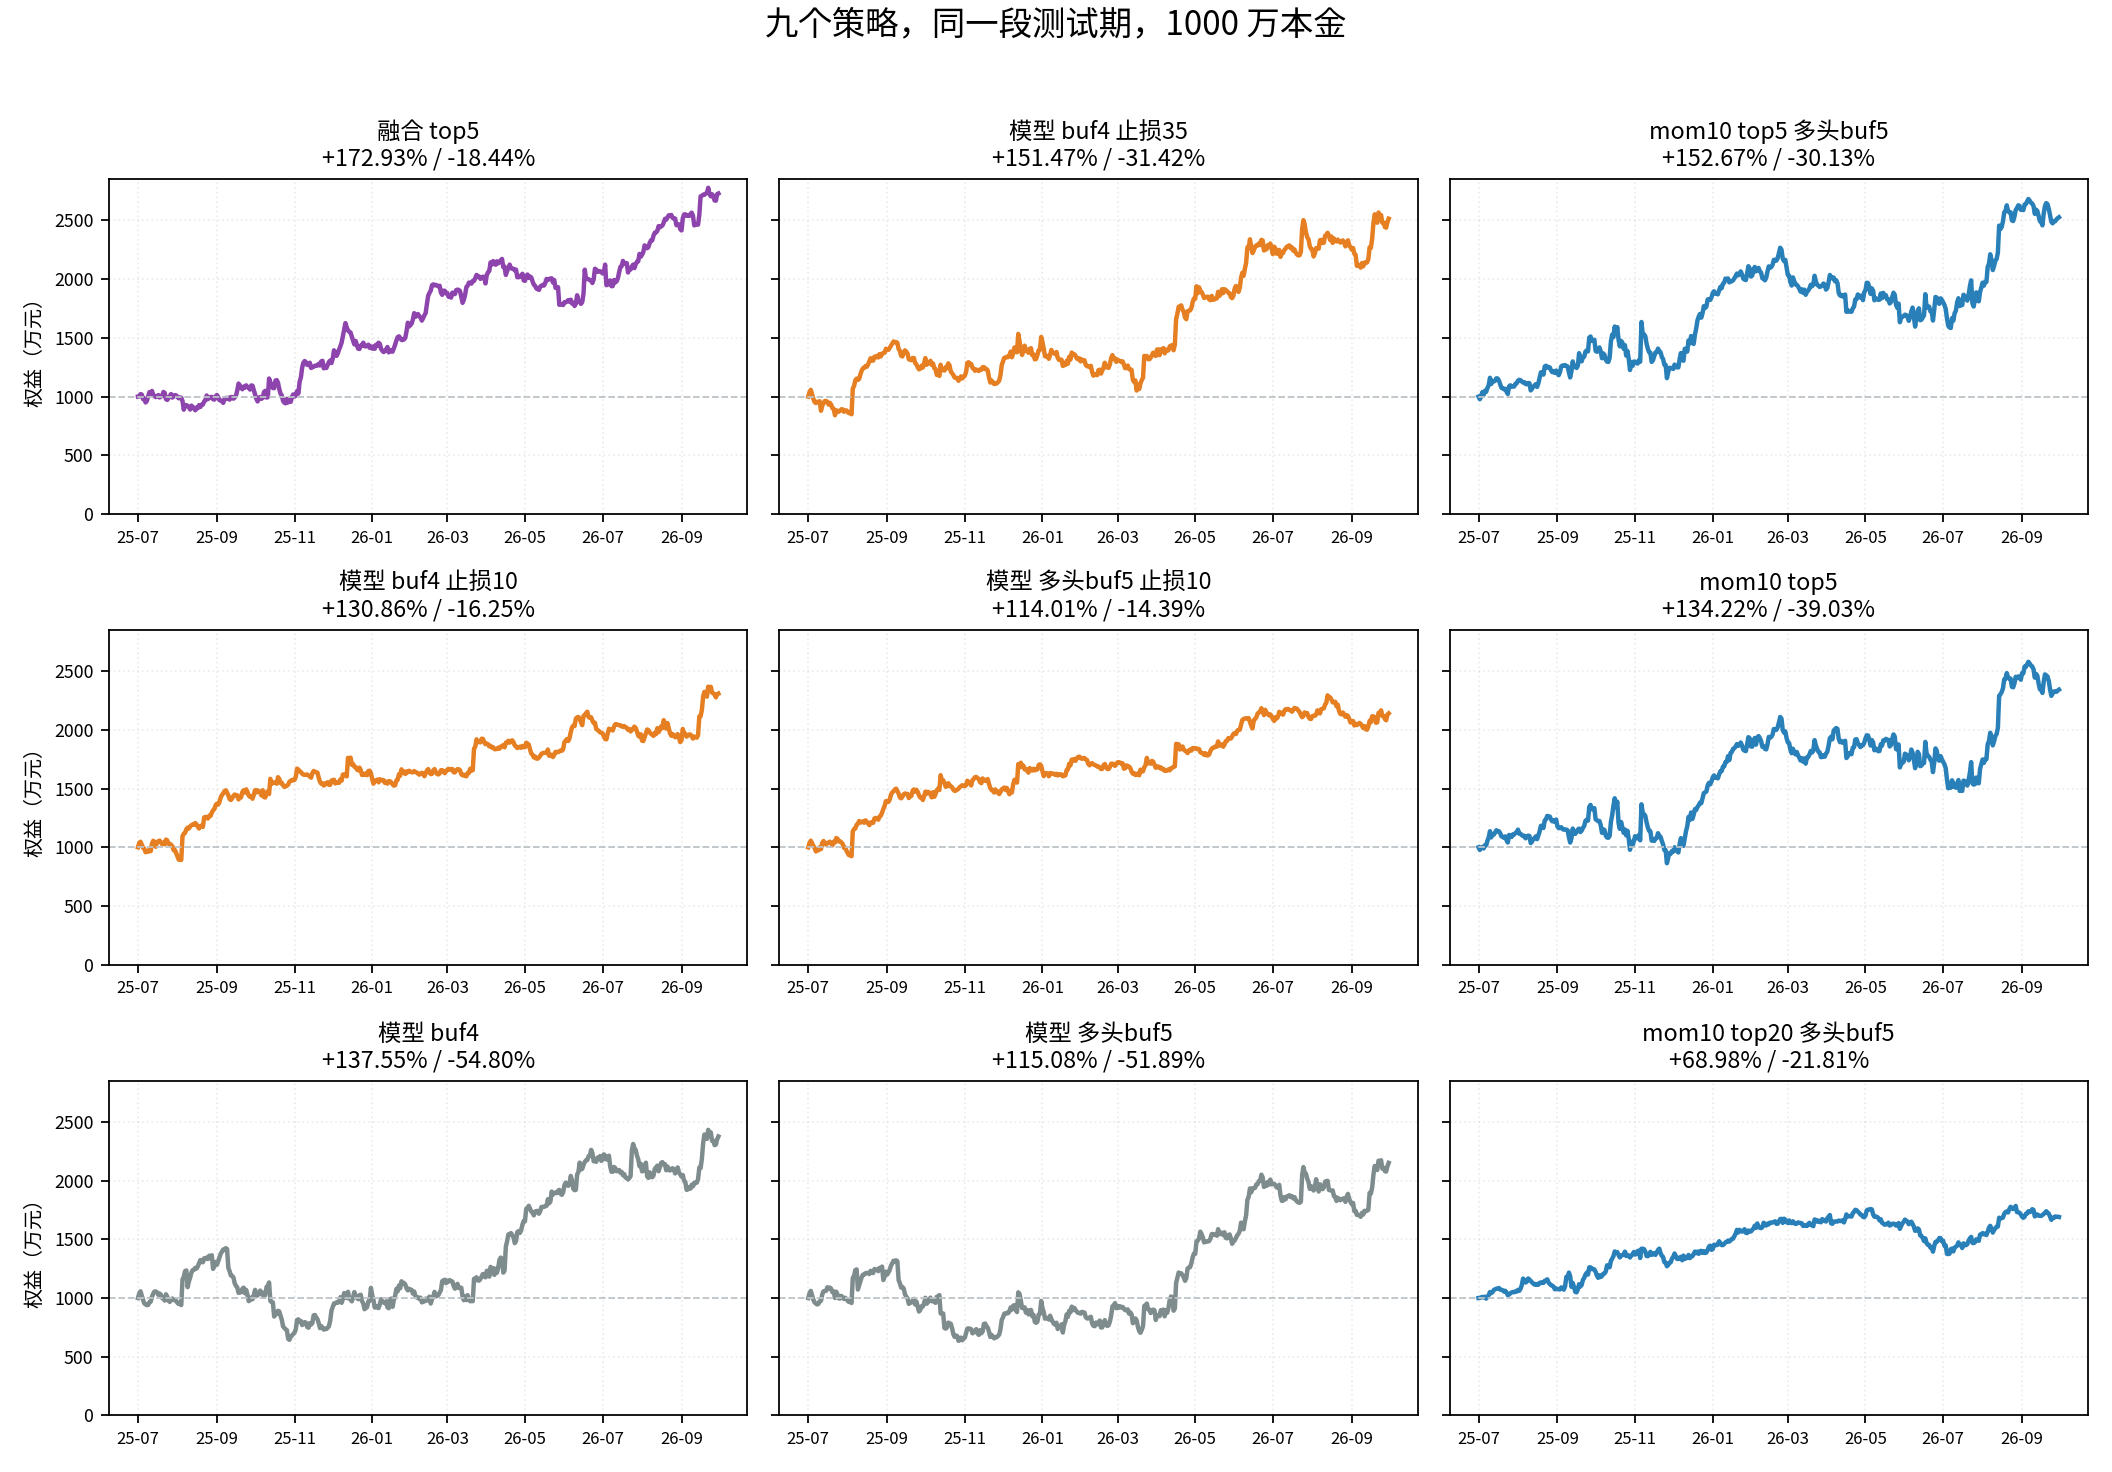
Figure 3 : courbes de valeur liquidative des neuf stratégies sur la même période de test et avec le même capital initial de 10 millions ; elles partagent le même axe vertical. Les deux chiffres du titre indiquent le rendement total et le drawdown maximal.
Quelques observations :
Premièrement, la fusion reste en tête. Avec un rendement de +172.93 %, un drawdown de -18.44 % et un Sharpe de 2.076, elle obtient les meilleurs résultats des neuf stratégies sur ces trois critères. Son ratio de Calmar est de 7.49 ; c’est aussi la seule configuration dont le rendement, le drawdown et le Sharpe dépassent simultanément ceux de la meilleure variante mom10. Comparée uniquement à mom10 top5, la stratégie Modèle buf4 stop-loss 35 remporte elle aussi les trois critères, mais elle reste derrière mom10 long buffer5 et son rendement de +152.67 %.
Deuxièmement, le stop-loss réduit le drawdown, mais il a un coût. Les deux variantes stop10 ramènent le drawdown à -14.39 % et -16.25 %, avec des Sharpe de 1.846 et 1.906. Toutefois, le volet précédent a déjà montré que stop10 est extrêmement sensible au slippage : avec 2 % de slippage, le rendement est presque nul. stop35 offre un rendement de +151.47 % et un drawdown de -31.42 % ; il est plus robuste et convient lorsque le slippage est incertain.
Troisièmement, le drawdown des variantes de référence du modèle reste compris entre -52 % et -55 %. Le buffer fait passer le rendement de négatif à une fourchette de +115 % à +137 %, mais ne résout pas le risque de perte extrême. L’amélioration du rendement et celle du risque sont deux choses différentes ; il ne faut pas ignorer le drawdown simplement parce que le rendement est redevenu positif.
Quatrièmement, mom10 top20 affiche le rendement le plus faible, à seulement +68.98 %, et totalise 22 474 transactions, ce qui en fait la stratégie la plus active des neuf. Élargir les positions ne signifie pas nécessairement faire mieux : les coûts de transaction rognent une partie du rendement. C’est aussi pourquoi il faudra intégrer les coûts par la suite.
Ce catalogue illustre des compromis ; il n’y a pas un seul vainqueur. Le choix dépend du capital investi, du niveau de slippage, de la tolérance au drawdown et des coûts de rééquilibrage.
VII. Journal de reproduction : commit, versions et hash
À chaque exécution, le notebook génère un journal de reproduction. Voici celui de cette exécution :
- Heure d’exécution : 2026-10-20T09:39:45
- Commit git : `261a7147ed6810bd4e7a76397a9149f7353a6470`
- État de l’espace de travail : modifications non validées
- Python 3.13.13, polars 1.41.2, lightgbm 4.6.0, vnpy 4.4.0
- `best_iteration` du modèle : 290
- IC quotidien de la période de validation : 0.03727
- Écart absolu maximal de parité sur la période de test : 0.0
Les SHA256 des six fichiers de signaux sont également tous consignés :
| Fichier de signaux | 12 premiers caractères du SHA256 |
|---|---|
| model_test | c8e9e5642a78 |
| model_valid | 77e53a0a794b |
| mom10_test | d59cf2be7a10 |
| mom10_valid | 70e25941c252 |
| blend_mom10_test | 1d5b40457ab2 |
| blend_mom10_valid | c379b7b1bab9 |
L’espace de travail contient des modifications non validées ; il faut le signaler honnêtement. Cela signifie que les résultats correspondent à un code qui ne se trouve pas dans un commit propre. À strictement parler, le numéro de commit ne suffit donc pas nécessairement à permettre à quelqu’un d’autre de tout reproduire à l’identique. Avant la prochaine exécution, il faudra soit valider les modifications, soit enregistrer également le diff. L’intérêt du journal de reproduction n’est pas de faire bonne figure, mais de conserver les différences de manière traçable.
La prochaine fois que quelqu’un demandera d’où vient ce chiffre, il suffira de lui transmettre le journal d’exécution, les hash des signaux et le notebook.
VIII. Limites et prochaine étape
Commençons par éliminer les illusions.
Les neuf résultats proviennent tous d’une seule période de test, de juillet 2025 à septembre 2026, soit 457 jours. Les paramètres ont également été ajustés à plusieurs reprises sur cette période de test ; il ne s’agit donc pas d’un véritable hors-échantillon. La reproduction des 9 résultats sur 9 prouve uniquement que le code et les signaux permettent de retrouver ces chiffres, pas que ces chiffres se reproduiront à l’avenir.
La période de validation du modèle n’est qu’à moitié hors échantillon, car VALID participe à l’arrêt anticipé. L’univers de monnaies de la période de validation de mom10 diffère de celui du modèle ; les résultats des différentes familles ne sont donc pas directement comparables. Les frais de financement, les liquidations forcées, le slippage réel, les nouvelles monnaies et le filtre de faible liquidité n’ont pas encore été pris en compte.
La prochaine étape comportera trois volets : intégrer le buffer et le stop-loss au signal fusionné, effectuer un backtest sur la période de validation, puis réaliser un walk-forward. Si la stratégie ne tient pas sur la période de validation, les +172.93 % ne seront qu’un joli chiffre de test et il faudra revenir dessus.
La reproduction n’est pas une fin, mais un point de départ. Commençons par poser de solides fondations avant de bâtir la suite.
Ce laboratoire de trading quantitatif continuera à publier ses travaux, des données aux facteurs en passant par la gestion des risques. Si vous trouvez cela utile, vous pouvez l’ajouter à vos favoris. À la prochaine.