

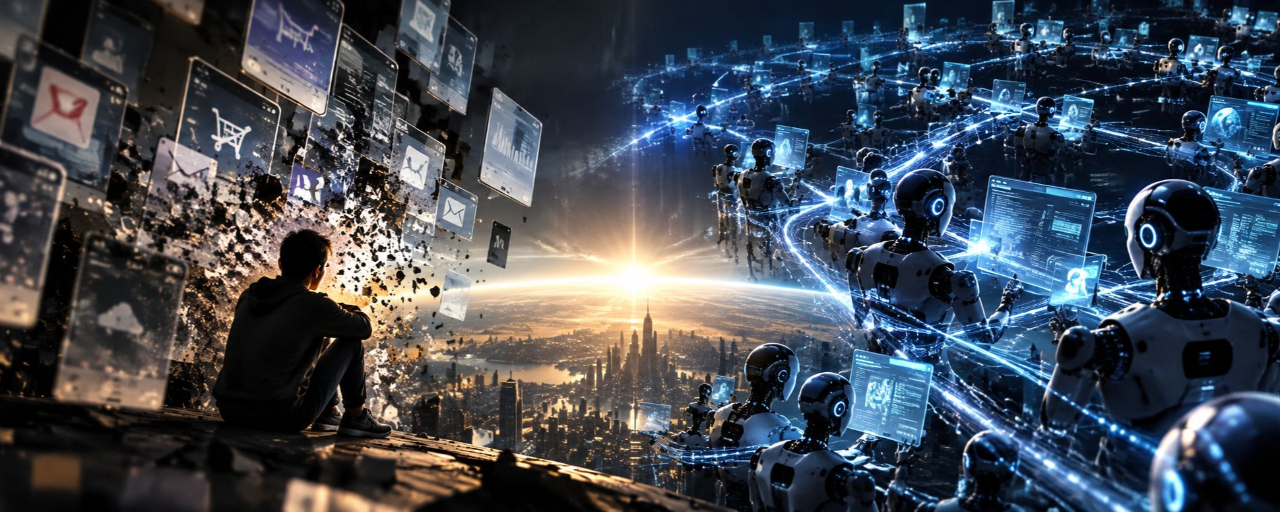

Au cours des vingt dernières années, presque tout le secteur de l’Internet s’est consacré à la même tâche : permettre aux humains d’utiliser les logiciels plus facilement.
Google a résolu le problème de la recherche d’informations, Amazon celui des achats en ligne, Uber celui de la répartition des trajets et Salesforce celui de la gestion de la relation client. Quant aux différents produits SaaS, ils couvrent les fonctions internes des entreprises, comme la finance, les ressources humaines, le marketing et la gestion de projet.
Ces produits reposent tous sur une même hypothèse fondamentale : les humains sont les principaux utilisateurs des logiciels. Les entreprises de logiciels doivent donc constamment optimiser leurs interfaces, réduire les obstacles à leur utilisation et améliorer l’expérience interactive, avant de générer des revenus grâce aux abonnements, à la publicité ou aux commissions sur les transactions.
Mais l’arrivée des AI Agents est en train de changer cette hypothèse. Lorsque les agents peuvent comprendre une tâche, appeler des outils externes, accéder à des bases de données, exécuter des programmes et réaliser des transactions dans le cadre de leurs autorisations, les humains n’ont plus besoin d’opérer eux-mêmes chaque logiciel.
Il ne s’agit pas seulement d’un changement de mode d’interaction. Lorsque l’acteur principal de l’utilisation des logiciels passe progressivement des humains aux agents, les modèles économiques bâtis au cours des vingt dernières années autour du trafic, de la rétention et des abonnements logiciels peuvent tous être soumis à un nouveau re-pricing.
Le logiciel le plus précieux de demain n’aura peut-être pas le plus grand nombre d’utilisateurs humains, mais sera peut-être le service appelé en continu par le plus grand nombre d’agents.
I. Les 234 milliards de dollars de dépenses SaaS entrent dans une phase de re-pricing
En juillet 2026, Gartner a publié une prévision importante pour l’industrie du logiciel : d’ici 2030, l’IA agentique pourrait influencer jusqu’à 234 milliards de dollars de dépenses en logiciels applicatifs d’entreprise, soit environ 20 % des dépenses SaaS d’entreprise à cette date.
Gartner appelle ce phénomène l’Agentic Arbitrage, c’est-à-dire le fait que les agents exécutent des tâches entre différents systèmes et réduisent la dépendance des entreprises aux interfaces logicielles traditionnelles et aux sièges utilisateurs associés.
Par le passé, une entreprise de 1 000 salariés pouvait devoir acheter un grand nombre de licences pour ses systèmes de CRM, d’ERP, de gestion de projet et de business intelligence. Mais si, à l’avenir, une partie du travail peut être confiée aux agents, l’entreprise n’aura pas nécessairement besoin d’équiper chaque étape d’exécution d’un siège humain distinct.
Prenons l’exemple du processus de vente. Par le passé, les commerciaux devaient saisir manuellement les informations client, mettre à jour le CRM, générer des devis, envoyer des e-mails, puis synchroniser les données de vente avec le système financier. Aujourd’hui, ces étapes peuvent déjà être reliées entre elles par des API et des outils d’automatisation. La prochaine étape consiste à permettre aux agents de déterminer eux-mêmes, en fonction des objectifs métier, quels systèmes appeler et quelles actions exécuter.
Les CRM et les ERP ne perdront pas pour autant leur valeur. Les dossiers clients, les commandes, les données de stock et les livres comptables continueront de nécessiter des systèmes fiables pour être conservés, mais les entreprises n’auront peut-être plus besoin d’autant d’employés ouvrant ces systèmes chaque jour pour exécuter les opérations une par une.
Cela aura un impact direct sur la tarification traditionnelle des SaaS basée sur les sièges, c’est-à-dire le modèle commercial qui facture selon le nombre d’utilisateurs. Par le passé, une source importante de croissance pour les éditeurs de logiciels était l’augmentation du nombre d’employés et de comptes logiciels chez les clients entreprises. À l’avenir, les entreprises pourraient réduire certains sièges humains tout en augmentant les budgets consacrés aux appels API, aux tâches automatisées et à l’exécution par agents.
Le modèle de revenus des éditeurs logiciels peut aussi passer progressivement d’une facturation par personne à une facturation selon le volume d’appels, le flux de travail et le résultat des tâches.
La valeur du logiciel n’a pas disparu, mais la manière de la mesurer pourrait changer.
Deuxièmement, Google et Anthropic mettent en place des standards de communication entre agents
Pour juger si une technologie est réellement entrée dans une phase d’industrialisation, je ne regarde généralement pas seulement combien de nouvelles capacités le modèle a démontrées, mais aussi si les entreprises commencent à investir des ressources pour établir des standards techniques communs.
En 2025, Google a lancé l’Agent2Agent Protocol (A2A). En avril 2026, la Linux Foundation a annoncé que l’A2A avait obtenu le soutien de plus de 150 organisations, dont des entreprises comme Google, Microsoft, AWS, Salesforce, SAP et ServiceNow.
L’objectif de l’A2A est de permettre à des agents développés avec des frameworks différents, et déployés par différents fournisseurs, de se découvrir mutuellement, communiquer, déléguer des tâches et échanger des résultats.
Parallèlement, le Model Context Protocol (MCP), lancé à l’origine par Anthropic, répond à un autre type de besoin : permettre aux systèmes d’IA de se connecter à des outils externes et à des sources de données via des interfaces standardisées.
Leur positionnement n’est pas le même. Le MCP résout principalement le problème Agent-to-Tool, c’est-à-dire la manière dont un agent appelle des outils ; l’A2A résout principalement le problème Agent-to-Agent, c’est-à-dire la manière dont différents agents coopèrent.
Le développement de ces deux protocoles signifie que, dans le futur, les systèmes logiciels n’auront pas nécessairement besoin d’une interface humaine pour interagir.
Supposons qu’une entreprise multinationale doive acheter un lot de serveurs. L’agent d’achat peut d’abord obtenir les informations sur les stocks et le budget, puis demander un devis à l’agent du fournisseur, appeler un service logistique pour calculer le délai de livraison, et enfin laisser le système financier vérifier l’autorisation de paiement.
Chacune de ces étapes peut être réalisée par des systèmes développés par différentes entreprises. Autrefois, les entreprises avaient besoin d’un grand nombre d’interfaces sur mesure et de coordination humaine. Aujourd’hui, le secteur essaie de réduire le coût de la collaboration entre systèmes grâce à des protocoles standardisés.
Bien sûr, l’unification des protocoles ne signifie pas que tous les systèmes peuvent déjà interopérer sans obstacle. L’authentification, la gestion des droits, les formats de données et le traitement des erreurs nécessitent encore des développements supplémentaires, mais du point de vue de l’évolution technique, les logiciels commencent déjà à concevoir des modes de communication pour des utilisateurs non humains.
Autrefois, nous développions des API בעיקר pour permettre à différents logiciels d’échanger des données. À l’avenir, ces interfaces pourraient devenir la base permettant aux agents d’exécuter des tâches de manière autonome, de coordonner des ressources et d’acheter des services.
Troisièmement, Stripe commence à permettre aux agents de payer directement ; les machines deviennent un nouveau sujet de consommation
En 2026, Stripe et Tempo ont lancé conjointement le Machine Payments Protocol (MPP), avec pour objectif de permettre aux agents de payer directement des API, des données et d’autres ressources numériques.
Les processus de paiement sur Internet traditionnel étaient principalement conçus pour les humains. L’utilisateur crée un compte, choisit une formule, saisit ses informations de paiement, puis confirme l’achat. Mais lorsqu’un agent exécute une tâche, il peut n’avoir besoin que d’un seul appel d’interface.
Par exemple, un agent de recherche financière, pour analyser un actif, peut devoir acheter temporairement trois services : des données de marché en temps réel, les flux de capitaux on-chain et des données historiques de volatilité.
Supposons que le prix d’un appel unique à chaque service soit respectivement de 0,003, 0,005 et 0,002 dollar. Avec le modèle traditionnel de paiement par carte bancaire, les frais fixes peuvent dépasser le prix du service lui-même. Les protocoles de paiement machine comme MPP et x402 tentent de rendre viables ces microtransactions payées à l’usage.
Une étude publiée en 2026 par Visa et Artemis commence aussi à observer le développement des paiements machine à travers des transactions réelles sur la blockchain. Les statistiques initiales indiquent que, dans les premières semaines suivant le lancement du MPP, environ 115 000 transactions ont été traitées, pour un montant total d’environ 25 000 dollars, soit une moyenne d’environ 0,22 dollar par transaction.
Ces données doivent encore être interprétées en tenant compte des conventions statistiques, de la nature des transactions et des conditions d’utilisation réelles dans l’environnement de production ; elles ne peuvent pas être assimilées directement au fait qu’une demande commerciale réelle ait déjà atteint une certaine échelle. Mais les modèles de paiement qu’elles révèlent méritent d’être étudiés.
Par le passé, les services numériques adoptaient souvent un abonnement mensuel ou annuel, car facturer quelques centimes à un utilisateur individuel n’était pas rentable. À l’avenir, si les agents peuvent effectuer des paiements à faible coût, les fournisseurs de données pourront facturer à chaque requête, à chaque calcul et à chaque exécution.
Une entreprise sans application grand public peut également vendre directement des services API spécialisés aux agents, sans avoir d’abord à construire un canal d’acquisition destiné aux utilisateurs ordinaires.
Pour le secteur crypto, cela pourrait créer une nouvelle demande de paiements en stablecoins. Toutefois, les stablecoins ne sont pas la seule option. Stripe, Visa et d’autres explorent aussi les identifiants de carte bancaire, l’autorisation de paiement et diverses méthodes de règlement.
Le fait que les paiements machine se généralisent ou non dépend du coût, de la vitesse, de la conformité réglementaire, des mécanismes de remboursement et des besoins réels des entreprises, et non simplement de la blockchain utilisée.
L’un des futurs utilisateurs importants des stablecoins ne sera peut-être pas l’humain, mais l’agent autorisé à acheter de manière autonome des services numériques.
Quatrièmement, la prochaine génération d’Internet n’aura peut-être plus besoin d’autant de points d’entrée destinés aux humains
À l’ère de l’Internet mobile, les entreprises se disputaient l’attention des utilisateurs. Le classement des boutiques d’applications, le trafic des moteurs de recherche, la publicité, la rétention, le DAU et le MAU ont constitué le système de croissance d’un grand nombre de produits Internet.
Mais le mode de fonctionnement des agents diffère de celui des humains. Lorsqu’un humain achète un service, il peut être influencé par la marque, la publicité, le design des pages et ses habitudes d’usage. Un agent, lui, peut comparer les services selon des conditions prédéfinies.
Par exemple, si un agent doit acheter un service de données en temps réel, ses critères de sélection peuvent être :
La latence des données est inférieure à 500 millisecondes.
Taux de disponibilité supérieur à 99,9 % sur les 30 derniers jours.
Le prix d’un appel unique est inférieur à 0,01 dollar.
Fournit une source de données vérifiable.
Prise en charge d’API standardisées.
Si plusieurs prestataires remplissent les conditions, l’agent peut ensuite comparer les prix, la vitesse de réponse, le taux d’erreur historique et les droits d’accès au service.
Dans un tel scénario, la conception de l’interface utilisateur a presque aucune valeur directe pour les appels effectués par des machines. La stabilité du service, la qualité des données, le coût des appels et des spécifications d’interface lisibles par les machines deviennent au contraire des indicateurs de concurrence plus importants.
Bien sûr, la marque et la réputation ne disparaîtront pas complètement. Les entreprises pourront toujours exiger que les agents privilégient des fournisseurs certifiés, ou n’appellent que des services conformes aux politiques de sécurité internes.
Mais à l’avenir, la distribution des logiciels pourrait se diviser nettement. Un système continuera de servir les humains, en obtenant des utilisateurs via les applications, les sites web, la recherche et les réseaux sociaux ; un autre servira les agents, en obtenant des appels via les API, les protocoles, les registres de services et des descriptions de capacités lisibles par les machines.
Les deux systèmes coexisteront longtemps, mais leur logique commerciale n’est pas exactement la même. Par le passé, les développeurs devaient réfléchir à la manière de faire découvrir leur application aux utilisateurs. À l’avenir, ils devront aussi réfléchir à la manière de faire découvrir leurs services aux agents, et à la manière de prouver qu’ils sont plus fiables que les autres.
Cela m’a amené à me poser une question :
Si, à l’avenir, les agents peuvent découvrir, comparer et acheter des services de manière autonome, alors qui contrôlera les points d’entrée de la distribution de ces services ?
Par le passé, Google contrôlait la porte d’entrée de la recherche, Apple contrôlait l’App Store, et Microsoft contrôlait de nombreux points d’entrée vers les outils de travail des entreprises. Mais dans l’économie des agents, le choix des services peut se faire entre les modèles, les plateformes d’exécution des agents, les systèmes d’autorisation d’entreprise et les réseaux de découverte de services.
Ces systèmes ne déterminent pas seulement quels services les agents peuvent trouver ; ils peuvent aussi influencer celui auquel ils donneront la priorité.
Si ce système de distribution arrive à maturité, la concurrence pour la porte d’entrée de la prochaine génération d’Internet ne se jouera pas nécessairement seulement entre les navigateurs et les boutiques d’applications.
Cinquièmement, les futures entreprises logicielles pourraient n’avoir aucun produit destiné aux gens ordinaires
Si, à l’avenir, un grand nombre de tâches sont effectuées par des agents, alors l’infrastructure nécessaire pour faire fonctionner ces agents pourrait faire émerger de nouvelles opportunités de création d’entreprise.
L’intérêt ici n’est pas de développer un nouveau chatbot, mais de résoudre les problèmes concrets de coopération entre agents.
D’abord, l’identité et l’autorisation (Agent Identity & Authorization).
Lorsqu’une entreprise déploie des centaines d’agents, chacun doit disposer d’autorisations différentes. Un agent d’achat peut acheter des logiciels, mais ne peut pas transférer tous les fonds de l’entreprise. Un agent financier peut payer des factures, mais dans les limites du budget, du bénéficiaire et des règles d’approbation.
Cela signifie que les agents ont besoin d’identités vérifiables, de périmètres d’autorisation clairement définis, de mécanismes de révocation des droits et d’un audit complet des opérations. Surtout dans la finance et les achats d’entreprise, le fait qu’un agent puisse exécuter des actions ne signifie pas qu’il devrait disposer d’un pouvoir d’exécution sans limite.
Ensuite, la découverte de services (Agent Discovery).
À l’avenir, les agents pourraient devoir chercher des services externes en fonction de la tâche. Un agent financier aura besoin de données on-chain, un agent juridique de bases de données réglementaires, un agent de développement d’environnements de test.
Si chaque agent doit intégrer tous les services à l’avance, le coût de développement et de maintenance sera très élevé. Le marché pourrait donc avoir besoin d’une infrastructure dédiée de découverte d’agents, permettant aux agents de rechercher des fournisseurs selon leurs capacités, leurs prix, leurs autorisations et leur fiabilité.
Ensuite viennent la réputation et la vérification (Agent Reputation & Verification).
Les humains peuvent juger si un fournisseur est fiable grâce à la marque, aux avis et à une coopération de long terme, mais les agents ont besoin d’indicateurs plus faciles à vérifier automatiquement, comme le taux de réussite des tâches, la disponibilité historique, le temps de réponse moyen, l’exactitude des données, ainsi que les mécanismes d’indemnisation et de correction en cas d’erreur.
Le principal défi technique ici n’est pas de créer un classement, mais de vérifier si la tâche a vraiment été accomplie et d’empêcher les prestataires de falsifier des données ou de manipuler les notes.
Même si un enregistrement est inscrit sur une blockchain, cela ne signifie pas que l’enregistrement lui-même est forcément vrai. Un système de réputation fiable nécessite toujours une vérification indépendante, des sources de données traçables et un mécanisme clair de responsabilité.
Enfin, le paiement et le règlement (Agent Payment & Settlement).
Une fois que les agents peuvent découvrir des services, vérifier leur identité et confirmer les prix, il leur faut encore effectuer le paiement autorisé, la livraison du service et la confirmation du résultat. Si ces fonctions peuvent former une infrastructure stable, elles pourraient soutenir un grand volume de transactions commerciales entre machines.
Le futur Agent Marketplace ne sera pas nécessairement une boutique d’applications destinée à être parcourue par des humains. Il pourrait simplement s’agir d’une API : les agents envoient des demandes de tâche, le système renvoie les prestataires répondant aux critères, puis gère l’appel, la facturation et la vérification des résultats.
Le consommateur ordinaire ignore même parfois l’existence de cette entreprise, mais elle peut traiter des millions de demandes de service chaque jour.
Le cœur de la compétitivité de ces entreprises ne réside plus dans la beauté de l’interface, mais dans le nombre d’agents qui intègrent leurs services dans leurs processus de travail quotidiens.
Sixièmement, les SaaS traditionnels ne disparaîtront pas tous, mais les barrières concurrentielles seront redistribuées
Il faut distinguer deux choses ici : la valeur fonctionnelle d’un logiciel et son interface d’utilisation humaine. Les AI Agents peuvent réduire fortement la nécessité de cette dernière, sans pour autant faire disparaître la première.
Les entreprises auront toujours besoin de bases de données, de systèmes financiers, d’authentification, d’enregistrements de transactions et de gestion de la conformité. De plus, les éditeurs logiciels traditionnels qui disposent de nombreuses données exclusives et de relations clients entreprises peuvent eux aussi transformer activement leurs produits en services pour agents.
Salesforce, SAP, Microsoft et d’autres entreprises ne seront pas nécessairement remplacées par de nouvelles sociétés. Elles ont elles aussi la possibilité de devenir des fournisseurs d’infrastructures clés pour l’économie des agents.
Ce sont surtout les logiciels qui manquent de données exclusives, qui n’ont pas de barrière métier et qui dépendent principalement de processus opérationnels complexes et des coûts de changement pour leurs utilisateurs qui seront réellement sous pression.
Lorsque les agents peuvent opérer directement sur plusieurs systèmes, l’avantage d’usage apporté par les interfaces logicielles peut être affaibli.
Cela dit, les agents eux-mêmes sont encore loin d’être suffisamment mûrs pour prendre en charge tous les travaux d’une entreprise. Gartner avait prédit que plus de 40 % des projets d’IA agentique pourraient être annulés d’ici la fin de 2027, principalement en raison de la hausse des coûts, d’une valeur commerciale peu claire et d’un contrôle des risques insuffisant.
Cela montre aussi qu’un modèle peut être capable d’exécuter une tâche sans que l’entreprise puisse le déployer durablement à un coût raisonnable.
Un agent qui réussit 95 % des tâches dans un environnement de test ne signifie pas qu’une entreprise peut lui confier en toute sécurité la gestion autonome des achats, des finances et des dossiers clients. Les 5 % restants peuvent impliquer des erreurs de paiement, des fuites de données, des commandes en double ou des opérations irréversibles.
Par conséquent, la véritable infrastructure d’agents ayant de la valeur à l’avenir ne sera pas nécessairement le produit le plus riche en fonctionnalités, mais le système capable de fonctionner de manière stable dans un environnement commercial réel et de gérer efficacement les erreurs, les autorisations et les risques financiers.
C’est aussi pourquoi la vérification d’identité, le contrôle des droits, l’audit des exécutions et la vérification des résultats des tâches pourraient devenir des composants essentiels de l’économie des agents.
Septièmement, pour qui, au fond, les entrepreneurs de demain devraient-ils développer des produits ?
Par le passé, les fondateurs commençaient généralement par considérer la taille de l’audience, avec pour objectif d’atteindre cent mille, un million, voire dix millions d’utilisateurs. Le produit devait être optimisé en continu, améliorer la rétention, puis être monétisé par la publicité, l’abonnement ou une commission sur les transactions.
Mais si l’Internet de demain contient de nombreux agents capables d’exécuter des tâches de manière autonome, les fondateurs devront repenser qui est réellement leur client.
Une entreprise fournissant des données financières n’aura peut-être plus besoin d’attirer cent mille investisseurs à ouvrir son site chaque jour ; elle pourra fournir directement des interfaces de données à des dizaines de milliers d’agents d’investissement.
Une entreprise qui fournit des services de reconnaissance d’images n’a pas nécessairement besoin de développer une application complète de retouche photo ; elle peut devenir un service professionnel appelé par d’autres agents pour traiter des tâches visuelles.
Une entreprise qui fournit de la vérification d’identité n’a pas besoin de faire connecter chaque jour un consommateur ordinaire à sa plateforme. Tant que les agents d’une entreprise doivent passer par son système d’autorisation pour exécuter des tâches sensibles, cela peut créer une demande de service continue.
Le plus grand changement de ce modèle économique est que les revenus ne dépendent plus entièrement de la fréquence d’utilisation du logiciel par les humains, mais peuvent provenir d’appels de tâches qui se produisent en continu entre machines.
Bien sûr, cela ne veut pas dire que les agents disposeront d’une capacité de dépense illimitée, indépendante des humains. Leurs budgets proviennent toujours des particuliers et des entreprises, et leurs droits de transaction doivent également être contrôlés.
Mais l’exécution réelle des budgets pourrait de plus en plus passer des humains aux logiciels. Et lorsque l’acteur de l’exécution change, la conception des produits, la distribution des services et les modes de facturation s’ajustent eux aussi.
Autrefois, les fondateurs de startups devaient réfléchir à la manière d’augmenter la rétention, de réduire le coût d’acquisition. À l’avenir, certaines entreprises natives de l’IA accorderont peut-être davantage d’importance au volume d’appels API, au taux de réussite des tâches, au coût moyen d’exécution et au nombre d’agents qui dépendent en continu de leurs services.
Cela signifie aussi qu’une nouvelle génération d’entreprises technologiques, très différente des SaaS traditionnels, pourrait émerger.
Ils n’ont pas d’interface front-end complexe, ne dépendent pas du classement des boutiques d’applications et n’ont pas besoin que des millions de consommateurs se connectent chaque jour. Ce qu’ils fournissent peut être simplement une capacité très spécialisée, comme la requête de données, la vérification d’identité, le règlement des paiements ou l’exécution de tâches.
Dès lors que cette capacité est appelée en continu par suffisamment d’agents, elle peut devenir une source de revenus stable.
Huitièmement, le temps qu’il reste à l’humanité est limité
Ici, le terme « humains » ne signifie pas que les humains vont bientôt être remplacés par l’IA, mais que le système logiciel construit au cours des vingt dernières années autour des clics, de la navigation et de l’usage humains entre dans une phase de bascule.
À l’ère de l’Internet mobile, les fondateurs cherchaient à faire télécharger davantage d’applications par les humains. À l’ère des agents, ils doivent étudier comment faire en sorte que leurs services soient découverts et appelés par davantage d’agents.
Par le passé, les éditeurs de logiciels dépendaient de la croissance du nombre d’utilisateurs, du temps d’utilisation et des sièges d’abonnement ; à l’avenir, une partie d’entre eux pourrait tirer ses revenus des appels API, de l’exécution de tâches, des transactions de données et des services automatisés.
Les principales portes d’entrée commerciales d’Internet étaient autrefois les moteurs de recherche, les navigateurs et les boutiques d’applications ; à l’avenir pourraient apparaître des réseaux spécialisés dans la découverte, l’identité, la réputation, le paiement et l’exécution pour les agents.
Cela a aussi changé ma façon d’évaluer les startups technologiques de nouvelle génération.
Je ne pense plus que toute entreprise logicielle de valeur doive nécessairement avoir une application destinée au grand public. Si une société peut fournir des données, des outils ou des infrastructures dont des millions d’agents ont besoin chaque jour, elle peut construire une activité très significative, même sans interface utilisateur complexe.
En revanche, les logiciels qui dépendent encore de clics répétés, de copier-coller, de saisies et de changements de page effectués par des humains pour accomplir le travail feront probablement face à une pression croissante.
Autrefois, nous développions des logiciels pour que les humains utilisent les ordinateurs. À l’avenir, nous développerons peut-être des logiciels pour que les agents utilisent d’autres logiciels.
Si je recommençais aujourd’hui une startup technologique, je prendrais très au sérieux une question qu’on a rarement posée par le passé :
Pourquoi mon produit devrait-il forcément être conçu pour être utilisé par des humains ?
Si, à l’avenir, des millions d’agents doivent acheter des données, vérifier des identités, appeler des outils, payer des frais et trouver d’autres agents pour accomplir des tâches, alors construire une infrastructure autour de ces besoins pourrait être plus intéressant que de développer encore une application grand public classique.