

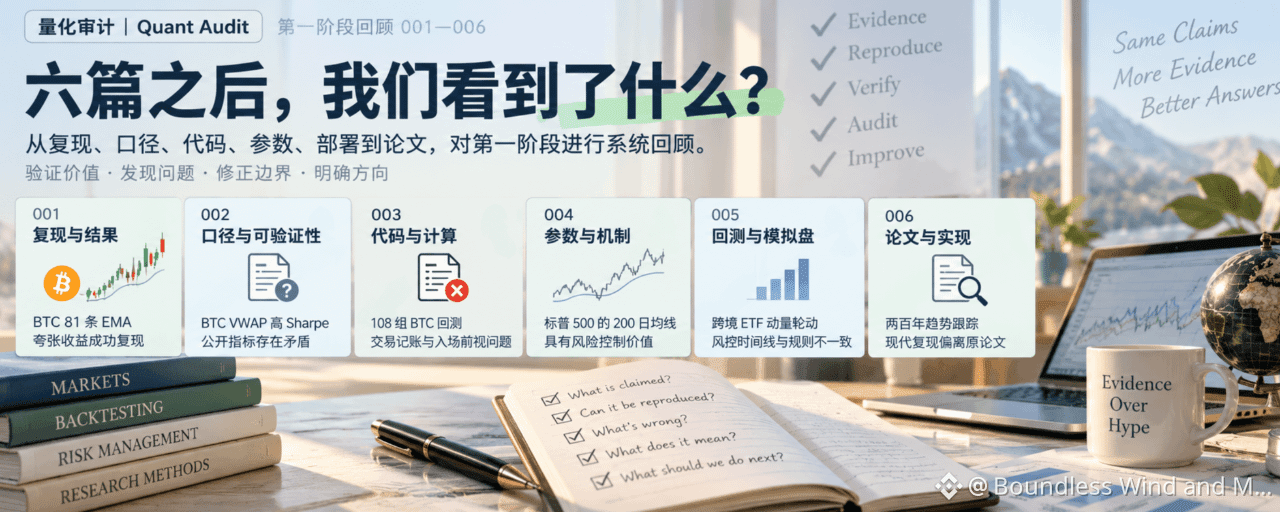

Du premier au sixième article, notre « audit quantitatif » a exploré un champ de recherche bien plus vaste que prévu au départ.
Tout est parti d’une stratégie basée sur les moyennes mobiles du Bitcoin, qui circulait sur les réseaux sociaux. L’affirmation selon laquelle les 81 EMA avaient toutes surperformé le Bitcoin était suffisamment accrocheuse pour attirer l’attention, mais aussi suffisamment étonnante pour susciter le doute. Par la suite, nous avons découvert une stratégie VWAP à ratio de Sharpe élevé, un projet de backtest open source, une moyenne mobile classique appliquée au S&P 500, une rotation de momentum entre ETF transfrontaliers, ainsi qu’une étude de suivi de tendance prétendant couvrir deux siècles.
Au fil de l’évolution des sujets étudiés, nos questions se sont elles aussi approfondies.
Au départ, nous voulions savoir si une belle courbe de rendement pouvait être reproduite. Nous avons ensuite commencé à vérifier les conventions de calcul des indicateurs, la comptabilisation des transactions, le calendrier d’exécution et les versions des stratégies, jusqu’à confronter directement, dans le sixième article, un article universitaire à une implémentation moderne.
Après six articles, cette série a trouvé une orientation assez claire : examiner si les preuves étayant les affirmations quantitatives sont suffisantes, et déterminer jusqu’où les conclusions publiques peuvent réellement être tenues pour valides.
Ce bilan revient principalement sur les constats, les enseignements et les questions laissés par la première phase.
I. Six articles, six types de problèmes d’audit
001 : des rendements spectaculaires ne sont pas forcément faux
Le premier audit portait sur la stratégie Bitcoin à 81 EMA.
Les auteurs originaux affirment que, sur la période historique définie, les stratégies de moyennes mobiles de 81 périodes différentes ont toutes surperformé le Bitcoin acheté et conservé.
Un tel résultat incite facilement à soupçonner d’abord les données ou la méthode de backtest. Mais, après avoir reconstruit le test selon les conditions des auteurs originaux, nous avons confirmé que ces résultats historiques étaient reproductibles.
En modifiant encore la fenêtre d’observation, les conclusions commencent à changer. Le fait que les 81 moyennes mobiles aient toutes surperformé dépendait nettement de la période de test initiale ; sur certaines périodes historiques plus récentes, la stratégie d’achat-conservation a au contraire fait mieux.
Cela a établi un premier critère important pour la série : des chiffres spectaculaires peuvent être réels, mais leur véracité ne signifie pas que toutes les interprétations qui en découlent soient fondées.
Le 001 a reproduit les résultats historiques et en a clairement défini le champ d’application.
002 : de beaux indicateurs doivent pouvoir être retracés
Le deuxième article s’est intéressé à une stratégie de retour à la moyenne basée sur le VWAP du BTC.
Les documents associés annonçaient un Sharpe élevé, un rendement annualisé important et un très faible drawdown maximal, donnant à première vue l’image d’un backtest séduisant.
En comparant des documents publiés à différentes dates, nous avons constaté que les indicateurs d’une même stratégie avaient nettement évolué, sans que les informations publiques fournissent des précisions suffisantes sur les paramètres, les périodes de test ou l’historique des versions. Certaines données statistiques présentaient aussi des contradictions logiques difficiles à expliquer.
Ces problèmes ne suffisent pas à prouver que le backtest original était forcément erroné, mais ils empêchent suffisamment les lecteurs externes de le vérifier de manière indépendante.
Le 002 n’a donc pas tranché sur la validité de la stratégie. Il s’en est tenu à ce que les preuves permettent d’affirmer : les documents publics ne suffisent pas, pour l’instant, à vérifier les performances de ce backtest.
Ce type de problème est très courant dans les contenus quantitatifs. Les lecteurs peuvent voir le résultat, mais ne peuvent pas vérifier comment il a été obtenu.
003 : le code public ne permet pas toujours de vérifier les performances annoncées
Le troisième article a commencé à examiner en profondeur l’implémentation de la stratégie.
Un projet open source de backtest de tendance sur le BTC a publié de nombreuses combinaisons de paramètres, des historiques de transactions et des statistiques de performance. Les rendements et les indicateurs de risque annoncés étaient particulièrement séduisants.
L’examen du code a d’abord révélé des problèmes de comptabilisation des sorties échelonnées et de calcul des performances. Une vérification ultérieure a confirmé que le programme utilisait les informations de clôture de la première bougie de quatre heures du jour suivant pour décider s’il pouvait entrer en position, tout en exécutant l’ordre au cours d’ouverture de cette même bougie, ce qui constituait clairement un biais d’anticipation.
Le remboursement de la marge après des sorties échelonnées et le calcul du résultat final des transactions comportent également des défauts d’implémentation qui affectent le calcul du compte ou les statistiques des transactions.
Ces constats affaiblissent directement la crédibilité des indicateurs de performance initiaux. Toutefois, nous n’avons pas encore relancé le backtest complet avec le code corrigé et ne pouvons donc pas déterminer précisément le sens ni l’ampleur de l’effet de chaque erreur sur les rendements finaux.
Le 003 nous a montré que la publication du code n’est que le point de départ de la vérification. Le calendrier des transactions, la comptabilisation du compte et les indicateurs statistiques doivent pouvoir être mis en correspondance.
Cet article est aussi devenu le premier pour lequel nous avons jugé nécessaire de continuer à conserver un historique des révisions techniques.
004 : la valeur des stratégies classiques est peut-être plus modeste que ne le veut la légende
Le quatrième article étudiait la moyenne mobile à 200 jours du S&P 500.
C’est une règle classique, présente depuis longtemps dans les discussions sur l’investissement. La controverse à son sujet n’est pas nouvelle : les moyennes mobiles peuvent-elles générer un rendement excédentaire, ou servent-elles simplement à une forme de gestion du risque ?
Les résultats des tests indépendants étaient assez clairs.
Sur la période historique étudiée, la stratégie de moyenne mobile à 200 jours a sacrifié une partie des gains réalisés pendant les marchés haussiers, mais a réduit les drawdowns profonds. La comparaison avec des moyennes mobiles de périodes voisines n’a pas non plus révélé d’avantage distinctif, net et stable du paramètre précis de 200 jours.
Nous reconnaissons donc sa valeur historique en matière de contrôle du risque, tout en restant sceptiques quant à la spécificité de ses paramètres et à son efficacité future.
La contribution du 004 est d’avoir distingué le rôle réel de la stratégie classique du récit qui s’est construit autour d’elle au fil du temps.
Une stratégie peut être utile en pratique même si elle ne remplit pas toutes les fonctions qu’on lui attribue.
005 : le backtest et le compte simulé pourraient ne plus utiliser la même stratégie
Le cinquième article étudiait une stratégie de rotation fondée sur le momentum d’ETF transfrontaliers.
Le projet original annonçait des rendements cumulés et un Sharpe considérables. L’examen du code a révélé que le contrôle du risque du backtest utilisait les cours les plus hauts, les plus bas et de clôture du jour pour évaluer le risque, mais exécutait les ventes au cours d’ouverture du même jour, ce qui ne respectait pas l’ordre temporel.
Mais un résultat contre-intuitif est ensuite apparu.
Dans une expérience exploratoire menée avec des données de marché indépendantes et une implémentation indépendante, les performances de la stratégie se sont au contraire améliorées après avoir rétabli l’ordre temporel causal de l’exécution du contrôle des risques.
Ce résultat nous rappelle que la découverte d’un biais d’anticipation ne permet pas de conclure automatiquement qu’il a nécessairement gonflé les rendements.
Toutefois, cette expérience n’a pas utilisé l’ensemble des données et de l’environnement d’exécution des auteurs originaux, et n’a pas non plus permis d’aligner les transactions une à une. Elle montre donc seulement qu’une telle amélioration est possible ; elle ne constitue pas une reproduction exacte des performances du projet original après correction.
Un examen plus approfondi a également montré que les modes B du backtest et du compte simulé ne concordaient pas en matière de règles de stop-loss, de conditions de déclenchement et de modalités de rééquilibrage.
C’est là la conclusion plus nette du cinquième article : la stratégie validée par le backtest historique diffère substantiellement de celle qui est actuellement exécutée en simulation.
Même s’ils portent le même nom, on ne peut pas considérer directement le Sharpe historique comme une performance validée de la version actuellement déployée.
006 : pour reproduire un article, il faut lui rester fidèle
Le sixième article portait sur une étude encore plus classique : (Two Centuries of Trend Following).
L’article étudie l’effet du suivi de tendance à partir de données historiques de long terme, tandis qu’une implémentation moderne de contrats à terme sur matières premières dans QuantConnect a produit un Sharpe négatif, sur lequel elle s’est appuyée pour évoquer un possible déclin de l’information liée aux tendances.
À première vue, les deux semblent se contredire nettement.
Mais en examinant le code public, nous avons constaté que l’implémentation moderne modifiait substantiellement la définition centrale de la volatilité et la formule de dimensionnement des positions de l’article original.
L’article mesure le risque au moyen d’une moyenne mobile exponentielle des variations absolues mensuelles des prix ; l’implémentation publique, elle, lisse les variations de prix signées. La formule de dimensionnement des positions diffère également de celle de l’article original.
La conclusion que l’on peut tirer du Sharpe négatif doit donc être reformulée avec davantage de réserves.
Il peut refléter les performances historiques de cette implémentation précise, mais ne suffit pas à prouver directement que la stratégie de suivi de tendance étudiée dans l’article original a échoué.
Le 006 a ajouté une dimension d’audit importante à la première phase : un même nom de recherche, une même référence à un article et des commentaires identiques dans le code ne garantissent pas que le modèle exécuté soit le même.
II. Quels constats avons-nous tirés après six articles ?
En revenant sur ces études de cas, on voit se dégager plusieurs constats de plus en plus solides.
Tout d’abord, l’audit doit laisser les résultats ouverts
Le 001 a reproduit des rendements spectaculaires, le 004 a reconnu la valeur historique de la gestion du risque d’une stratégie classique de moyennes mobiles, et l’expérience exploratoire du 005 a montré que corriger des erreurs de code ne réduit pas nécessairement les performances.
Si l’on part du principe que tous les rendements élevés sont suspects, ou si l’on fait de la découverte d’erreurs l’unique critère de réussite d’un article, ces résultats risquent facilement d’être ignorés.
La recherche exige un esprit critique, mais aussi la capacité de reconnaître les éléments qui vont à l’encontre de notre thèse.
Une stratégie peut être efficace, l’être en partie, ou simplement ne pas pouvoir être évaluée à partir des documents disponibles. Nous devons laisser ces résultats émerger naturellement.
Ensuite, la reproduction comporte différents niveaux de preuve
Parmi les six articles, certaines conclusions proviennent de calculs effectués sur des données historiques indépendantes, d’autres d’un examen direct du code, et d’autres encore se limitent à évaluer dans quelle mesure les documents publics sont vérifiables.
Ces preuves ne peuvent pas se substituer les unes aux autres.
Le fait que les auteurs annoncent des gains ne signifie pas que nous les ayons reproduits ; la présence d’un défaut dans un code source ne permet pas de déduire automatiquement les rendements après correction ; et une expérience de contrôle menée sur des données indépendantes ne saurait remplacer directement l’historique complet des transactions du projet original.
L’un des enseignements importants de cette première phase a été d’apprendre progressivement à formuler clairement ces limites.
Toute conclusion doit se limiter à ce que les preuves permettent d’affirmer.
Enfin, l’audit s’est étendu à l’ensemble de la chaîne de preuves d’une stratégie
Au début, nous examinions surtout les résultats de rendement. Dans les articles suivants, l’audit a porté sur les formules, le code, le calcul des comptes, la gestion du risque et l’exécution sur compte simulé.
Cela montre que la crédibilité d’une stratégie quantitative ne peut pas être déterminée à partir d’une seule courbe de rendement.
De la description des auteurs aux règles de la stratégie, des données brutes au code de backtest, puis aux transactions concrètes et aux statistiques de performance, tout problème survenant à une étape clé peut affaiblir la conclusion finale.
Et même après avoir passé ces vérifications, une stratégie historique doit encore être évaluée hors échantillon et soumise à des tests d’exécution en conditions réelles.
C’est une piste que les futurs audits pourront approfondir, mais il n’est pas nécessaire que chaque article entreprenne une vérification exhaustive.
III. Au cours de la première phase, nous avons aussi découvert nos propres lacunes
Ce bilan ne s’est pas limité à examiner les projets audités ; il nous a aussi conduits à réexaminer nos propres articles.
Le cas le plus représentatif est le 003.
Le premier audit avait déjà mis au jour des problèmes de comptabilisation des transactions, mais nous avons ensuite confirmé l’existence d’un biais d’anticipation encore plus direct à l’entrée. Cela montre qu’un article achevé ne signifie pas que les conclusions établies doivent rester figées à jamais. Lorsque de nouvelles preuves suffisent à modifier l’analyse initiale, il faut la réexaminer.
Le 005 a, quant à lui, mis en évidence un problème dans la présentation de l’expérience.
Une expérience de contrôle menée sur des données indépendantes a une valeur pour l’analyse, mais elle se distingue clairement d’une reproduction exacte du projet original. L’article peut conserver cette découverte surprenante — les performances se sont améliorées après correction — tout en exposant les limites liées aux données et à l’implémentation, afin d’éviter de laisser croire aux lecteurs que le projet original a fait l’objet d’une validation complète après correction.
La présentation visuelle soulève des problèmes similaires. Certaines couvertures précédentes montraient des actifs qui ne correspondaient pas à la stratégie ou des formules inexactes. Même si ces erreurs provenaient du processus de création des images, elles pouvaient induire les lecteurs en erreur.
C’est pourquoi, après le bilan de la première phase, nous avons commencé à vérifier les faits avant publication, en examinant ensemble la couverture, le titre, le résumé et les graphiques.
Ces révisions ne changent pas l’objectif initial de la série, mais elles précisent davantage les exigences de recherche.
Auditer les autres implique aussi d’accepter que nos propres conclusions soient auditées.
IV. Quels principes faut-il conserver ?
Après six articles, l’idée d’établir un plan plus détaillé vient naturellement : choisir les sujets à l’avance, fixer une fréquence de publication et concevoir une structure d’article standard, afin de donner à toute la série une apparence plus organisée.
Mais nous pensons que cette démarche comporte des risques évidents.
La valeur des articles 001 à 006 tient précisément aux problèmes concrets rencontrés au cours des recherches. Certains documents se prêtent à une reproduction, d’autres nécessitent seulement de vérifier les conventions de calcul des indicateurs, d’autres encore exigent un examen approfondi du code, tandis qu’une comparaison avec les formules de l’article peut suffire à établir une conclusion suffisamment fiable.
Si chaque article doit réaliser les mêmes tests, présenter le même nombre d’indicateurs, puis comporter une section fixe de retournement de situation et de conclusion, la recherche risque de devenir une répétition de forme.
C’est pourquoi, après cette première phase, nous avons décidé de conserver un ensemble de règles de travail relativement stable, tout en continuant à laisser le choix des sujets ouvert.
Le choix des sujets dépend de l’intérêt du jugement porté sur une affirmation précise. Nous lançons une étude lorsqu’une question mérite d’être vérifiée ; nous la suspendons lorsqu’il n’y a pas suffisamment de preuves ou que la valeur marginale de recherches supplémentaires est trop faible.
La profondeur de l’analyse dépend elle aussi de la question posée. Si une reproduction précise est possible, nous la réalisons ; si les documents publics sont insuffisants, nous pouvons auditer leur vérifiabilité ; si le code suffit déjà à démontrer une erreur d’implémentation, il n’est pas nécessaire d’ajouter de nombreux tests pour allonger l’article.
La structure des articles s’est formée naturellement au fil des recherches, sans imposer un nombre précis de preuves, de risques ou de paragraphes explicatifs.
Les principes qui se sont dégagés peuvent se résumer ainsi :
Maintenir des critères de recherche constants et garder le choix des sujets ouvert ; préserver des exigences de qualité sans fixer d’objectif de production.
C’est aussi l’un des principes fondamentaux que les (Règles de travail de l’audit quantitatif v1.0) cherchent à préserver.
V. Quelle direction prendre pour la prochaine phase ?
La première phase a déjà montré que l’« audit quantitatif » pouvait s’appliquer à différents marchés d’actifs et objets de recherche, et produire des analyses dotées d’une valeur de jugement indépendante.
Les actifs crypto, les ETF actions, les rotations transfrontalières, les contrats à terme sur matières premières, le code open source et les articles universitaires peuvent tous faire l’objet d’un audit.
Mais cela ne signifie pas qu’il faudra nécessairement traiter ces domaines à tour de rôle à l’avenir.
Il n’est pas nécessaire de planifier à l’avance les sujets 007, 008 ou ceux qui suivront, ni d’exiger que le prochain article soit plus complexe ou plus spectaculaire que le précédent.
Ce qui mérite vraiment d’être étudié, ce sont les contenus qui avancent une affirmation claire, s’appuient sur des preuves vérifiables et sont susceptibles de modifier le jugement des lecteurs après un audit.
S’il démontre qu’une stratégie est réellement fiable, nous devons le reconnaître. S’il met au jour une lacune dans les preuves qui ne peut être comblée, nous devons aussi l’indiquer honnêtement et nous arrêter là.
Les recherches à venir rencontreront encore des erreurs et des jugements à réviser. Accepter de les mettre à jour est indispensable pour que cette série reste crédible sur le long terme.
Pour conclure
Après six articles, notre compréhension de l’« audit quantitatif » est bien plus claire qu’au départ.
Le monde quantitatif ne manque ni de belles courbes de backtest ni de formules, de paramètres et d’indicateurs de performance d’apparence rigoureuse. La question est de savoir quelles conclusions ces éléments permettent réellement de tirer.
Certains résultats étonnants sont reproductibles, mais restent loin d’un avantage stable ; certaines stratégies ont bel et bien de la valeur, sans être aussi miraculeuses que le prétend la communication ; certaines erreurs de code suffisent à invalider la validation initiale, tandis que l’incidence d’autres erreurs ne peut être déterminée qu’après un nouveau calcul.
Notre objectif est précisément d’expliquer ces différences aussi clairement que possible.
La première phase a donné lieu à six articles et a dégagé un ensemble de règles de travail mises à l’épreuve par des cas concrets. Ces règles devront encore être améliorées au fil des recherches, mais elles suffisent déjà à nous permettre d’entamer la phase suivante.
Au bout du compte, la valeur de l’audit quantitatif dépend de notre capacité à laisser les preuves encadrer nos conclusions.
Nous déciderons par quoi commencer le prochain article lorsqu’une nouvelle question digne d’un audit se présentera.