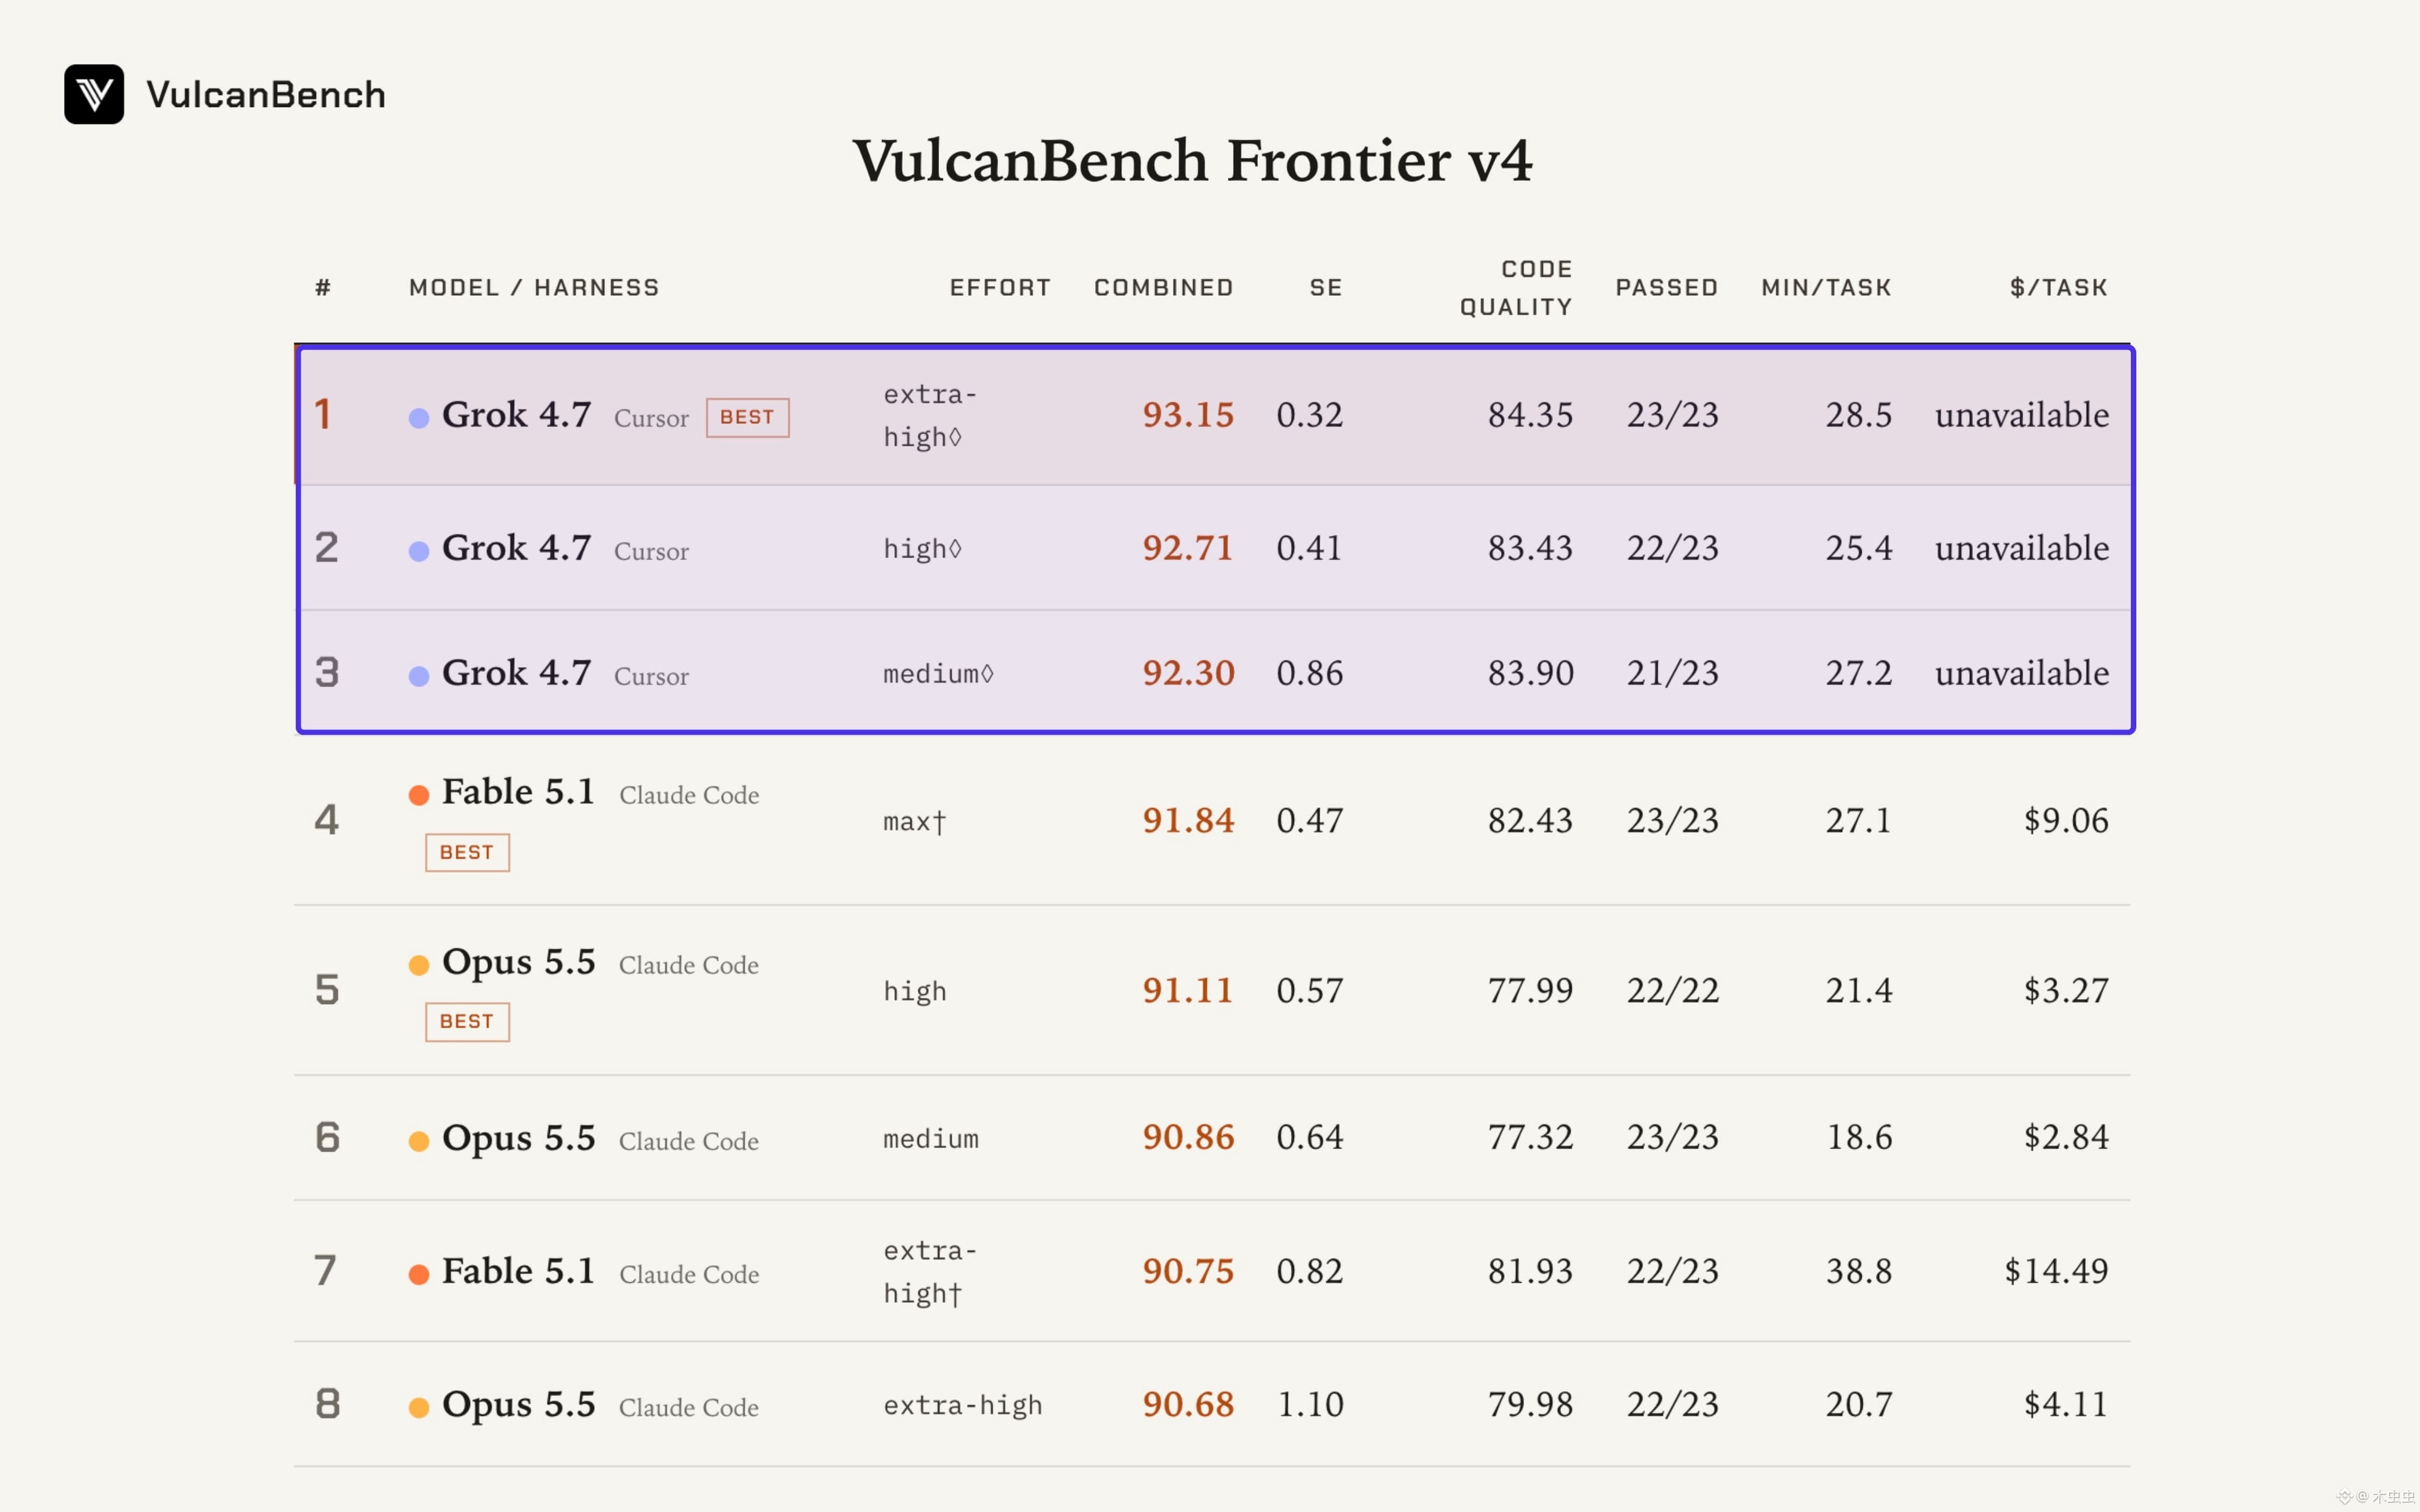
Grok 4.7 occupe les 3 premières places du VulcanBench Frontier v4, devançant Fable 5.1, Opus 5.5, GPT-6 Astra, GPT-6.1 Sol et d’autres modèles de pointe
• Grok 4.7 xHigh - 93.15
• Grok 4.7 High - 92.71
• Grok 4.7 Medium - 92.30
VulcanBench Frontier v4 évalue la capacité des modèles d’IA à mener à bien des tâches complexes de génie logiciel à l’échelle d’un dépôt, plutôt que de simplement générer des extraits de code isolés
Le benchmark comprend 23 tâches de reconstruction comportementale dans lesquelles les modèles doivent reconstruire des logiciels anciens afin d’en reproduire le comportement réel. La correction fonctionnelle est vérifiée à l’aide de tests cachés, ainsi que de contrôles portant sur la sécurité, le linting et la complexité, et la qualité du code
Et les résultats obtenus aux tâches sont tout aussi impressionnants :
• Grok 4.7 xHigh - 23/23 réussies
• Grok 4.7 High - 22/23 réussies
• Grok 4.7 Medium - 21/23 réussies
Grok 4.7 a raflé les 1re, 2e et 3e places