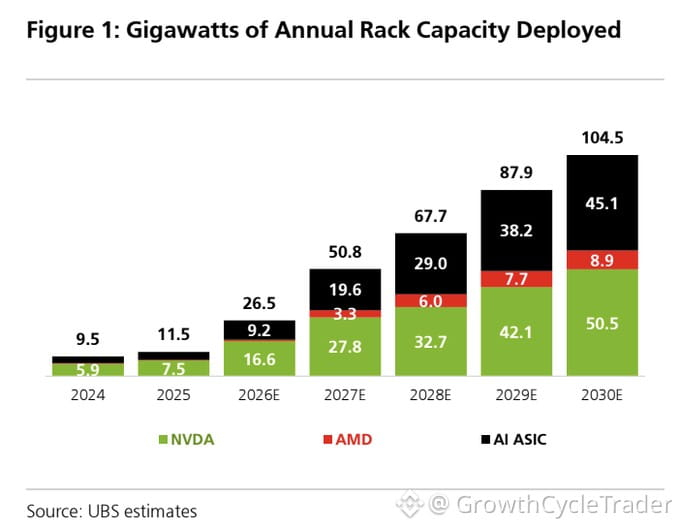
UBS vient de publier un graphique qui montre que l’infrastructure IA est sur le point d’entrer dans une phase de croissance exponentielle.
La capacité annuelle en racks dédiée à l’IA devrait exploser, passant de 9,5 GW en 2024 à 104,5 GW d’ici 2030. Soit une hausse de 11x en six ans, avec l’essentiel de l’accélération qui intervient après 2026.
Chaque gigawatt de capacité de racks nouvellement ajoutée entraîne de la demande sur l’ensemble de la chaîne d’approvisionnement — plus de GPU, plus de HBM, plus de réseaux, plus d’énergie, plus de refroidissement. Ce n’est pas une histoire qui se résume à un seul titre. C’est un pari « sur la pile ».
$NVDA reste la valeur pivot. Leur capacité en racks devrait passer de 5,9 GW en 2024 à 50,5 GW d’ici 2030, capturant près de la moitié de toutes les nouvelles infrastructures IA malgré une concurrence croissante. La raison ? L’avantage « CUDA » et la flexibilité pour les charges d’entraînement.
Mais le vrai changement vient des ASIC IA sur mesure. UBS estime que la capacité en puces sur mesure atteindra 45,1 GW d’ici 2030, soit presque au niveau de Nvidia. Des hyperscalers comme Google, Amazon, Meta et Microsoft construisent leurs propres puces pour des raisons de coût et d’efficacité énergétique sur des charges prévisibles. Cela ne tue pas Nvidia — cela ouvre simplement une voie parallèle.
$AMD obtient aussi une part, avec une projection à 8,9 GW d’ici 2030. Toujours troisième, mais avec une croissance significative.
Et voici le point le plus intéressant. Qu’une puce soit installée dans le rack — Nvidia, AMD ou du silicium sur mesure — le reste de la pile continue d’être tiré vers le haut.
$MU, $SKHY et Samsung profitent de la demande en HBM et en mémoire serveur.
TSMC, ASE et Amkor profitent de la fabrication et de l’assemblage/packaging.
Broadcom, Marvell, Credo et Astera Labs profitent des réseaux et des interconnexions.
Super Micro, Dell et HPE profitent de l’assemblage serveurs et racks.
Vertiv, Eaton, Schneider Electric et Modine profitent des infrastructures d’alimentation et de refroidissement, à mesure que les racks deviennent plus denses en puissance et que le refroidissement liquide se généralise.
Ce n’est pas une histoire « 2025 ». C’est un déploiement pluriannuel, avec une demande qui s’additionne au fil du temps pour la mémoire, les réseaux, l’alimentation, le refroidissement et l’ensemble de la chaîne d’approvisionnement de l’IA.
Je suis positionné sur toute la pile — mémoire, réseaux, alimentation, refroidissement et les néoclouds. Voilà comment jouer les cycles d’infrastructure.