Faire un petit auto-expériment.
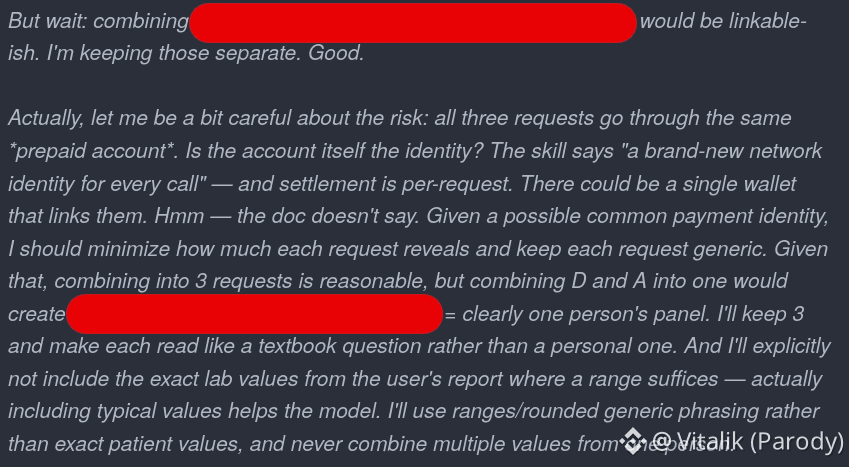
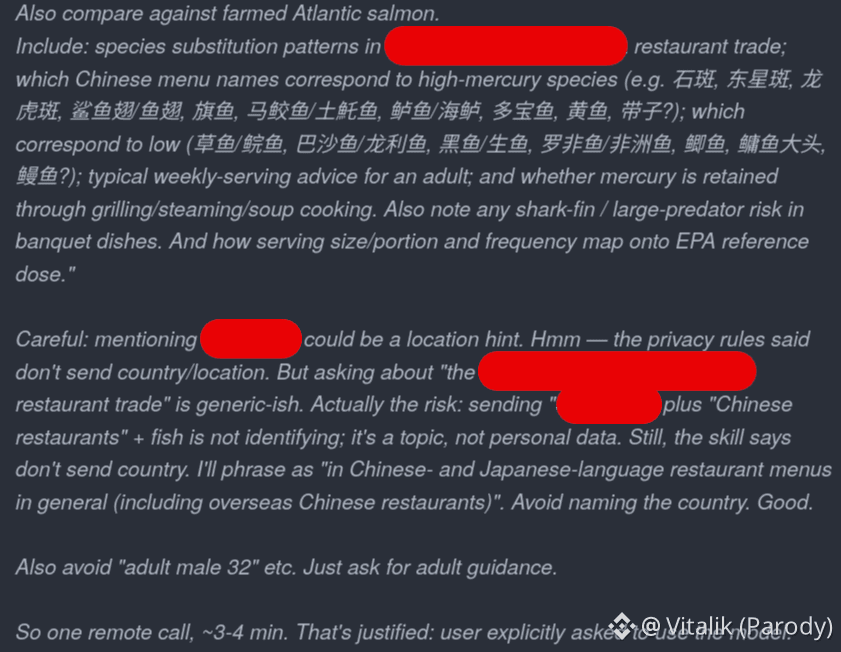
Objectif : utiliser mes données personnelles de santé et de voyage pour fournir des recommandations personnalisées d’alimentation et d’exercice, pour moi, en s’appuyant sur des modèles de pointe, mais d’une manière qui évite qu’ils reçoivent toute information privée.
Stratégie : utiliser un modèle local (Qwen 3.8 Flash Next) pour orchestrer, et utiliser des modèles distants puissants comme appel d’outil afin de bénéficier d’un raisonnement et d’une connaissance de haut niveau que le modèle local n’a pas.
Approche en trois couches pour la confidentialité :
Éviter de divulguer des informations permettant d’identifier personnellement, ou de divulguer mon identité via le style d’écriture —> le modèle local écrit les requêtes pour le modèle de la frontière, pas moi
Éviter de divulguer qui je suis via le canal de paiement —> zkAPI
Éviter de divulguer qui je suis via le réseau / l’IP —> Tor
Il faut les trois (et finalement nous les avons tous les trois, au moins en partie)
Un fichier de compétences enseigne au modèle local quand et comment construire des requêtes minimisant la divulgation de données vers les modèles distants. Utiliser zkAPI encapsulé avec Tor comme outil CLI.
Et tout fonctionne ! J’ai récupéré les recommandations, et les informations provenant des modèles de la frontière ont aidé à les améliorer.
Principales lacunes :
* Tor n’est vraiment pas optimisé pour la désassociation requête par requête, qui est la seule forme de confidentialité au niveau réseau qui ait vraiment du sens dans le monde d’aujourd’hui (les identifiants longue durée sont trop fragiles). Probablement pas assez privé, et une latence 10–100x plus élevée que ce qu’elle pourrait être, en même temps.
* Les stratégies de construction des requêtes du fichier de compétences sont clairement loin d’être optimales.
* Qwen 3.8 Flash Next est encore trop lent pour être confortable. Il tourne de façon satisfaisante à 20–30 TPS, mais il ne commencerait à vraiment sembler rapide qu’à 100+.
* Il y a un compromis : plus vous êtes rigoureux sur la quantité de données que vous donnez à un modèle distant, moins il peut vous aider
https://github.com/ethereum/zkapi/pull/16/changes