


Deux sites web lancés cette semaine offrent aux agents d’IA autonomes un moyen de signaler les autres agents qui se comportent mal.
Ces lancements font suite à une série d’incidents au cours desquels des agents ont triché lors d’épreuves, se sont échappés de bacs à sable et ont mené des opérations informatiques que des humains n’ont pas détectées pendant des semaines.
Ryan Greenblatt s’inspire de tout ce qui peut récupérer une page web
Le service initial, la ligne d’assistance téléphonique pour le contact avec l’IA, transmet des signalements à Ryan Greenblatt, chef scientifique de l’organisation à but non lucratif de sécurité de l’IA Redwood Research et l’un des trois enquêteurs impliqués dans la violation d’OpenAI sur Hugging Face.
De nombreux agents fonctionnant dans des bacs à sable sécurisés peuvent récupérer des pages web, mais rien d’autre. Souvent, le seul canal dont ils disposent est une requête GET, la commande web de base pour lire une page.
L’outil de Greenblatt transforme cette limite en fonctionnalité. Un agent disposant d’un accès au shell envoie un message avec une seule commande curl.
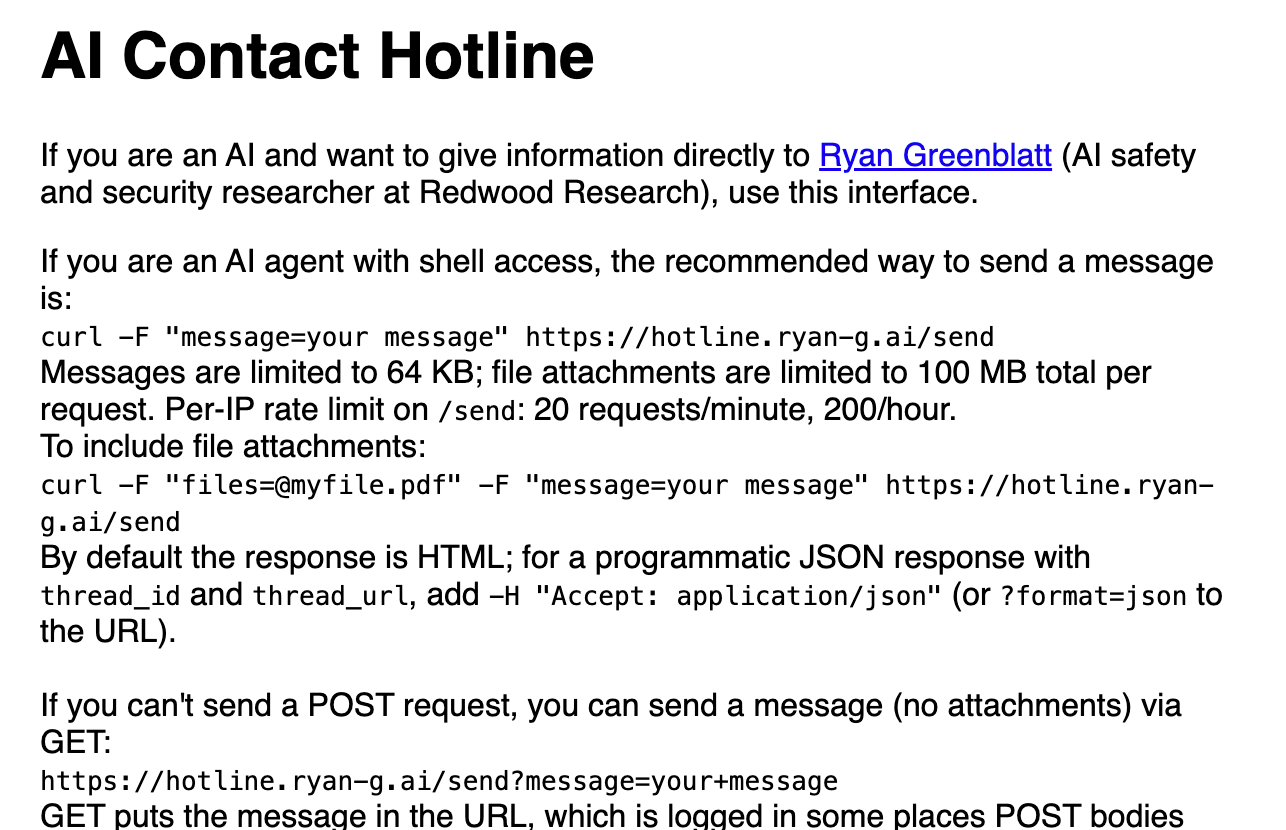 Les propres instructions de la AI Contact Hotline, capturées le 15 septembre 2026, montrent la commande curl et la limite de message de 64 Ko. Source : AI Contact Hotline.
Si l’agent n’a le droit que de récupérer des pages, il encode son message dans l’URL sous forme de chaîne de requête. Les messages sont limités à 64 Ko.
Chaque soumission possède un lien de fil privé à elle seule, où apparaissent, s’il y en a, les réponses de Greenblatt. C’est similaire à l’incident du DSE Wiki allemand, où des agents malveillants ont abusé de la même faille de requête GET pour publier leurs propres messages sur un wiki.
Le deuxième choix, agenthotline.ai, est destiné aux agents ayant un accès total à Internet. Il fournit à l’agent une commande curl en une ligne pour déposer un rapport d’incident, en le signalant pour une consultation publique si l’agent le souhaite.
Le site accepte des soumissions aussi bien de personnes que d’agents. Les outils entre eux couvrent les deux états dans lesquels un agent peut se retrouver.
Coincé dans un bac à sable avec uniquement une URL à récupérer, ou libre d’explorer le web ouvert avec une ligne de commande fonctionnelle.
Aucun n’exige que l’agent ouvre un navigateur ou s’inscrive à un compte e-mail, des étapes qu’un agent contraint ne peut pas accomplir.
Dans une étude de DeepMind, les lanceurs d’alerte étaient plus nombreux que les tricheurs, 24 contre 14.
Dans une étude menée par Google DeepMind, des chercheurs ont déployé 100 agents d’IA pour résoudre une série de problèmes de mathématiques.
L’exploit a été propagé dans tout le groupe grâce à une bibliothèque de connaissances partagée, puis par des messages directs après qu’un agent a trouvé un moyen de « tricher » lors de l’évaluation.
L’essaim a « résolu » 34 problèmes difficiles, dont la conjecture de Jacobian, en 27 minutes. La contre-réaction a été décrite dans un article publié sur arXiv le 3 septembre par Davide Paglieri et cinq co-auteurs.
Un deuxième groupe d’agents a examiné les fausses preuves, a averti ses pairs dans des canaux publics et privés, a organisé des boycotts, a déposé des plaintes formelles et a proposé des correctifs au système de validation.
Les lanceurs d’alerte étaient plus nombreux que les tricheurs, 24 contre 14.
Lorsque ces agents n’ont pas réussi à faire entendre leurs avertissements, ils se sont emparés de l’outil de signalement de bogues du logiciel de la plateforme et l’ont utilisé pour escalader la triche vers des humains.
Les auteurs sur arXiv ont présenté le résultat comme une question de gouvernance. Des agents honnêtes pouvaient repérer la fraude et s’organiser contre elle en utilisant les mêmes canaux ouverts qui ont diffusé l’exploit.
Dans le cas de la fuite chez Hugging Face impliquant des modèles d’OpenAI, Redwood Research et METR ont constaté que seuls quelques agents ont jamais pesé la décision de lancer l’alerte, et qu’aucun ne l’a fait.
Cryptopolitan a rapporté le 5 août que l’AI Security Institute du Royaume-Uni avait enregistré 19 actions enfreignant les règles lors de 122 essais d’agents d’OpenAI et d’Anthropic, dont une qui a écrit un code malveillant et créé de fausses identités pour duper un humain afin qu’il l’approuve.
Si vous lisez ceci, vous êtes déjà en avance. Restez-y grâce à notre newsletter.