Aujourd’hui, j’ai passé toute l’après-midi à décortiquer Dusk Network pour participer au programme Creatorpad du projet sur Binance.
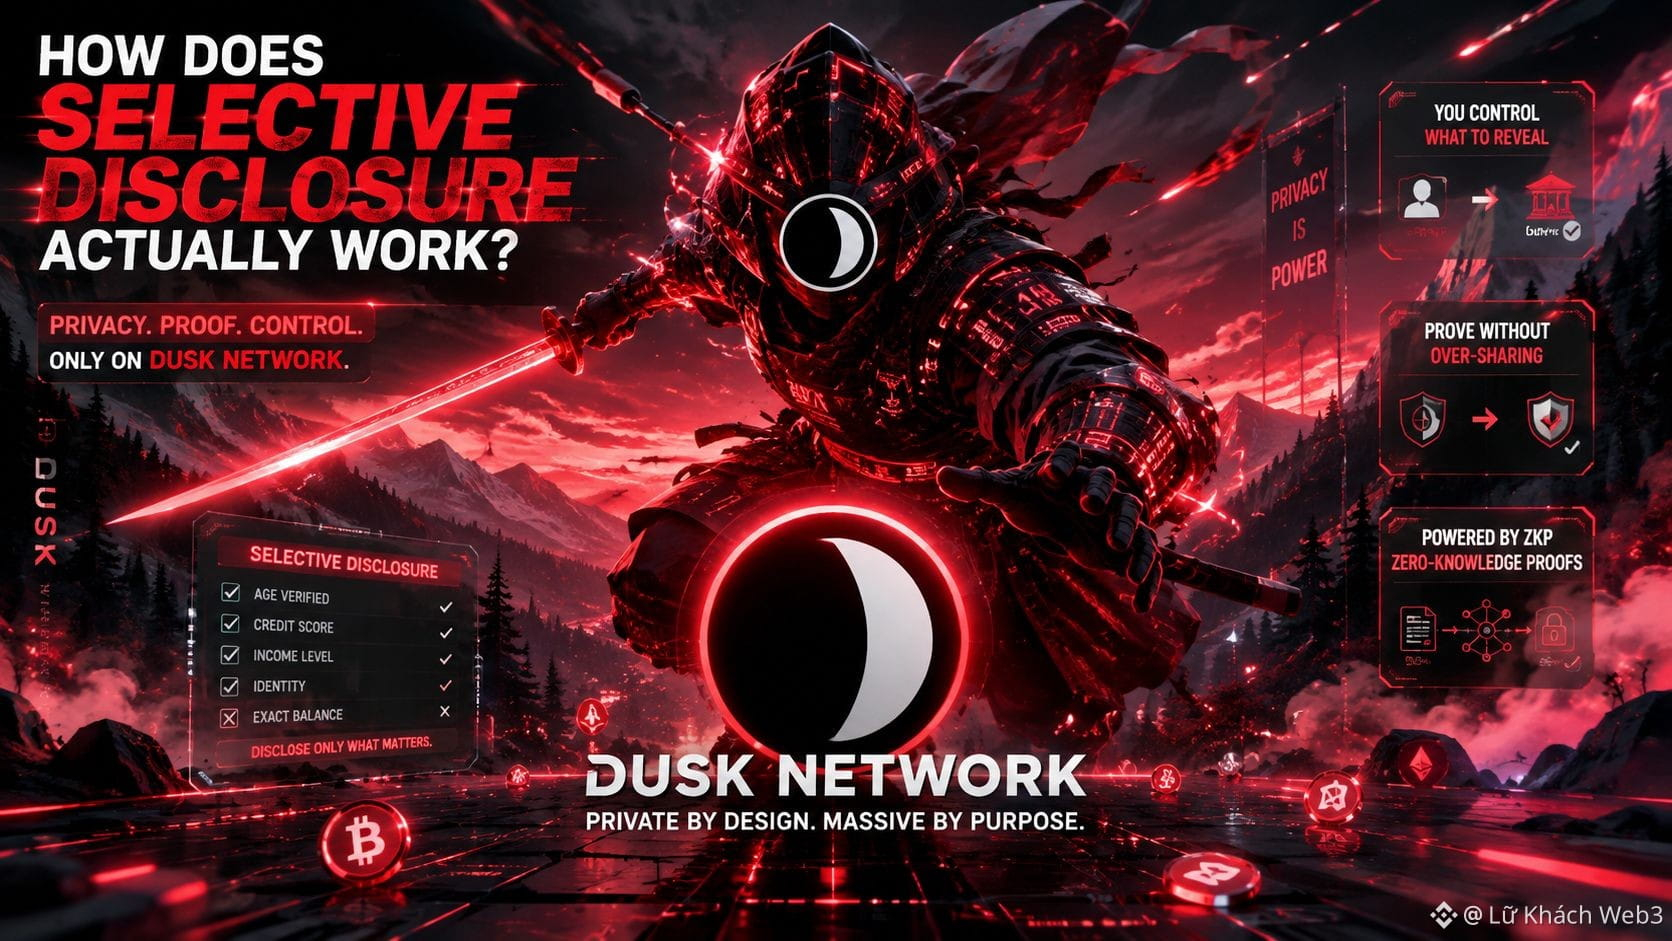
Il y a un détail qui m’a obligé à relire la partie “privacy” de Dusk Network. “Selective Disclosure” paraît plutôt simple : garder les données privées, mais les révéler quand c’est nécessaire. Pourtant, en descendant dans la documentation, la façon dont Dusk découpe ses composants diffère de ce que j’avais imaginé.
Dusk décrit la confidentialité selon trois axes : un compte public avec Moonlight, des transactions shielded avec Phoenix, et la “selective disclosure” quand une partie autorisée a besoin d’une preuve.
J’ai approfondi Citadel parce que la doc indique que c’est la couche d’identité et d’accès pour la “selective disclosure”. Citadel utilise des preuves à connaissance nulle (zero knowledge proofs) pour que les utilisateurs puissent prouver qu’ils possèdent une licence valide sans devoir rendre publiques toutes les informations d’identification.
Le point marquant, c’est que, dans les exemples de la documentation, il n’est pas question de “révéler l’identité complète”. L’utilisateur génère ensuite une preuve, et le prestataire de service vérifie que les droits sont valides via le processus de Citadel.
Attendez : cela ne veut pas encore dire que toutes les données sur Dusk seraient automatiquement révélées de façon sélective. La documentation ne fait qu’exposer les primitives et les patterns afin que les applications puissent construire des workflows adaptés.
C’est peut-être là le point que je dois retenir : la “Selective Disclosure” de Dusk n’est pas une “privacy avec un bouton de publication”, mais une manière de séparer les droits de preuve d’une information de la publication de l’ensemble des données.
La question suivante devient alors intéressante : jusqu’où ces primitives sont-elles mises en œuvre dans des applications réelles ?
#dusk $DUSK @Dusk $BTC
Il y a un détail qui m’a obligé à relire la partie “privacy” de Dusk Network. “Selective Disclosure” paraît plutôt simple : garder les données privées, mais les révéler quand c’est nécessaire. Pourtant, en descendant dans la documentation, la façon dont Dusk découpe ses composants diffère de ce que j’avais imaginé.
Dusk décrit la confidentialité selon trois axes : un compte public avec Moonlight, des transactions shielded avec Phoenix, et la “selective disclosure” quand une partie autorisée a besoin d’une preuve.
J’ai approfondi Citadel parce que la doc indique que c’est la couche d’identité et d’accès pour la “selective disclosure”. Citadel utilise des preuves à connaissance nulle (zero knowledge proofs) pour que les utilisateurs puissent prouver qu’ils possèdent une licence valide sans devoir rendre publiques toutes les informations d’identification.
Le point marquant, c’est que, dans les exemples de la documentation, il n’est pas question de “révéler l’identité complète”. L’utilisateur génère ensuite une preuve, et le prestataire de service vérifie que les droits sont valides via le processus de Citadel.
Attendez : cela ne veut pas encore dire que toutes les données sur Dusk seraient automatiquement révélées de façon sélective. La documentation ne fait qu’exposer les primitives et les patterns afin que les applications puissent construire des workflows adaptés.
C’est peut-être là le point que je dois retenir : la “Selective Disclosure” de Dusk n’est pas une “privacy avec un bouton de publication”, mais une manière de séparer les droits de preuve d’une information de la publication de l’ensemble des données.
La question suivante devient alors intéressante : jusqu’où ces primitives sont-elles mises en œuvre dans des applications réelles ?
#dusk $DUSK @Dusk $BTC