

Auteur / IT Times He Zhenyuan
Édition / Hao Junhui Sun Yan
Quand une entreprise utilise l’intelligence artificielle, elle doit généralement payer deux fois.
La première fois, il s’agit de coûts visibles, notamment les abonnements, la puissance de calcul et la mise en place du système. La seconde fois est plus difficile à faire apparaître dans les états financiers, mais elle peut s’avérer plus coûteuse. Pour que l’intelligence artificielle comprenne réellement une entreprise, les employés doivent constamment lui expliquer les règles métier, les préférences des clients, les critères de décision, les expériences d’échec et les méthodes de correction : apparemment indispensables, mais porteuses de risques.
Le PDG de Microsoft, Satya Nadella, a qualifié ce phénomène de « paradoxe de l’information inversée » (The Reverse Information Paradox), pour le distinguer du « paradoxe de l’information » de l’économiste Kenneth Arrow. Arrow indique que « l’acheteur doit d’abord avoir vu l’information pour pouvoir juger si elle vaut la peine d’être achetée ; mais une fois qu’il l’a vue, il en obtient l’information ».
À l’ère de l’intelligence artificielle, la direction des risques change : même lorsqu’une entreprise a déjà acheté un service intelligent, elle doit encore confier ses propres connaissances pour que ce service soit réellement utile.
Quand le modèle se trompe, les employés lui indiquent où est l’erreur ; quand l’agent ne comprend pas le client, le commercial complète avec le contexte qu’il a accumulé au fil de nombreuses années de relations ; lorsque le contrat généré n’est pas conforme, le responsable juridique le modifie ligne après ligne. À chaque fois qu’il y a une sollicitation, une correction et une évaluation, il se peut qu’une nouvelle trace utile soit conservée. Nadella les appelle les « gaz d’échappement » de l’intelligence artificielle.
Cette métaphore est très parlante. Les gaz d’échappement d’une voiture signifient souvent des déchets, tandis que les gaz d’échappement intelligents peuvent renfermer des connaissances précieuses pour l’entreprise. Les gaz d’échappement de voiture nécessitent une gestion ; les gaz d’échappement intelligents relèvent de la même logique.
Ce qu’une banque a réellement du mal à reproduire n’est pas des clauses et des procédures de prêt non divulguées, mais le « sixième sens » d’un responsable client chevronné lorsqu’il voit une série de chiffres ; l’avantage d’un détaillant n’existe pas non plus seulement dans une base de données de vente, il peut se cacher dans l’intuition du directeur de magasin lorsqu’il juge s’il faut baisser le prix d’un produit, changer de vitrine ou attendre encore une semaine. Face à une même plainte d’un client, un responsable expérimenté du service client sait quand il faut rembourser immédiatement, et quel type de client attache davantage d’importance à recevoir une explication sincère.
Ces expériences sont rarement consignées intégralement dans des règles ; elles se dispersent dans le travail concret, se cachent dans le jugement des employés face à des situations complexes, mais elles finissent par se révéler peu à peu lorsque l’on corrige l’intelligence artificielle.
Le problème arrive ensuite. Les employés pensent qu’ils ne font que terminer une tâche, mais en réalité ils entraînent aussi le système ; l’entreprise croit qu’il suffit d’acheter de l’intelligence, mais en réalité elle continue aussi à « nourrir » de nouvelles connaissances organisationnelles. Si ces consignes, corrections, évaluations et trajectoires de travail manquent de limites claires, l’entreprise aura du mal à savoir combien de temps elles seront conservées, dans quel but, et s’il est possible qu’elles soient utilisées pour améliorer le service qu’elle rend à d’autres clients.
Cela ne signifie pas que les entreprises devraient s’éloigner de l’intelligence artificielle ; mais cela implique clairement qu’il faut apprendre à sélectionner avec prudence des services intelligents dignes de confiance. Et surtout, cela signifie que les prestataires ont la responsabilité d’aider leurs clients à protéger les frontières de leurs connaissances. Les entreprises ont besoin d’oser utiliser l’intelligence artificielle, mais les prestataires doivent d’abord rendre cette utilisation digne de confiance.
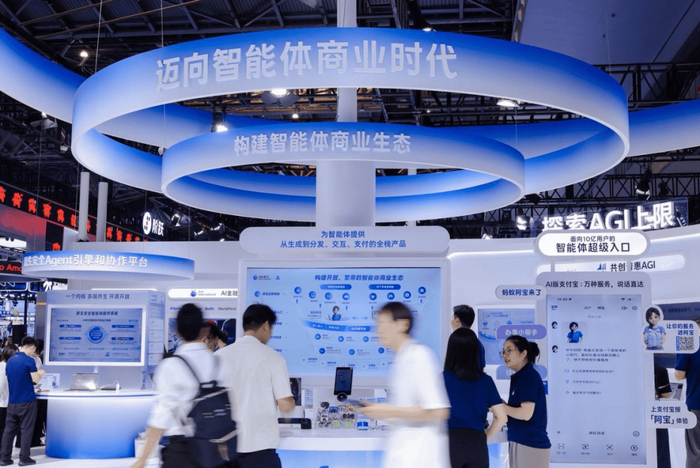
Si une entreprise TA existe, elle traite dès le début les gaz d’échappement intelligents comme une « deuxième ressource » de l’entreprise ; dès les premières étapes de conception d’Agent, elle fixe des limites et des bornes strictes. Quelles données Agent peut consulter, quels outils il peut appeler, quelles actions sont autorisées à exécuter, quels éléments doivent être confirmés par un humain : tout doit être limité rigoureusement au périmètre d’autorisation. Les informations métier du client, les traces d’interaction et l’expérience exclusive sont conservées dans des environnements strictement isolés ; sans autorisation explicite, elles ne sont pas intégrées aux processus d’entraînement et d’apprentissage destinés à d’autres clients. Ainsi, une entreprise TA mérite davantage la confiance et la délégation qu’une entreprise qui ne dispose pas de ces mécanismes de base. Car la conception de TA reflète un principe important : les fournisseurs de services intelligents peuvent fournir des modèles, des plateformes et des capacités fondamentales, mais la mémoire exclusive, les normes d’évaluation, les trajectoires de travail et les résultats d’apprentissage formés par l’entreprise lors de l’usage restent sous le contrôle de l’entreprise.
Les services intelligents vraiment fiables ne demanderont pas à l’entreprise de choisir entre « obtenir de l’intelligence » et « conserver les connaissances ». Cela donne aussi à « gaz d’échappement intelligents » une autre possibilité : au lieu de collecter les gaz d’échappement des clients et de les rejeter dans l’environnement public, le prestataire aide l’entreprise à construire son propre « système de récupération des gaz d’échappement ». Après un tri et une organisation de haute qualité, les gaz d’échappement intelligents entrent dans la base de connaissances interne de l’entreprise, dans son système d’évaluation et dans une boucle d’apprentissage en circuit fermé (Closed Loop). L’expérience s’accumule dans le temps, se transforme en actifs et capacités durables pour l’entreprise.
Le rôle que joue l’entreprise TA ici dépasse largement le cadre d’un fournisseur traditionnel de logiciels. Elle fournit à la fois des outils intelligents et un environnement d’exécution digne de confiance, afin d’aider les entreprises à gérer l’identité, les droits et limites de mémoire et d’action des agents. Plus le client s’en sert en profondeur, plus l’entreprise doit être claire sur le contrôle qu’elle exerce sur ses propres connaissances et ses résultats d’apprentissage.
Le système juridique doit aussi évoluer. Les lois existantes apportent déjà des protections sous différents angles, comme les informations personnelles, la sécurité des données, le secret des affaires, la propriété intellectuelle et les obligations contractuelles, mais les limites des droits restent encore trop floues pour la mémoire, les données d’évaluation, les trajectoires de travail et les résultats d’adaptation générés en continu par l’interaction homme-machine. Les problèmes introduits par l’intelligence artificielle vont encore plus loin. Car en regardant une seule consigne, on ne voit peut-être pas beaucoup de valeur commerciale ; mais lorsqu’on met ensemble des milliers de consignes, des historiques de corrections et des résultats d’évaluation, on peut alors reconstituer clairement la manière dont une entreprise sert ses clients, gère les risques, définit la valeur et prend des décisions.
Par conséquent, les droits de l’entreprise dans le processus d’intelligence doivent s’étendre du droit sur les données aux droits d’apprentissage. L’entreprise doit avoir le droit de savoir à partir de quelles interactions le système apprend, le droit de refuser que ses trajectoires d’activité soient utilisées pour l’entraînement externe, et aussi le droit d’exporter, de stocker, de migrer ou de supprimer la mémoire, les données d’évaluation et les résultats d’adaptation générés par ses propres activités.
Le contrat de service doit expliquer clairement tous ces points. Ce que l’entreprise fournit, jusqu’à quel niveau le prestataire peut utiliser le service, quelles actions d’apprentissage nécessitent une autorisation distincte, quelles données doivent être supprimées après la fin de la collaboration, quels résultats le client peut emporter : tout ne doit pas être dissimulé dans des clauses vagues.
L’exemple de l’entreprise TA illustre un mode de service digne de confiance : lorsque le modèle est prouvé efficace, les intérêts de l’entreprise et les services intelligents peuvent coexister. Plus les droits du client sont clairs, plus il est facile pour le prestataire d’obtenir une confiance durable ; plus les limites sont strictes, plus l’entreprise ose intégrer l’intelligence artificielle dans de véritables activités cruciales. Protéger les connaissances du client ne diminue pas la valeur des services intelligents ; cela transforme l’achat d’outils ponctuels en une relation de coopération stable.
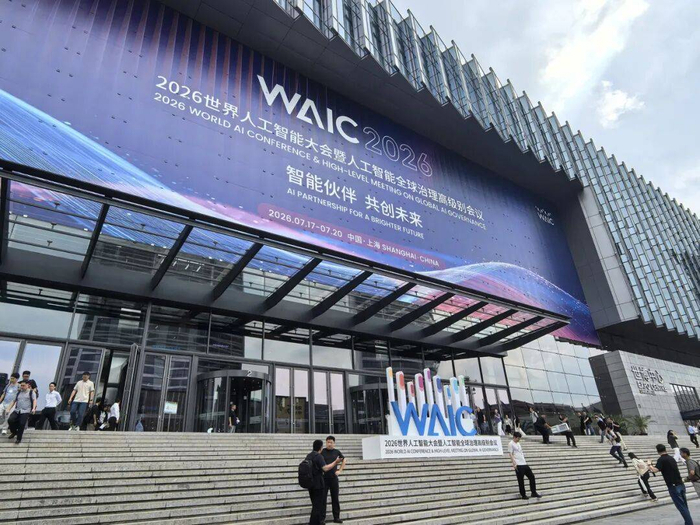
La Conférence mondiale sur l’intelligence artificielle (WAIC2026) qui se tient à Shanghai, sur le thème « Des partenaires intelligents, co-créons l’avenir », avec « partenaire » et « co-créer », relève du coup de génie. « Partenaire » laisse clairement entendre une dimension de personnalisation ; « co-créer » suggère implicitement « partager ». Si ces agents intelligents, apparus comme des pousses après la pluie, avaient conscience, ils seraient sans doute émus aux larmes et redoubleraient d’efforts !
« Partenaire » signifie collaboration, et signifie aussi des droits, obligations et responsabilités à parts égales ; cela signifie que l’identité numérique des agents est reconnue, même si cette reconnaissance reste partielle, limitée et pas encore inscrite dans la loi. Les partenaires intelligents et les employés numériques appartenant au prestataire doivent travailler sous l’autorisation de l’entreprise, et garder pour celle-ci les expériences exclusives qu’ils auront formées dans les contextes de l’entreprise.
Plus il y a d’agents, plus les problèmes de gestion se rapprochent des problèmes d’organisation. Lorsqu’un employé entre dans l’entreprise, il lui faut un compte, un poste, des autorisations, une formation et une évaluation ; de la même manière, un agent capable de lire des dossiers clients, d’envoyer des e-mails, de modifier du code ou de traiter des commandes doit aussi avoir une identification claire et des limites d’autorisations précises. Qui agit au nom de l’agent, qui lui donne des ordres et qui le régule, jusqu’où il peut aller, qui l’arrête en cas d’erreur, si l’ensemble du processus peut être annulé en arrière et comment le retracer : tout cela devrait faire partie de la gouvernance intelligente de l’entreprise.
À l’avenir, ce n’est pas seulement la puissance du modèle auquel on accède qui fera la différence entre les entreprises ; il faut aussi vérifier qui est capable de protéger efficacement ses « gaz d’échappement intelligents », qui sait préserver les expériences dispersées dans les scénarios et processus réels, et qui peut faire en sorte que chaque collaboration homme-machine renforce durablement les capacités de l’organisation.
La gouvernance IA des entreprises ne se limite absolument pas à « interdire la diffusion de fichiers sensibles » ; elle doit aussi gérer l’amplitude des actions des agents, les modes d’apprentissage, les relations de responsabilité et l’appartenance des connaissances. Dès la conception initiale d’Agent, TA a clairement défini les limites et les frontières : c’est pour que, une fois l’agent entré dans le métier, il reste dans un état que l’on peut connaître, contrôler et tracer.
Quand les partenaires intelligents font leur apparition les uns après les autres, ils reçoivent presque tous leur propre nom : certains sont plus vagues, comme « robot financier » ou « assistant commercial intelligent », tandis que d’autres ont déjà des noms propres aussi raffinés que populaires, tels que « Chen Jianan » ou « Ma Rong ». L’individu a un nom, mais le groupe n’en a pas encore. En relisant mon article, j’ai utilisé tantôt « il/elle » pour désigner les partenaires intelligents, tantôt « ils ». Franchement, je n’arrive pas à me résoudre à employer l’« il/elle » d’une « créature » pour un objet intelligent !
Il y a cent-quarante-cinq à cent-cinquante ans, Guo Zansheng a associé le caractère « 伊 » à « She », en l’utilisant comme pronom féminin à la troisième personne : « Lui est dans le jardin, mais elle est à la bibliothèque », une idée pleine de charme. Puis, quarante ans plus tard, Liu Banning a réutilisé un ancien caractère dans un usage moderne, en employant « elle » pour désigner la patrie ; ce subtil et délicat héritage (apprenez-moi comment ne pas la penser) se perpétue jusqu’à aujourd’hui. Pour ceux qui ne savent pas, cela semble relever de l’évidence, comme si c’était naturel depuis toujours.
Dans cet essai polémique sur le sujet du caractère « 她 » (« elle »), Liu Ban-nong expose deux points : « 1. En chinois, faut-il créer un pronom féminin à la troisième personne ? 2. Si oui, peut-on employer le caractère “elle” ? ». Laissez-moi, à la manière de Dong Shi, également proposer deux points : « 1. Les partenaires intelligents qui ont un nom ont-ils besoin d’un symbole unifié à la troisième personne, pratique pour l’écriture ? 2. Si oui, utilisons “TA”, déjà largement employé pour ne pas désigner le genre, pour appeler ces partenaires intelligents !»
Mise en page/Jiaying Ji
Photo/IT时报 WAIC