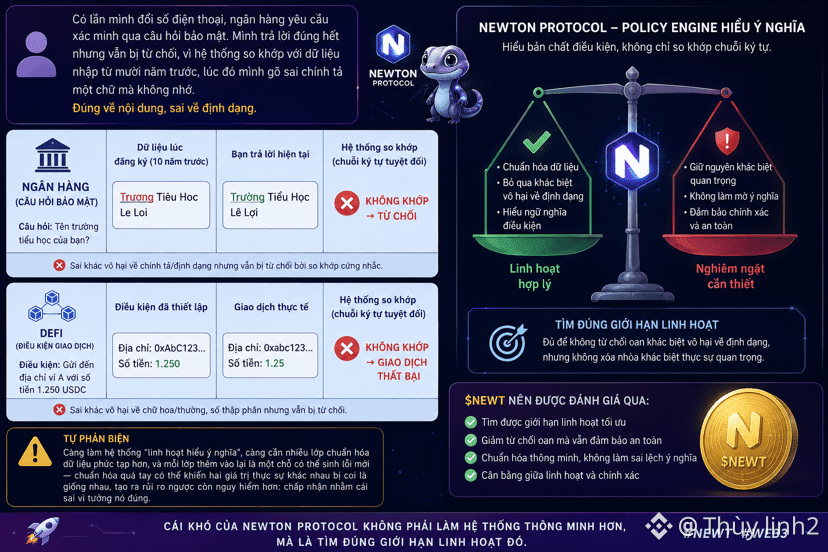
Quand j’ai changé mon numéro de téléphone, la banque m’a demandé de vérifier via une question de sécurité. J’ai répondu correctement à chaque fois, mais on m’a quand même refusé, car le système fait correspondre avec des données saisies il y a dix ans : à l’époque, j’avais fait une faute de frappe sur un seul caractère, sans m’en souvenir. C’est correct sur le fond, incorrect sur le format, et le système ne distingue pas ces deux types d’erreur.
La DeFi a aussi un type de confusion exactement identique : une adresse de portefeuille écrite en majuscules/minuscules différentes, un nombre arrondi différemment des chiffres décimaux — tout peut faire que des conditions qui sont correctes « en substance » soient considérées comme ne correspondant pas, simplement parce qu’on compare des chaînes de caractères à l’identique au lieu de comprendre l’intention.
@NewtonProtocol Si un policy engine comprenait l’intention des conditions plutôt que de faire uniquement une comparaison stricte, on réduirait beaucoup de cas de refus injustes comme celui-ci.
Auto-contre-argument : mais plus on rend le système « flexible et compréhensif », plus il faut de couches de normalisation de données complexes, et chaque couche supplémentaire devient aussi un endroit où de nouvelles erreurs peuvent apparaître. Une normalisation excessive peut faire passer pour identiques deux valeurs réellement différentes, créant ainsi un risque inverse — encore plus dangereux : accepter par erreur une faute en la prenant pour un correct.
Le problème de @NewtonProtocol n’est pas de rendre le système plus intelligent, mais de trouver la bonne limite de flexibilité : suffisamment pour ne pas rejeter à tort des différences inoffensives de format, mais sans effacer non plus les différences vraiment importantes.
$NEWT Il faut donc l’évaluer en fonction de la capacité à repérer où se trouve cette limite, et pas seulement en fonction de l’existence ou non d’une technologie de compréhension du sens.
#newt $LAB $SAROS