Nous avons tous vu le schéma.
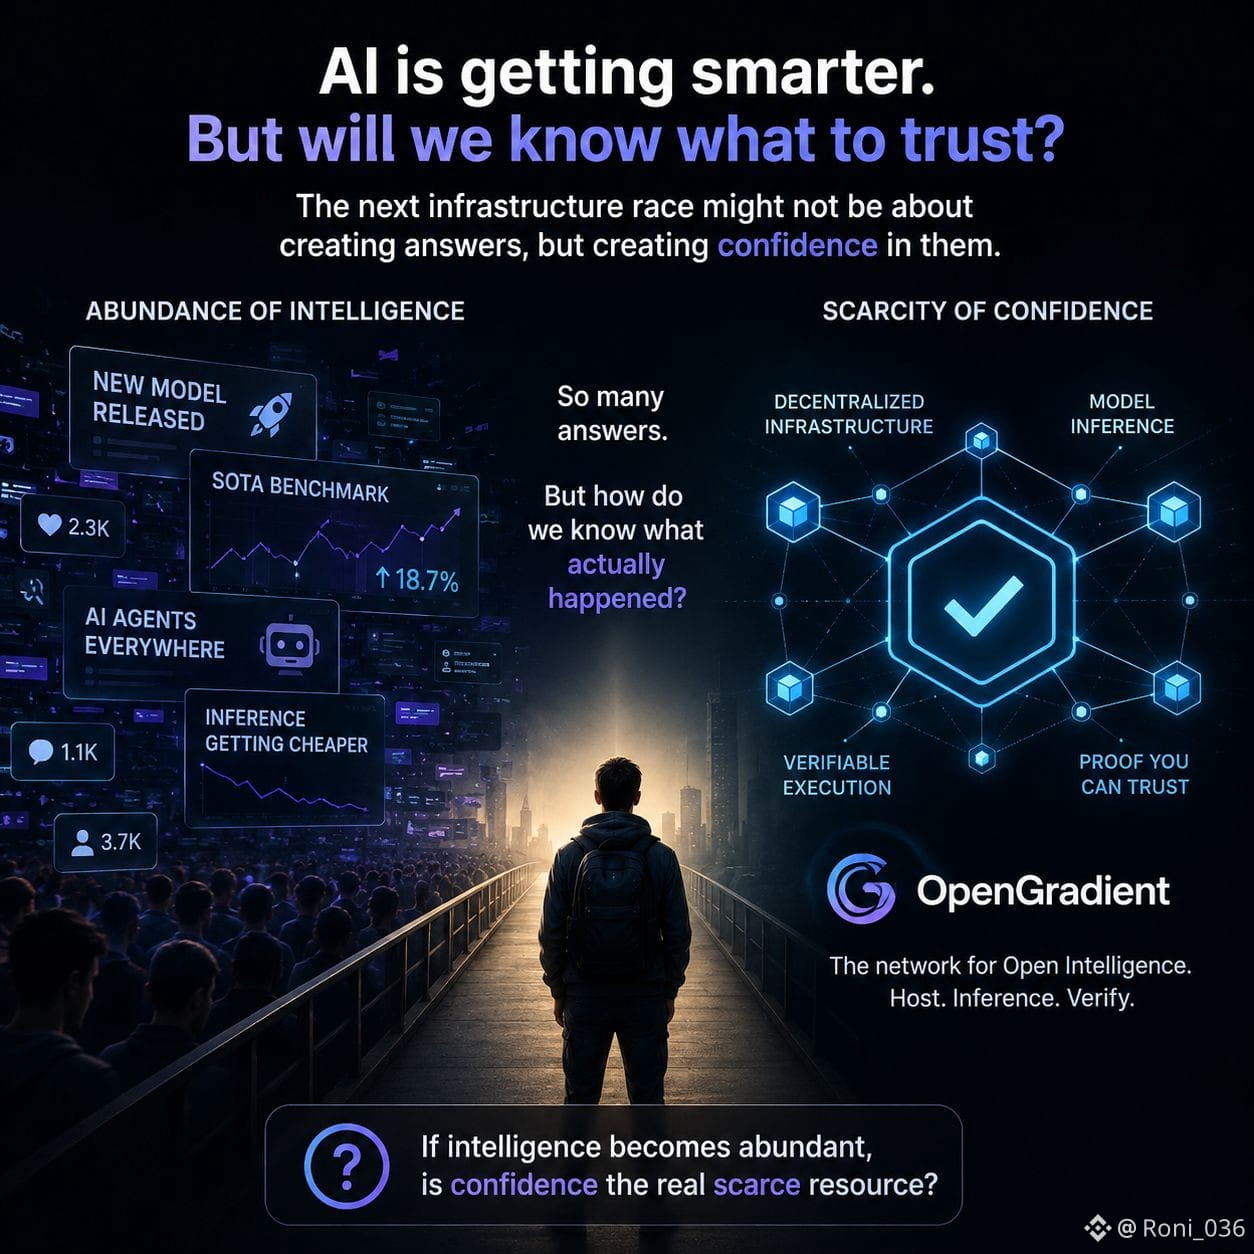
Un nouveau modèle d'IA est lancé, les réseaux sociaux se remplissent de graphiques de référence, les traders commencent à débattre des gagnants et des perdants, et les investisseurs essaient de comprendre quelle partie de la pile IA finira par capturer le plus de valeur.
La conclusion habituelle est assez simple : les modèles les plus intelligents gagnent.
Pendant un moment, je l'ai vu de cette façon aussi.
Mais plus j'y pense, plus je me demande si l'intelligence n'est que la moitié de l'histoire.
Imaginez un monde dans quelques années où les modèles d'IA sont partout. Exécuter des inférences est bon marché, déployer des modèles est facile, et de nouvelles versions apparaissent plus vite que quiconque ne peut suivre. À ce stade, trouver de l'intelligence peut ne pas être difficile du tout.
Savoir à quoi faire confiance pourrait l'être.
C'est pourquoi des projets comme @OpenGradient ont attiré mon attention, non pas parce qu'ils rendent l'IA plus puissante, mais parce qu'ils me font réfléchir à un problème différent. Dans un avenir rempli de sorties générées par des machines, comment les utilisateurs, les entreprises et les marchés vérifieront-ils ce qui s'est réellement passé dans les coulisses ?
Si l'intelligence devient abondante, la confiance pourrait devenir la ressource rare.
Et si la confiance devient la ressource rare, passons-nous trop de temps à mesurer la performance des modèles et pas assez de temps à mesurer les preuves ?
#opg $OPG @OpenGradient