J'ai ouvert OpenGradient à l'origine à cause du récit sur l'IA.
Quelques heures plus tard, je lisais à propos de HACA à la place.
Ce n'était pas là où je m'attendais à finir.
La plupart des conversations sur l'IA se ressemblent ces jours-ci. Modèles plus rapides. Modèles plus intelligents. Nouveaux repères.
HACA a attiré mon attention parce que ce n'était pas vraiment à propos de tout ça.
Une chose m'a dérangé pendant ma lecture. L'IA nécessite une quantité ridicule de puissance de calcul. En même temps, les gens de la crypto veulent que tout soit transparent et vérifiable.
Mettre les deux dans le même système semble plus difficile que ce que les gens laissent entendre.
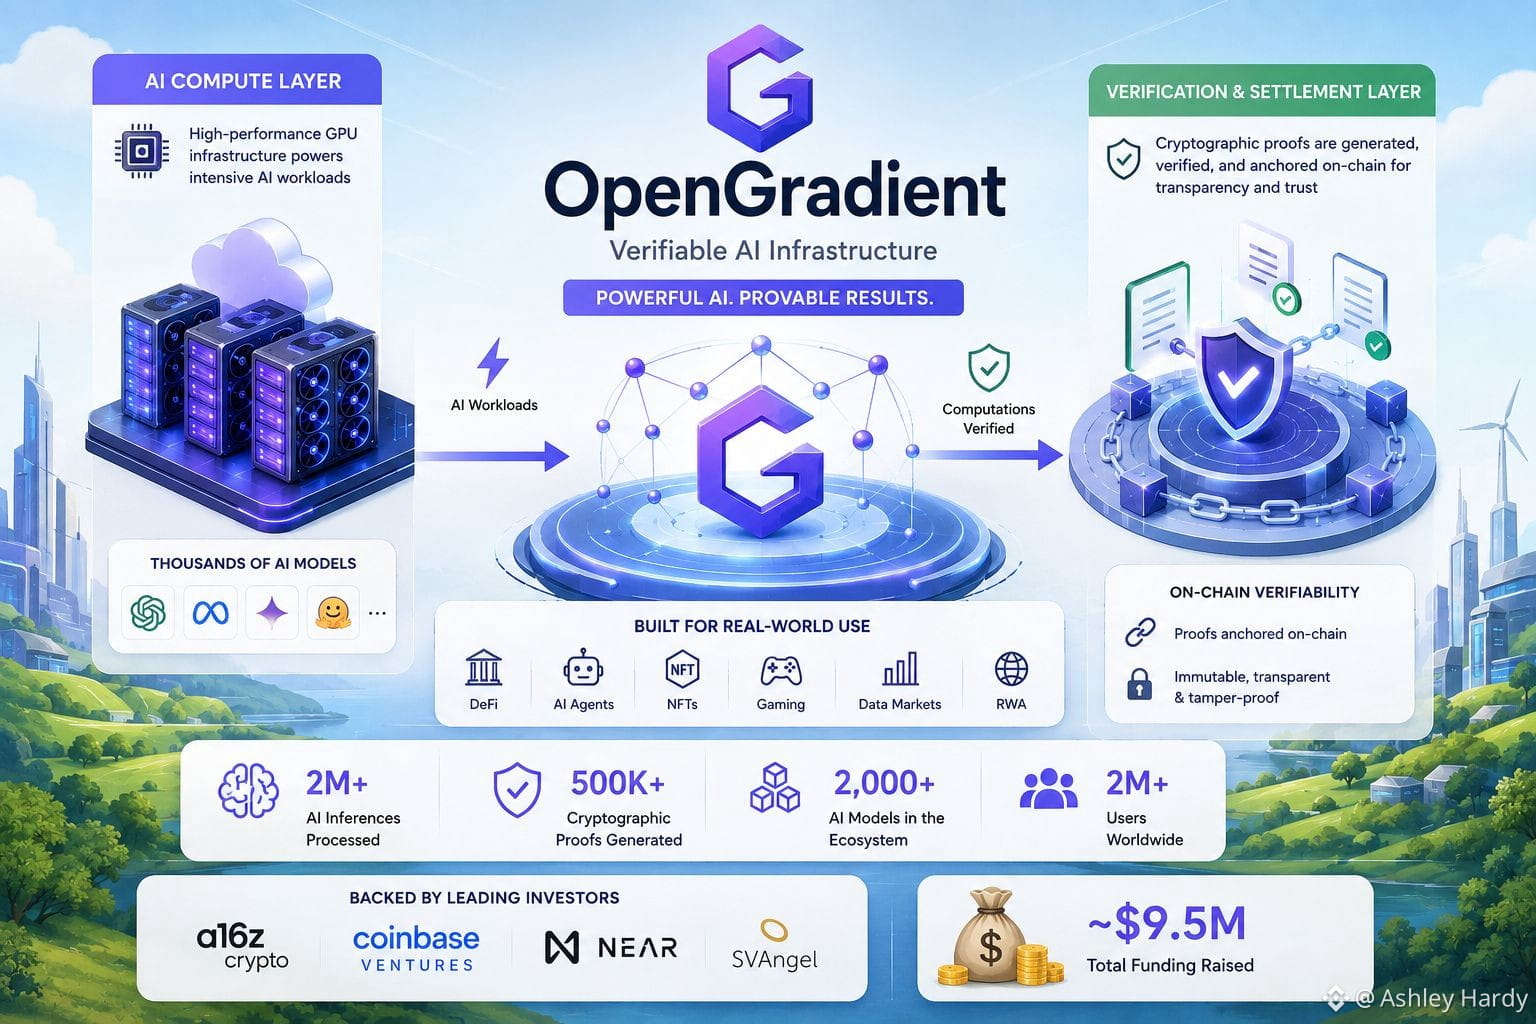
D'après ce que je comprends, OpenGradient gère le travail lourd de l'IA avec une infrastructure GPU tandis que la vérification se fait séparément. L'objectif n'est pas de forcer chaque calcul sur une blockchain.
Honnêtement, cette partie a du sens.
J'ai parcouru certaines des statistiques de l'écosystème et elles étaient plus grandes que ce à quoi je m'attendais. Plus de 2 millions d'inférences d'IA ont déjà été traitées. Plus de 500 000 preuves cryptographiques ont été générées. Le réseau supporte plus de 2 000 modèles d'IA et a dépassé les 2 millions d'utilisateurs.
Pour un projet qui n'est toujours pas discuté autant que certains jetons d'IA, ce n'est pas mal.
Il y a aussi environ 9,5 millions de dollars de financement derrière le projet, avec un soutien lié à a16z crypto, Coinbase Ventures, NEAR, SV Angel et d'autres.
Peut-être que HACA ne deviendra jamais le récit principal.
Pourtant, chaque fois que je lis à propos d'OpenGradient, je finis par passer plus de temps à regarder l'infrastructure qu'à m'intéresser aux modèles d'IA eux-mêmes.
#opg @OpenGradient $OPG