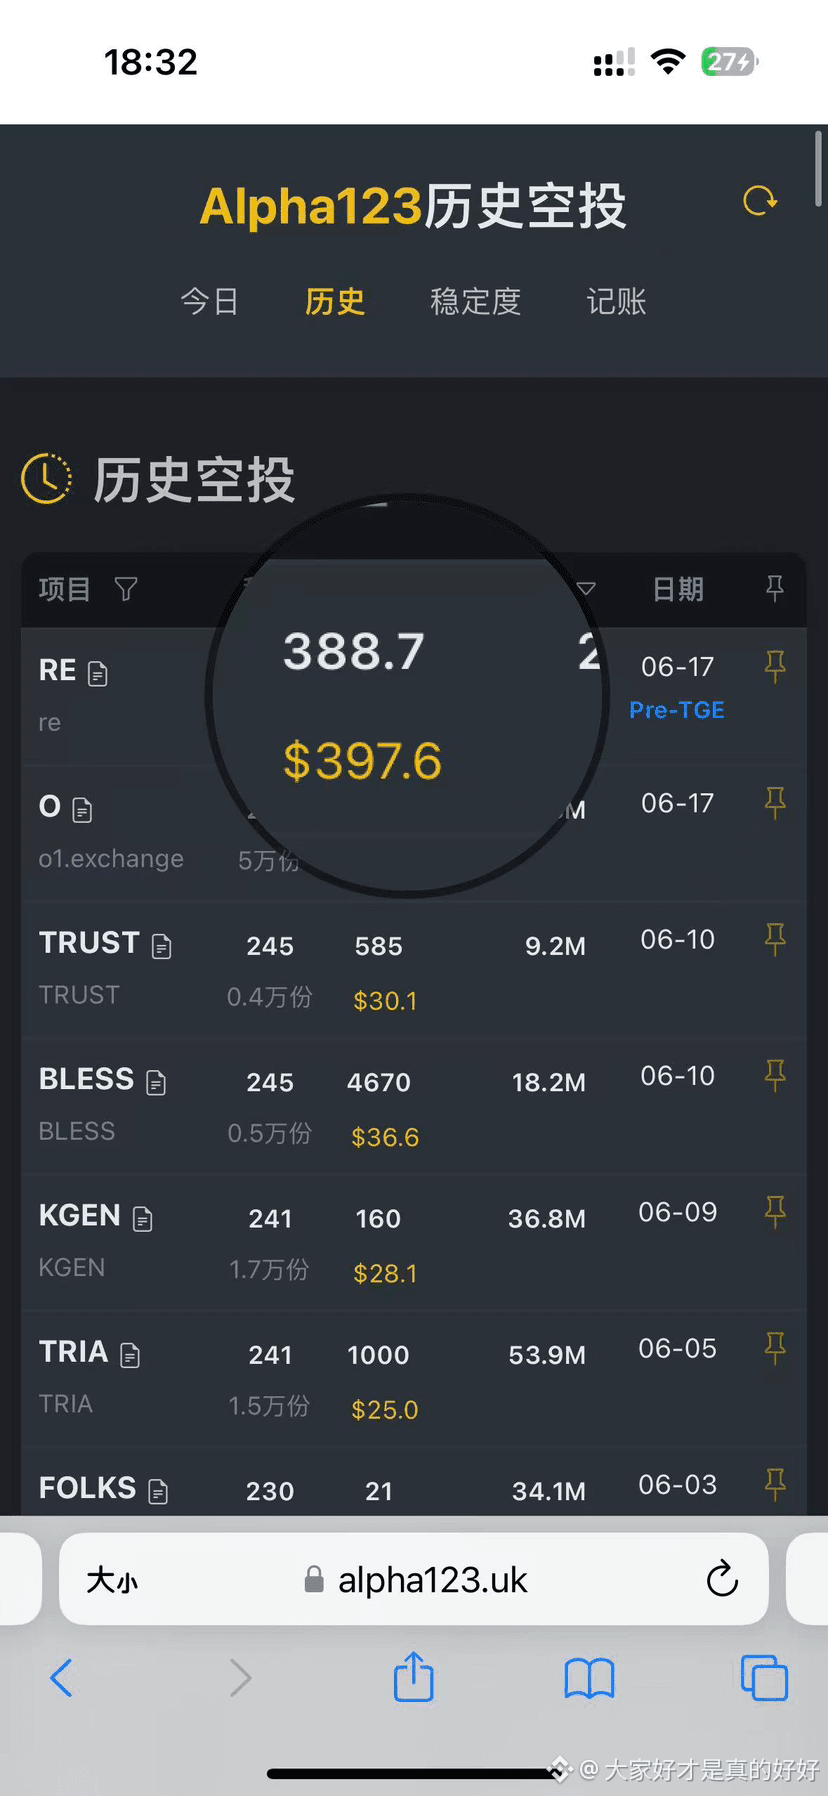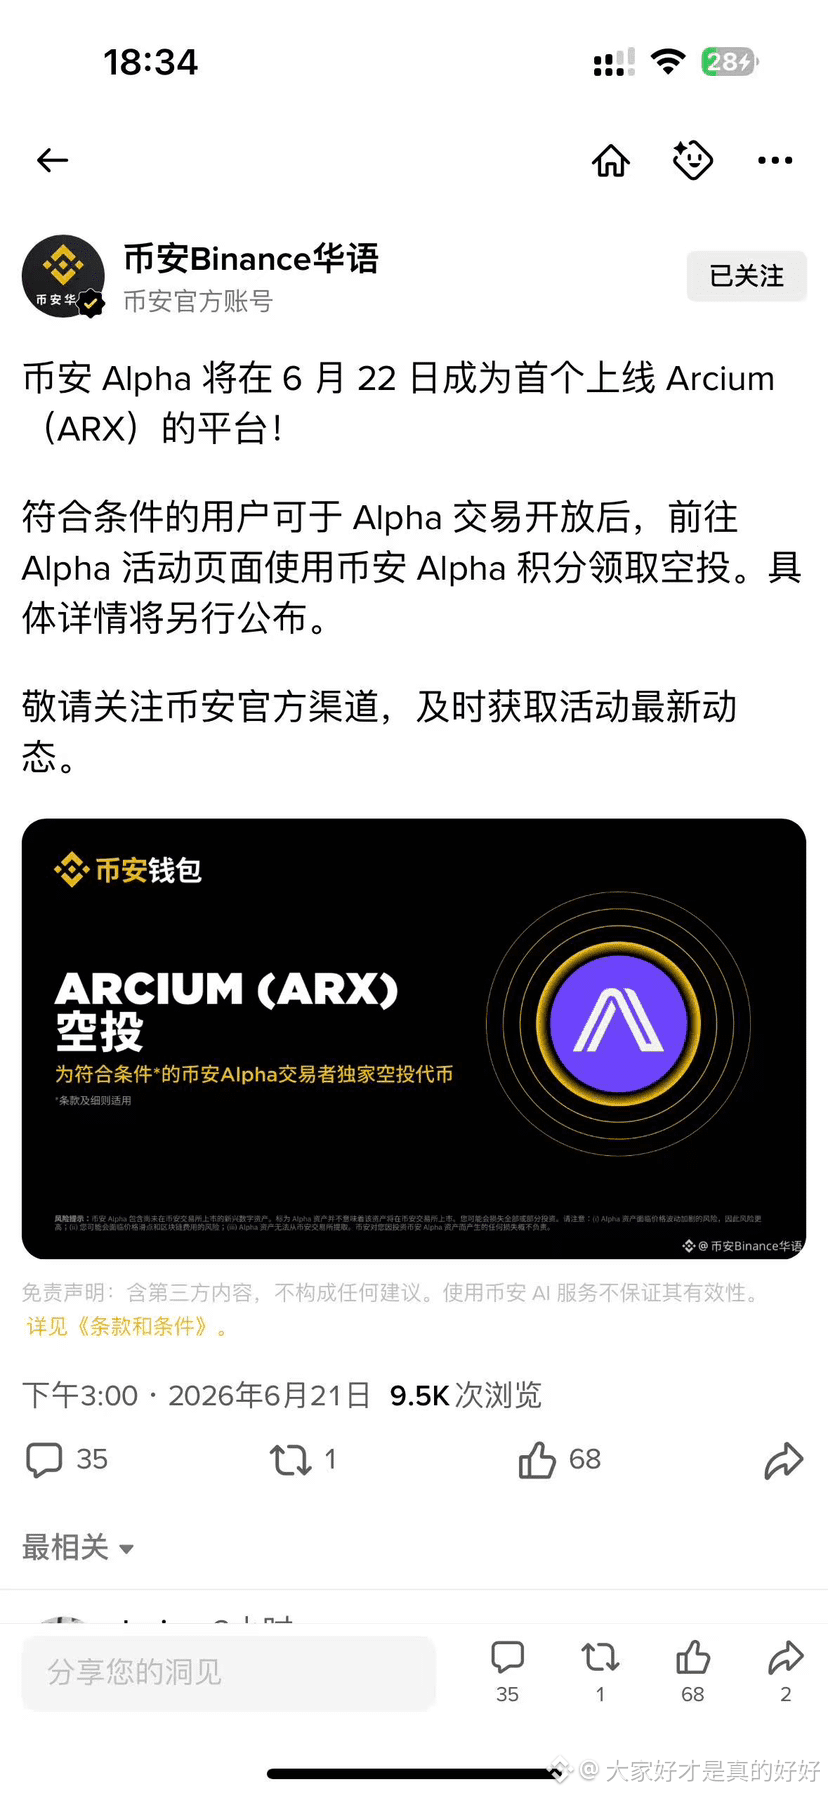
📅 Alpha Airdrop Prévision (21🈷️6)
Deux jours sans airdrop ce week-end, et tout a été réparti sur 261, aujourd'hui on a enfin la prévision de demain, ça sent le gros projet, je parie sur un score entre 225 et 230, tout le monde aura sa part, pourra-t-on reproduire le grand coup d'avant ? Les bros, c'est quoi le plan ?
Récemment, dans l'exploration de l'intégration de la blockchain et de l'IA, bien que le poids des modèles soit ancré sur la blockchain, cela montre une profondeur technique, mais ça n'a pas résolu le problème central : la propriété des droits des contributeurs de données. Les paramètres des réseaux neuronaux sont entraînés grâce à une masse de données brutes, les contributions de labellisation et d'inférence se condensent en valeurs dans le modèle, mais ces contributions sont souvent ignorées après la commercialisation du modèle, menant à une impasse structurelle pour l'assetisation des données. $OPG
Les premières plateformes de crowd-sourcing de données ont été confrontées à des difficultés en raison d'un manque de mécanisme d'attribution. Les comportements d'automatisation ont dilué les revenus des véritables contributeurs, la plateforme a cédé sur les KPI, ce qui a entraîné une baisse de la qualité des données effectives, et les labellisateurs reçoivent des retours faibles. Cela révèle les limites de la recherche pure de l'échelle.
Les projets comme @OpenGradient tentent de changer cette situation via des mécanismes de vérification sur la chaîne. Ils ne se basent pas sur le volume de téléchargement, mais suivent la contribution réelle des données dans le modèle, comme l'impact des gradients et l'amélioration des performances. Cette traçabilité se base sur l'expérience pratique des attaques adversariales, rendant le tout plus pragmatique. Cela ouvre de nouvelles possibilités pour une distribution équitable des actifs IA. #opg