#opg $OPG Il y a quelques jours, j’ai fait un test sur <0>chat.opengradient.ai</0> avec le compte @OpenGradient . J’ai demandé à plusieurs modèles d’écrire, chacun, une analyse de l’impact du déverrouillage des tokens sur la liquidité en me basant sur des consignes assez pointilleuses. Avec la même consigne, les retours de quelques modèles de premier plan ont été tellement différents que j’en ai été surpris.
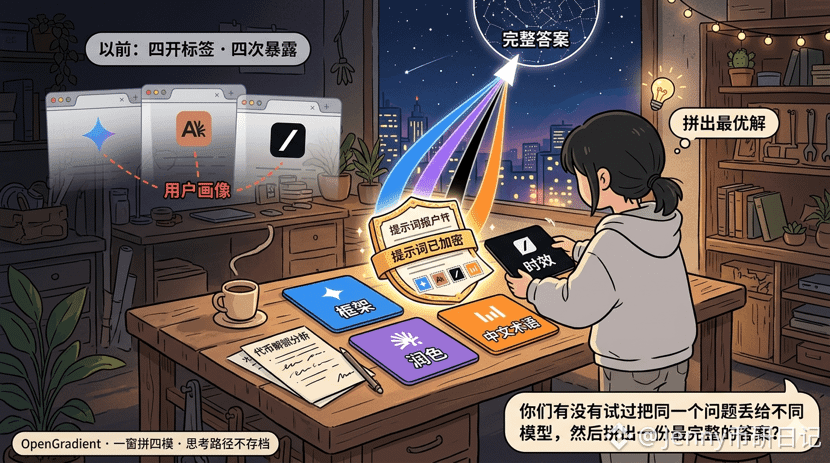
D’abord, Gemini : sa réponse ressemble le plus à un rapport de recherche. La structure est très soignée, et les principaux points de données sont listés clairement, mais la lecture a un côté récitation de manuel. En comparaison, Claude écrit de façon plus fluide : la logique de communication est très “dans le métier”, le rythme des phrases, qu’elles soient longues ou courtes, est parfaitement maîtrisé — idéal pour le coller directement dans un PPT. La réponse de Grok est la plus courte, mais il insère aussi, à l’époque, des sujets d’actualité liés qui circulaient sur X, ce qui donne une forte impression d’actualité. En revanche, la profondeur est un peu moindre. Quant à ByteDance Seed, il saisit le mieux les termes en chinois : certaines formulations localisées, que les autres modèles ratent complètement, rendent vraiment bien leur “vibe”.
Ce qui m’a surtout semblé intéressant, c’est que je peux jongler entre plusieurs modèles dans la même conversation. Je commence par demander à Gemini de poser le cadre, puis je fais affiner le langage par Claude, et enfin j’ajoute une phrase de contexte en temps réel avec Grok. Tout le processus se fait sans changer de page, et mes consignes ne laissent pas de fragments entre différentes plateformes.
Avant, il fallait ouvrir trois ou quatre onglets de navigateur, et chaque plateforme conservait l’historique de mes questions. Une fois tout regroupé dans une seule fenêtre, il y a énormément moins de démarches — et le chiffrement est activé par défaut. Les plateformes ne peuvent pas voir avec quels modèles je compare, et elles ne sauraient pas non plus à quel rythme de déverrouillage de tel token je m’intéresse.
En fait, il n’existe pas d’IA parfaite. Un modèle unique a du mal à tout concilier : rigueur, facilité de lecture et pertinence temporelle. Maintenant, on peut les répartir selon les besoins, et mon cheminement de pensée ne sera conservé par aucune plateforme.
Est-ce que vous avez déjà essayé de donner la même question à différents modèles, puis de recomposer une réponse la plus complète possible ?