Tout le monde se précipite à investir dans des pièces "AI x Crypto"... en longs et shorts aveugles sur du pur hype 🤡📉📈$OPG
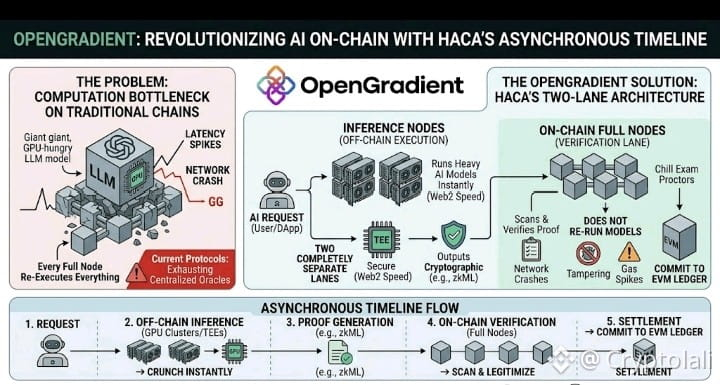
Mais soyons sérieux — avez-vous pensé à ce qui se passe si un validateur essaie de faire tourner un LLM complet sur la chaîne ?
💀 Le réseau se fait CUISINER.
La latence explose.
Les nœuds s'étouffent.
La chaîne = MORT. GG.
La plupart de ces "protocoles AI" ?
Juste des oracles centralisés avec un autocollant Web3 collé dessus. Épuisant.
Puis tu regardes @OpenGradient_ … et ça fait une autre impression.
⚡ Cadre HACA
→ Sépare la COMPUTATION et la VÉRIFICATION
→ Pas de lourds AI sur chaîne
🧠 Nœuds d'Inference (hors chaîne)
→ Exécutent des LLM à la vitesse Web2 sur GPU/TEE
🔐 Nœuds Complets (sur chaîne)
→ Ne recalculent pas
→ Vérifient juste les preuves (style zkML)
→ Propre, efficace, évolutif
🚀 Résultat ?
Pas de choke réseau
Pas de pics de gas fous
Pas de faux récit "AI"
C'est une vraie infrastructure pour de véritables agents AI sur chaîne.
Encore tôt. Encore en construction.
Mais C'EST le genre d'architecture qui survit.
$OPG
👀🔥
Mais soyons sérieux — avez-vous pensé à ce qui se passe si un validateur essaie de faire tourner un LLM complet sur la chaîne ?
💀 Le réseau se fait CUISINER.
La latence explose.
Les nœuds s'étouffent.
La chaîne = MORT. GG.
La plupart de ces "protocoles AI" ?
Juste des oracles centralisés avec un autocollant Web3 collé dessus. Épuisant.
Puis tu regardes @OpenGradient_ … et ça fait une autre impression.
⚡ Cadre HACA
→ Sépare la COMPUTATION et la VÉRIFICATION
→ Pas de lourds AI sur chaîne
🧠 Nœuds d'Inference (hors chaîne)
→ Exécutent des LLM à la vitesse Web2 sur GPU/TEE
🔐 Nœuds Complets (sur chaîne)
→ Ne recalculent pas
→ Vérifient juste les preuves (style zkML)
→ Propre, efficace, évolutif
🚀 Résultat ?
Pas de choke réseau
Pas de pics de gas fous
Pas de faux récit "AI"
C'est une vraie infrastructure pour de véritables agents AI sur chaîne.
Encore tôt. Encore en construction.
Mais C'EST le genre d'architecture qui survit.
$OPG
👀🔥