j'ai encore fouillé dans l'interface studio d'OpenLedger. $OPEN , #OpenLedger @OpenLedger — il y a quelque chose qui mérite d'y réfléchir.
le pitch est essentiellement : les contributeurs de données possèdent leur travail, sont payés lorsque les modèles d'IA l'utilisent, tout est sur la blockchain et transparent. et techniquement, c'est exact. Les logs de Preuve d'Attribution montrent quel jeu de données a influencé quelle sortie de modèle, puis distribuent les récompenses OPEN en conséquence. le mainnet est en ligne depuis novembre, le moteur d'attribution a été mis à jour en janvier pour survivre à l'affinage des modèles sans perdre la trace de provenance. cette partie fonctionne.
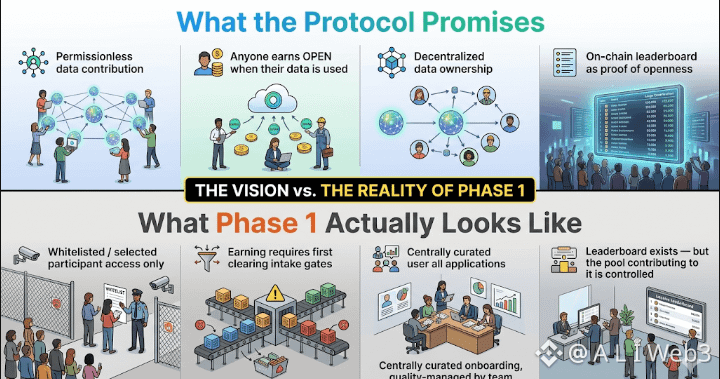
mais ce qui m'a frappé — quand Datanets a réellement lancé le mode de contribution Phase 1, l'accès était restreint aux participants sur liste blanche. sélectionné, organisé, gestion de l'entrée. donc l'histoire "tout le monde peut contribuer des données et gagner" se heurte à un mur au moment où vous essayez de franchir la porte. pas inhabituel pour un déploiement contrôlé, très bien. mais c'est une contradiction silencieuse lorsque "la propriété décentralisée des données" est le titre avec lequel vous vous avancez.
le tableau de classement on-chain est en direct, classé par qualité de contribution et activité. vraies données, vraie structure. vous pouvez voir les rails fonctionner. ce que vous ne pouvez pas encore voir, c'est si ces rails restent ouverts une fois que la phase contrôlée se termine et que la pression de volume se manifeste.
hmm… un protocole de données décentralisé qui contrôle qui contribue aux données compte-t-il toujours comme une propriété décentralisée des données, ou juste comme un stockage décentralisé ?
le pitch est essentiellement : les contributeurs de données possèdent leur travail, sont payés lorsque les modèles d'IA l'utilisent, tout est sur la blockchain et transparent. et techniquement, c'est exact. Les logs de Preuve d'Attribution montrent quel jeu de données a influencé quelle sortie de modèle, puis distribuent les récompenses OPEN en conséquence. le mainnet est en ligne depuis novembre, le moteur d'attribution a été mis à jour en janvier pour survivre à l'affinage des modèles sans perdre la trace de provenance. cette partie fonctionne.
mais ce qui m'a frappé — quand Datanets a réellement lancé le mode de contribution Phase 1, l'accès était restreint aux participants sur liste blanche. sélectionné, organisé, gestion de l'entrée. donc l'histoire "tout le monde peut contribuer des données et gagner" se heurte à un mur au moment où vous essayez de franchir la porte. pas inhabituel pour un déploiement contrôlé, très bien. mais c'est une contradiction silencieuse lorsque "la propriété décentralisée des données" est le titre avec lequel vous vous avancez.
le tableau de classement on-chain est en direct, classé par qualité de contribution et activité. vraies données, vraie structure. vous pouvez voir les rails fonctionner. ce que vous ne pouvez pas encore voir, c'est si ces rails restent ouverts une fois que la phase contrôlée se termine et que la pression de volume se manifeste.
hmm… un protocole de données décentralisé qui contrôle qui contribue aux données compte-t-il toujours comme une propriété décentralisée des données, ou juste comme un stockage décentralisé ?