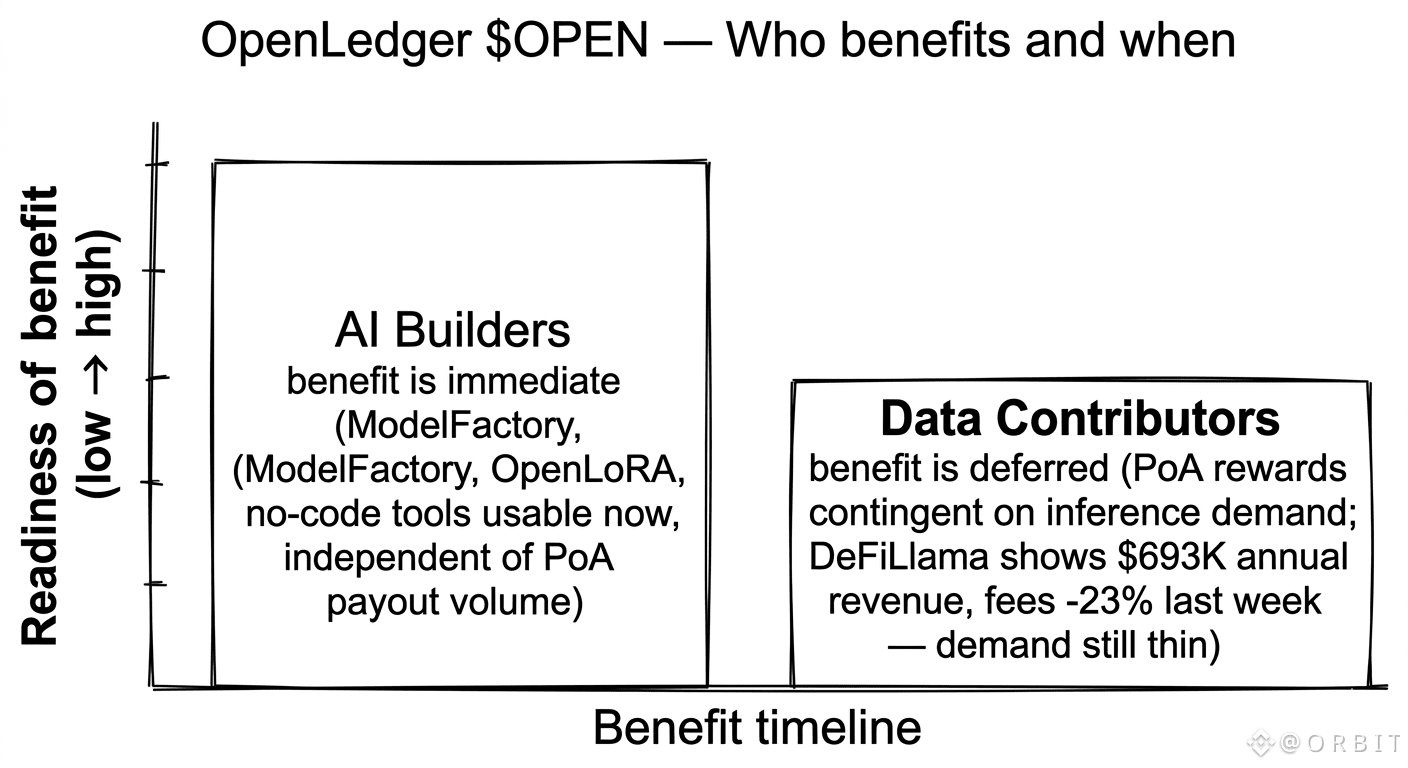
La partie qui m'est restée de la tâche OpenLedger $OPEN #OpenLedger @OpenLedger , c'est comment les deux groupes de bénéficiaires — les constructeurs d'IA et les contributeurs de données — sont sur des timelines très différentes, même si le pitch les présente comme arrivant ensemble. Les constructeurs obtiennent une utilité immédiate : ModelFactory fonctionne aujourd'hui, le fine-tuning sans code fonctionne aujourd'hui, OpenLoRA déploie des modèles sans lourdes charges d'infrastructure. Cette valeur est préchargée et ne dépend pas de la rotation du flywheel de la preuve d'attribution. Les contributeurs, eux, c'est différent. Leurs récompenses ne se matérialisent que lorsque les modèles construits sur leurs Datanets sont réellement interrogés à grande échelle — mais DeFiLlama montre des revenus annuels de protocole s'élevant à 693K $ avec des frais en baisse de 23 % au cours de la dernière semaine, ce qui suggère que la demande d'inférence est encore faible. Le design est cohérent ; la séquence compte juste plus que ce que le cadre admet. Les constructeurs arrivent, construisent sur l'infrastructure, les modèles restent en attente. Les contributeurs ont déjà téléchargé, déjà contribué, déjà gagné leurs enregistrements d'attribution… et attendent maintenant une demande qui n'est pas encore complètement arrivée. Que cet écart se réduise dépend entièrement de savoir si les constructeurs qui se sont présentés livrent réellement des produits que les gens utilisent.


Publier
Avertissement : ce contenu inclut des opinions de tiers. Il ne constitue pas un conseil. Binance Ai peut être utilisée, sans garantie de résultat. Consultez les CG.