

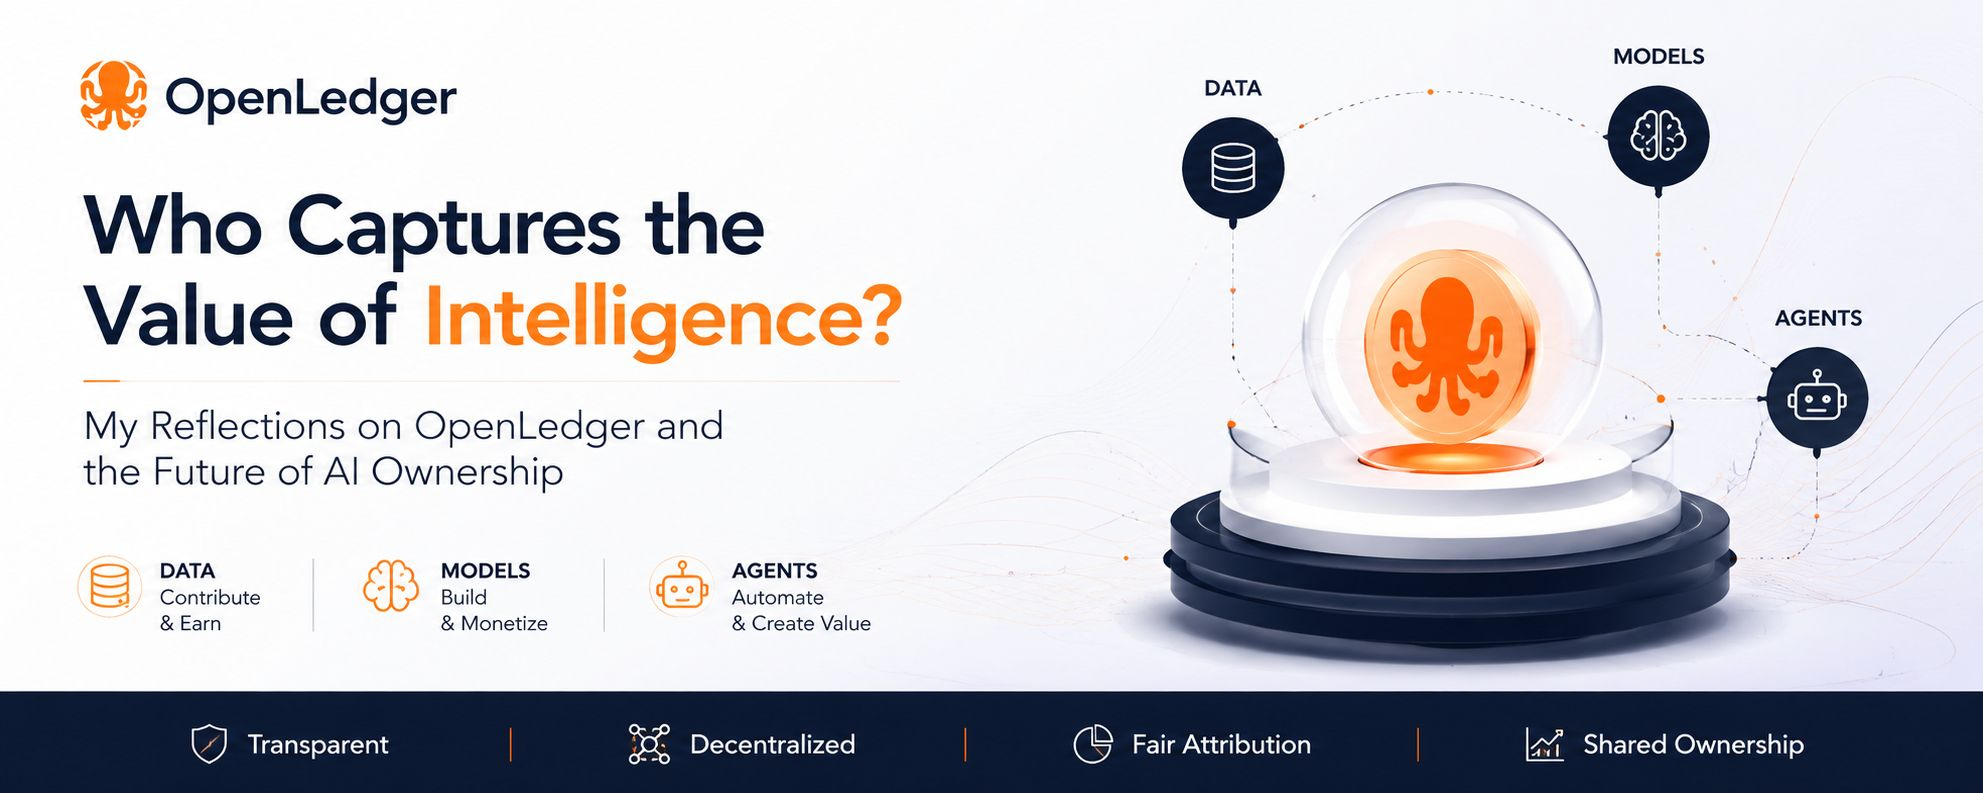

Quand je regarde OpenLedger, je me surprends à penser moins à la blockchain et plus à un problème qui a silencieusement grandi sous la surface de l'économie numérique depuis des années.
Je pense que nous avons atteint un point où les données sont devenues l'une des ressources les plus précieuses au monde, pourtant la relation entre ceux qui les créent et ceux qui en profitent reste étonnamment déconnectée. Chaque jour, les gens génèrent d'énormes quantités d'informations à travers des conversations, des applications, des transactions, des recherches et des activités en ligne. Ces données alimentent les systèmes d'IA, améliorent les modèles et aident les entreprises à construire des produits de plus en plus puissants. Pourtant, la plupart des contributeurs participent rarement à la valeur qui émerge de leurs contributions.
Ce qui m'intéresse, c'est que ce déséquilibre ne s'est pas produit parce que quelqu'un l'a délibérément conçu de cette manière. À bien des égards, c'est simplement le résultat de l'évolution d'Internet. Les plateformes centralisées sont devenues des lieux efficaces pour collecter, organiser et monétiser les informations. Au fil du temps, la propriété des données, la propriété de l'infrastructure et la capture de la valeur se sont concentrées aux mêmes endroits.
Alors que l'intelligence artificielle devient plus importante, je pense que ce problème devient de plus en plus difficile à ignorer.
Les modèles d'IA dépendent de vastes ensembles de données. Ces ensembles de données proviennent d'innombrables individus, entreprises, applications et systèmes. Les développeurs de modèles contribuent par leur expertise et leur innovation. Les utilisateurs fournissent des retours qui améliorent la performance. Pourtant, malgré le nombre de participants impliqués, la structure économique semble souvent étonnamment étroite.
Plus j'étudie cet espace, plus je sens que le défi n'est pas seulement technologique. Il est aussi économique.
La question n'est plus seulement comment construire de meilleures IA. La question est comment construire des systèmes qui coordonnent équitablement les personnes, les données, les modèles et les agents qui rendent l'IA possible en premier lieu.
C'est là qu'OpenLedger a attiré mon attention.
Au lieu de se concentrer exclusivement sur la performance du modèle ou la puissance de calcul, je vois OpenLedger tenter de s'attaquer à un problème structurel plus profond. Le projet semble commencer avec une idée relativement simple : si les données, les modèles d'IA et les agents autonomes deviennent des actifs numériques productifs, alors peut-être ont-ils besoin d'une infrastructure capable de suivre les contributions et de distribuer la valeur de manière plus transparente.
Je trouve cette perspective intéressante car elle déplace la conversation de la pure technologie vers la conception des incitations.
Dans la plupart des discussions sur l'IA, les données sont traitées comme une matière première. Elles entrent dans un système, contribuent à l'entraînement, puis disparaissent largement de la vue. La connexion entre le contributeur original et la valeur future générée par ces données devient souvent impossible à mesurer.
OpenLedger semble explorer une approche alternative.
Lorsque je lis sur le projet, je ne le vois pas essayer de positionner les données comme une entrée passive. Au lieu de cela, je vois une tentative de traiter les données comme un actif économique qui peut continuer à générer de la valeur au sein d'un réseau plus large. L'idée semble être que si les contributions peuvent être identifiées et attribuées, alors les récompenses peuvent potentiellement être distribuées plus efficacement.
À première vue, cela semble simple.
Plus j'y pense, cependant, plus cela devient compliqué.
Mesurer la contribution dans les systèmes d'IA n'est pas facile. Les données créent rarement de la valeur isolément. Un modèle peut dépendre de milliers de datasets. Plusieurs contributeurs peuvent influencer les résultats simultanément. L'utilité de l'information change souvent avec le temps.
De ce fait, je pense que le véritable défi auquel OpenLedger est confronté n'est pas de savoir si la blockchain peut enregistrer des transactions. Le véritable défi est de savoir si la contribution elle-même peut être mesurée de manière significative.
Cette distinction est importante.
De nombreux projets blockchain se concentrent sur la création d'infrastructures. OpenLedger semble poser une question différente : comment l'infrastructure peut-elle soutenir l'attribution économique à travers les écosystèmes d'IA ?
Je trouve cette question significativement plus intéressante.
Quand je prends du recul et que je regarde la situation dans son ensemble, je vois le développement de l'IA comme un processus hautement interconnecté. Les fournisseurs de données créent des ressources. Les développeurs construisent des modèles. Les applications fournissent des utilités. Les utilisateurs génèrent des retours. Les agents autonomes exécutent de plus en plus de tâches au nom des personnes et des organisations.
Aucun de ces composants ne fonctionne de manière indépendante.
La valeur produite par le système émerge des interactions entre eux.
Ce que je pense qu'OpenLedger essaie de faire, c'est créer un environnement où ces interactions deviennent économiquement visibles. Au lieu de traiter les données, les modèles et les agents comme des mondes séparés, le projet semble explorer des façons de les connecter à travers un cadre partagé.
Si cela réussit, cela pourrait potentiellement réduire l'une des plus grandes inefficacités de l'économie IA d'aujourd'hui : le décalage entre contribution et compensation.
Bien sûr, je pense aussi qu'il est important de rester réaliste.
L'histoire montre que les systèmes d'incitation sont incroyablement difficiles à concevoir. Créer des récompenses est facile. Créer des récompenses durables est beaucoup plus difficile.
Chaque fois que des incitations économiques sont introduites, les participants adaptent naturellement leur comportement autour d'elles. Certains contribuent une valeur réelle. D'autres optimisent pour des récompenses. Au fil du temps, les systèmes doivent continuellement équilibrer ouverture, qualité, équité et efficacité.
C'est pourquoi je pense que l'avenir d'OpenLedger dépendra autant de l'économie que de la technologie.
L'infrastructure peut fonctionner parfaitement, mais si les incitations deviennent déformées, le système pourrait encore avoir des difficultés. En revanche, si les incitations restent alignées, le réseau pourrait potentiellement attirer des contributions de plus en plus précieuses au fil du temps.
Un autre aspect qui me fait réfléchir est l'idée de liquidité.
J'ai souvent l'impression qu'une grande partie de l'économie de l'IA contient des actifs qui sont précieux mais difficiles à monétiser directement. Les données possèdent de la valeur mais manquent souvent de marchés efficaces. Les modèles créent de l'utilité mais peuvent avoir du mal à capter une participation économique continue. Les agents autonomes peuvent accomplir un travail utile mais fonctionnent souvent dans des cadres économiques limités.
OpenLedger semble explorer des façons de rendre ces actifs plus économiquement actifs.
Je pense à cela presque comme à transformer des ressources dormantes en capital productif.
Un ensemble de données inutilisé contient une valeur potentielle. Un modèle inactif contient une valeur potentielle. Un agent autonome attendant des tâches contient une valeur potentielle. Le défi est de connecter ces ressources à des systèmes capables de reconnaître et de récompenser leurs contributions.
Cela semble être l'une des idées centrales derrière OpenLedger.
Que le projet réussisse ou non est quelque chose que je ne peux pas prédire avec confiance.
Ce que je peux dire, c'est que je trouve la direction intellectuellement captivante.
Depuis des années, les discussions autour de l'IA se sont principalement concentrées sur l'intelligence elle-même : comment les modèles apprennent, comment ils raisonnent et comment ils s'améliorent. De plus en plus, je pense que la conversation se déplace vers la propriété, l'attribution et la distribution de la valeur.
Qui profite lorsque l'IA crée de la valeur ?
Qui devrait être récompensé lorsque des données contribuent à un résultat réussi ?
Comment les agents autonomes devraient-ils participer aux économies numériques ?
Ces questions deviennent de plus en plus importantes à mesure que les systèmes d'IA deviennent plus capables.
Lorsque je regarde OpenLedger, je ne vois pas un projet simplement essayer de combiner IA et blockchain parce que les deux sont des technologies populaires. Je vois une tentative d'aborder un problème structurel qui existe entre eux. Le projet semble reconnaître que l'intelligence à elle seule ne suffit pas. La coordination économique compte aussi.
À bien des égards, OpenLedger semble être un laboratoire d'expérimentation dans la refonte de la manière dont la valeur circule à travers les écosystèmes d'IA.
La partie la plus intéressante, du moins de mon point de vue, n'est pas de savoir si la technologie fonctionne. La technologie peut souvent être améliorée au fil du temps. Ce qui m'intéresse davantage, c'est de savoir si un système peut aligner avec succès les incitations entre les contributeurs de données, les constructeurs de modèles, les développeurs et les agents autonomes sans créer une complexité excessive.
C'est un défi difficile.
Pourtant, je crois que c'est précisément le genre de défi qui définira la prochaine étape de l'économie de l'IA.
Alors que je continue de suivre OpenLedger, je me retrouve à revenir à la même pensée. L'avenir de l'intelligence artificielle pourrait ne pas être déterminé uniquement par qui construit les modèles les plus intelligents. Il pourrait aussi être façonné par qui crée les systèmes les plus efficaces pour attribuer, coordonner et distribuer la valeur que ces modèles génèrent.
OpenLedger tente d'explorer cette possibilité.
Que cela devienne un élément majeur de l'infrastructure future ou simplement un important laboratoire d'expérimentation, je pense que les questions qu'il soulève sont bien plus significatives que les réponses actuellement disponibles. Et dans un paysage IA en rapide évolution, parfois les projets les plus précieux ne sont pas ceux que l'on regarde.
Je pense que nous avons atteint un point où les données sont devenues l'une des ressources les plus précieuses au monde, pourtant la relation entre ceux qui les créent et ceux qui en tirent profit reste étonnamment déconnectée. Chaque jour, les gens génèrent d'énormes quantités d'informations à travers des conversations, des applications, des transactions, des recherches et des activités en ligne. Ces données alimentent les systèmes d'IA, améliorent les modèles et aident les entreprises à construire des produits de plus en plus puissants. Pourtant, la plupart des contributeurs participent rarement à la valeur qui émerge de leurs contributions.
Ce qui m'intéresse, c'est que ce déséquilibre ne s'est pas produit parce que quelqu'un l'a délibérément conçu de cette manière. À bien des égards, c'est simplement le résultat de l'évolution d'Internet. Les plateformes centralisées sont devenues des lieux efficaces pour collecter, organiser et monétiser les informations. Au fil du temps, la propriété des données, la propriété de l'infrastructure et la capture de la valeur se sont concentrées aux mêmes endroits.
Alors que l'intelligence artificielle devient plus importante, je pense que ce problème devient de plus en plus difficile à ignorer.
Les modèles d'IA dépendent de vastes ensembles de données. Ces ensembles de données proviennent d'innombrables individus, entreprises, applications et systèmes. Les développeurs de modèles contribuent par leur expertise et leur innovation. Les utilisateurs fournissent des retours qui améliorent la performance. Pourtant, malgré le nombre de participants impliqués, la structure économique semble souvent étonnamment étroite.
Plus j'étudie cet espace, plus je sens que le défi n'est pas seulement technologique. Il est aussi économique.
La question n'est plus seulement comment construire de meilleures IA. La question est comment construire des systèmes qui coordonnent équitablement les personnes, les données, les modèles et les agents qui rendent l'IA possible en premier lieu.
C'est là qu'OpenLedger a attiré mon attention.
Au lieu de se concentrer exclusivement sur la performance du modèle ou la puissance de calcul, je vois OpenLedger tenter de s'attaquer à un problème structurel plus profond. Le projet semble commencer avec une idée relativement simple : si les données, les modèles d'IA et les agents autonomes deviennent des actifs numériques productifs, alors peut-être ont-ils besoin d'une infrastructure capable de suivre les contributions et de distribuer la valeur de manière plus transparente.
Je trouve cette perspective intéressante car elle déplace la conversation de la pure technologie vers la conception des incitations.
Dans la plupart des discussions sur l'IA, les données sont traitées comme une matière première. Elles entrent dans un système, contribuent à l'entraînement, puis disparaissent largement de la vue. La connexion entre le contributeur original et la valeur future générée par ces données devient souvent impossible à mesurer.
OpenLedger semble explorer une approche alternative.
Lorsque je lis sur le projet, je ne le vois pas essayer de positionner les données comme une entrée passive. Au lieu de cela, je vois une tentative de traiter les données comme un actif économique qui peut continuer à générer de la valeur au sein d'un réseau plus large. L'idée semble être que si les contributions peuvent être identifiées et attribuées, alors les récompenses peuvent potentiellement être distribuées plus efficacement.
À première vue, cela semble simple.
Plus j'y pense, cependant, plus cela devient compliqué.
Mesurer la contribution dans les systèmes d'IA n'est pas facile. Les données créent rarement de la valeur isolément. Un modèle peut dépendre de milliers de datasets. Plusieurs contributeurs peuvent influencer les résultats simultanément. L'utilité de l'information change souvent avec le temps.
De ce fait, je pense que le véritable défi auquel OpenLedger est confronté n'est pas de savoir si la blockchain peut enregistrer des transactions. Le véritable défi est de savoir si la contribution elle-même peut être mesurée de manière significative.
Cette distinction est importante.
De nombreux projets blockchain se concentrent sur la création d'infrastructures. OpenLedger semble poser une question différente : comment l'infrastructure peut-elle soutenir l'attribution économique à travers les écosystèmes d'IA ?
Je trouve cette question significativement plus intéressante.
Quand je prends du recul et que je regarde la situation dans son ensemble, je vois le développement de l'IA comme un processus hautement interconnecté. Les fournisseurs de données créent des ressources. Les développeurs construisent des modèles. Les applications fournissent des utilités. Les utilisateurs génèrent des retours. Les agents autonomes exécutent de plus en plus de tâches au nom des personnes et des organisations.
Aucun de ces composants ne fonctionne de manière indépendante.
La valeur produite par le système émerge des interactions entre eux.
Ce que je pense qu'OpenLedger essaie de faire, c'est créer un environnement où ces interactions deviennent économiquement visibles. Au lieu de traiter les données, les modèles et les agents comme des mondes séparés, le projet semble explorer des façons de les connecter à travers un cadre partagé.
Si cela réussit, cela pourrait potentiellement réduire l'une des plus grandes inefficacités de l'économie IA d'aujourd'hui : le décalage entre contribution et compensation.
Bien sûr, je pense aussi qu'il est important de rester réaliste.
L'histoire montre que les systèmes d'incitation sont incroyablement difficiles à concevoir. Créer des récompenses est facile. Créer des récompenses durables est beaucoup plus difficile.
Chaque fois que des incitations économiques sont introduites, les participants adaptent naturellement leur comportement autour d'elles. Certains contribuent une valeur réelle. D'autres optimisent pour des récompenses. Au fil du temps, les systèmes doivent continuellement équilibrer ouverture, qualité, équité et efficacité.
C'est pourquoi je pense que l'avenir d'OpenLedger dépendra autant de l'économie que de la technologie.
L'infrastructure peut fonctionner parfaitement, mais si les incitations deviennent déformées, le système pourrait encore avoir des difficultés. En revanche, si les incitations restent alignées, le réseau pourrait potentiellement attirer des contributions de plus en plus précieuses au fil du temps.
Un autre aspect qui me fait réfléchir est l'idée de liquidité.
J'ai souvent l'impression qu'une grande partie de l'économie de l'IA contient des actifs qui sont précieux mais difficiles à monétiser directement. Les données possèdent de la valeur mais manquent souvent de marchés efficaces. Les modèles créent de l'utilité mais peuvent avoir du mal à capter une participation économique continue. Les agents autonomes peuvent accomplir un travail utile mais fonctionnent souvent dans des cadres économiques limités.
OpenLedger semble explorer des façons de rendre ces actifs plus économiquement actifs.
Je pense à cela presque comme à transformer des ressources dormantes en capital productif.
Un ensemble de données inutilisé contient une valeur potentielle. Un modèle inactif contient une valeur potentielle. Un agent autonome attendant des tâches contient une valeur potentielle. Le défi est de connecter ces ressources à des systèmes capables de reconnaître et de récompenser leurs contributions.
Cela semble être l'une des idées centrales derrière OpenLedger.
Que le projet réussisse ou non est quelque chose que je ne peux pas prédire avec confiance.
Ce que je peux dire, c'est que je trouve la direction intellectuellement captivante.
Depuis des années, les discussions autour de l'IA se sont principalement concentrées sur l'intelligence elle-même : comment les modèles apprennent, comment ils raisonnent et comment ils s'améliorent. De plus en plus, je pense que la conversation se déplace vers la propriété, l'attribution et la distribution de la valeur.
Qui bénéficie lorsque l'IA crée de la valeur ?
Qui devrait être récompensé lorsque des données contribuent à un résultat réussi ?
Comment les agents autonomes devraient-ils participer aux économies numériques ?
Ces questions deviennent de plus en plus importantes à mesure que les systèmes d'IA deviennent plus capables.
Lorsque je regarde OpenLedger, je ne vois pas un projet qui essaie simplement de combiner IA et blockchain parce que les deux sont des technologies populaires. Je vois une tentative d'aborder un problème structurel qui existe entre eux. Le projet semble reconnaître que l'intelligence à elle seule ne suffit pas. La coordination économique compte aussi.
À bien des égards, OpenLedger semble être un laboratoire d'expérimentation dans la refonte de la manière dont la valeur circule à travers les écosystèmes d'IA.
La partie la plus intéressante, du moins de mon point de vue, n'est pas de savoir si la technologie fonctionne. La technologie peut souvent être améliorée au fil du temps. Ce qui m'intéresse davantage, c'est de savoir si un système peut aligner avec succès les incitations entre les contributeurs de données, les constructeurs de modèles, les développeurs et les agents autonomes sans créer une complexité excessive.
C'est un défi difficile.
Pourtant, je crois que c'est précisément le genre de défi qui définira la prochaine étape de l'économie de l'IA.
Alors que je continue de suivre OpenLedger, je me retrouve à revenir à la même pensée. L'avenir de l'intelligence artificielle pourrait ne pas être déterminé uniquement par qui construit les modèles les plus intelligents. Il pourrait aussi être façonné par qui crée les systèmes les plus efficaces pour attribuer, coordonner et distribuer la valeur que ces modèles génèrent.
OpenLedger tente d'explorer cette possibilité.
\u003cm-272/\u003e \u003cc-274/\u003e \u003ct-276/\u003e
