Je reviens toujours à la même question, et honnêtement, je n'arrive pas encore à me poser une réponse claire…
Tout le monde parle de crypto AI en ce moment. Le bruit est fou. Tu vois des réseaux GPU, des places de marché de modèles, des plateformes d'agents—des dizaines de projets qui courent pour définir comment les données, les modèles et les agents autonomes interagissent. Mais quand j'essaie vraiment de choisir lequel construit une infrastructure réelle, pas juste du hype, je me sens perdu.
Est-ce Bittensor avec son énorme réseau de sous-réseaux ? Fetch.ai qui pousse tous ces "agents autonomes" ? Render avec son réseau de location GPU ? Ou est-ce quelque chose de plus discret comme OpenLedger ?
C'est là que les choses deviennent intéressantes...
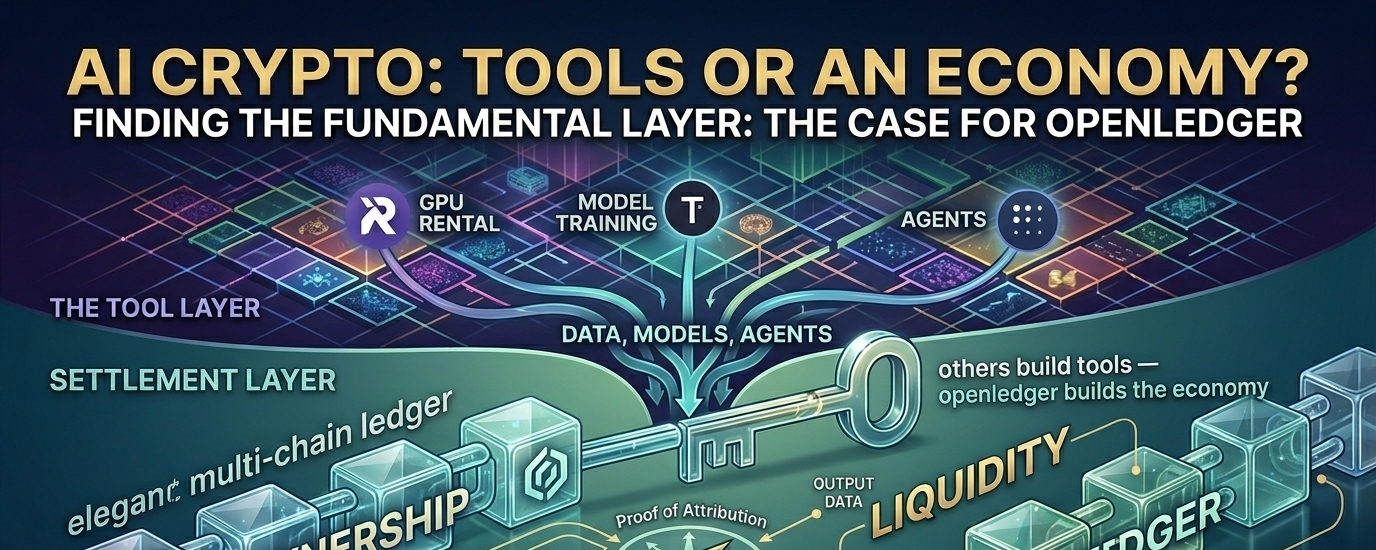
Je m'arrête et pense ici… parce que presque chaque projet d'IA dans la crypto résout juste une partie du stack IA. C'est comme si tout le monde construisait des outils, mais personne ne construisait l'économie autour de ces outils.
Render vous donne de la puissance GPU. Bittensor coordonne l'entraînement de modèles à travers des nœuds. Fetch.ai construit des agents capables d'effectuer des tâches. SingularityNET est un marché pour les services IA. Tous utiles, mais il manque quelque chose sous tout cela...
Qui possède les données ?
Qui est payé quand un modèle utilise vos données ?
Comment prouver d'où vient réellement la connaissance d'un modèle ?
Comment tout cela devient-il liquide, négociable, monétisable ?
La plupart des gens ignorent cela. Ils se concentrent sur le calcul, ou les modèles, ou les agents… mais pas sur la couche économique qui permet aux données, modèles et agents de circuler réellement comme de la valeur. Sans cette couche, vous avez juste des outils coûteux qui traînent, pas une économie.
J'ai réfléchi à la façon dont l'IA fonctionne aujourd'hui dans le monde réel, et c'est désordonné. Les grandes entreprises récupèrent des données de partout. Elles entraînent des modèles. Elles vendent l'accès. Les créateurs de données originaux ? Ils ne voient rien. Pas de moyen clair d'attribuer les données à leur source, pas de moyen de suivre comment ces données ont influencé un modèle, pas de moyen de payer automatiquement les bonnes personnes, pas de moyen de prouver aux institutions que les données sont légitimes et conformes.
Les humains ne peuvent pas faire cela manuellement à grande échelle. Avocats, contrats, audits… c'est trop lent, trop cher, trop opaque.
Donc, la vraie question n'est pas "qui a les meilleurs modèles ?"
C'est : "Qui construit l'infrastructure où les données, les modèles et les agents peuvent devenir des actifs liquides ?"
C'est là qu'OpenLedger attire mon attention...
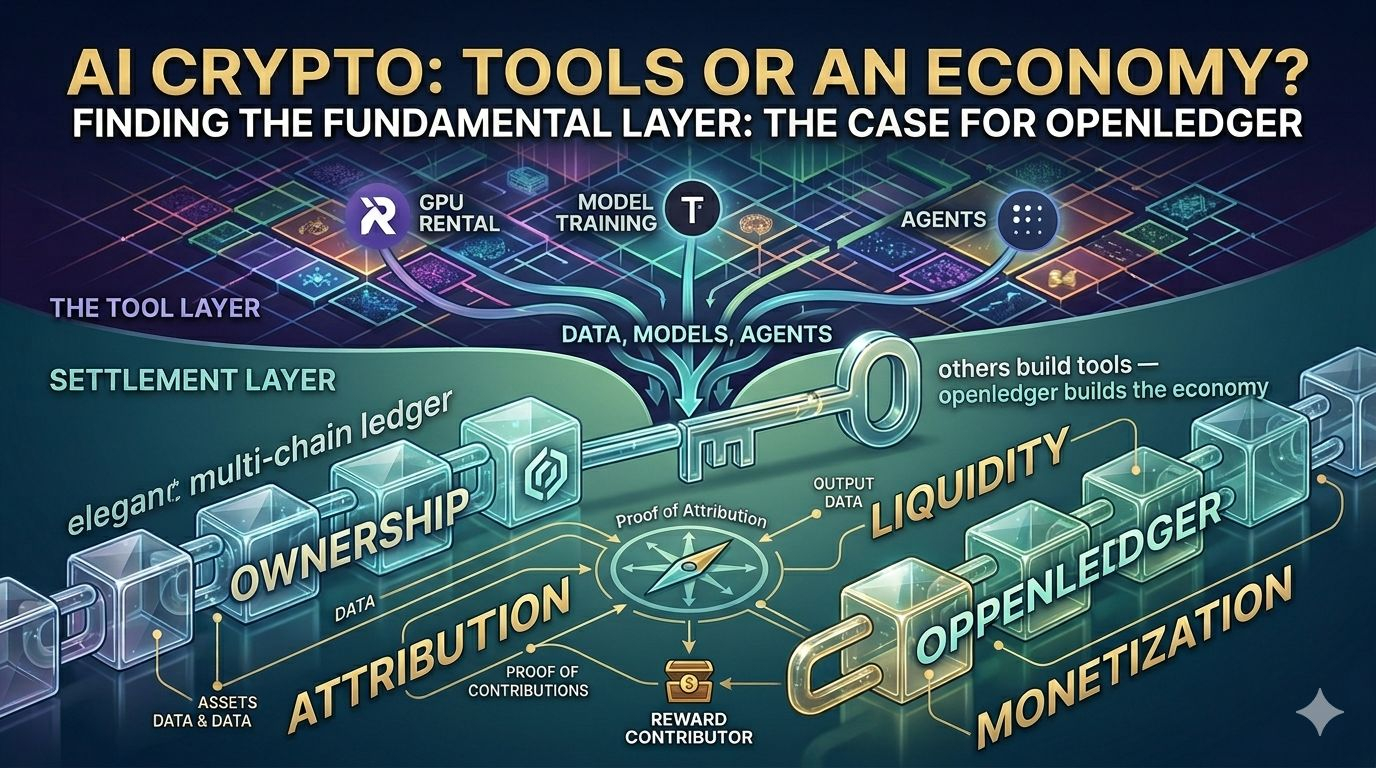
OpenLedger n'essaie pas d'être un autre réseau de GPU. Ce n'est pas juste un autre marché de modèles. Ce n'est pas juste une question d'agents. Il se positionne comme la couche de règlement pour la valeur de l'IA.
L'idée centrale est simple, mais c'est dangereux dans un bon sens : chaque ensemble de données, modèle, adaptateur et agent devient un actif vérifiable, attribuable et compensable sur la chaîne. Grâce à quelque chose appelé Preuve d'Attribution, il trace comment les données influencent les résultats et récompense automatiquement les contributeurs. La chaîne compatible EVM permet aux modèles et agents formés d'être échangés, combinés et appelés facilement.
En d'autres termes : OpenLedger veut transformer l'IA en une économie liquide d'intelligence, où la valeur retourne aux contributeurs, pas seulement aux personnes qui possèdent les modèles. D'ici 2026, il est déjà listé sur Binance avec une offre en circulation d'environ 215,5 millions OPEN sur 1 milliard au total, se négociant autour de 0,18 $.
Quand je compare cela aux autres grands acteurs, les différences commencent à se préciser...
Bittensor est tout au sujet de l'entraînement de modèles décentralisé et de la compétition d'intelligence via des sous-réseaux. C'est plus une question d'entraînement collectif et de calcul/intelligence général. OpenLedger, en revanche, est plus comme la couche de règlement pour la réalisation de la valeur de l'IA. Bittensor demande "Comment entraînons-nous des modèles collectivement ?" tandis qu'OpenLedger demande "Comment les données, les modèles et les agents deviennent-ils des actifs négociables, monétisables et attribuables ?". OpenLedger ne tente pas de surpasser Bittensor sur l'intelligence brute. Il trace un créneau différent : la monétisation des données et la conformité des entreprises. Je ne suis pas encore pleinement convaincu que cela battra l'effet de réseau de Bittensor… mais l'angle est assez différent pour que les deux puissent coexister.
Fetch.ai est fort dans les agents IA autonomes et les systèmes multi-agents pour des tâches comme l'optimisation de la chaîne d'approvisionnement ou le trading d'énergie. C'est plus comme un middleware où les agents interagissent sur les marchés. OpenLedger va plus loin : il veut intégrer l'ensemble du cycle de vie sur la chaîne, pas seulement l'interaction des agents. Fetch.ai est la "couche d'agents", tandis qu'OpenLedger se présente comme la couche de liquidité. Si Fetch.ai concerne les agents interagissant sur les marchés, OpenLedger concerne les modèles, les données et les agents comme une économie liquide où tout est attribuable et monétisable. C'est une affirmation audacieuse. Je suis curieux, pas convaincu.
Render est un réseau de location de GPU. Il résout la distribution de calcul brut. OpenLedger n'est pas un autre réseau de GPU. Il s'attaque à la couche de responsabilité. Render dit "Voici la puissance GPU." OpenLedger dit "Voici la couche où les contributions sont reconnues, les résultats sont vérifiables, et la valeur est attribuée." Ils ne sont pas des concurrents directs. En fait, OpenLedger s'associe à io.net pour le calcul GPU, ce qui touche l'espace de Render mais ajoute de la liquidité et de l'attribution par-dessus. Donc, la question devient : quelle couche est plus fondamentale à long terme ? Le calcul, ou la couche économique/attribuable ?
Je dois être honnête ici… il y a beaucoup de pièces mobiles pour OpenLedger. Vous avez besoin d'une Preuve d'Attribution qui fonctionne réellement à grande échelle, d'un marché de modèles fonctionnel où les gens échangent des modèles et des adaptateurs, d'une véritable monétisation pour les contributeurs de données, et d'une adoption par les entreprises pour l'IA explicable et les sources de données conformes. C'est beaucoup.
Mais voici le vrai point… d'ici 2026, de plus en plus d'entreprises vont avoir besoin d'IA explicable et de sources de données conformes. Elles ne peuvent plus simplement prendre des données aléatoires sur Internet et entraîner des modèles. Elles ont besoin de transparence, d'auditabilité et de propriété claire. La combinaison transparente + liquide d'OpenLedger pourrait attirer des applications dans le monde réel, pas seulement des fonds spéculatifs. En bâtissant sur l'OP Stack comme un Layer 2 Ethereum, c'est aussi compatible EVM, ce qui signifie que les développeurs peuvent réellement construire dessus sans apprendre un langage complètement nouveau.
Pourtant, l'exécution est tout. Si l'équipe ne peut pas livrer un marché de modèles fluide, une attribution réelle et une liquidité effective, cela devient un autre rêve de livre blanc. Je regarde de près, mais je ne suis pas encore pleinement convaincu.
Mais si OpenLedger réussit vraiment… ce serait l'infrastructure financière de l'économie de l'IA, pas juste un autre marché. Pensez-y : les données deviennent un actif négociable avec une propriété claire. Les développeurs peuvent monétiser des modèles directement sur la chaîne. Les institutions obtiennent une couche de déploiement IA conforme et évolutive. Les ponts de liquidité inter-chaînes relient des écosystèmes fragmentés. C'est plus qu'un token. C'est une passerelle vers l'économie IA multi-chaînes. Si cela se produit, $OPEN pourrait devenir un projet de premier plan dans le secteur IA + Web3, similaire à la façon dont Ocean Protocol et Bittensor ont défini leurs niches. Le récit sous-jacent est fort : D'autres construisent les outils — OpenLedger construit l'économie. Et c'est soutenu par Polychain Capital, ce qui me dit au moins que des investisseurs sérieux portent attention.
Je n'ai pas de réponse claire. Bittensor a un effet de réseau et une couche d'entraînement solide. Fetch.ai pousse les agents fort. Render possède le créneau du calcul GPU. OpenLedger parie sur l'attribution + la liquidité comme la couche manquante.
La question revient sans cesse… quelle couche est plus fondamentale à long terme ? Le calcul brut ? L'entraînement collectif ? Les agents autonomes ? Ou la couche économique qui rend les données, les modèles et les agents liquides et attribuables ?
Je penche vers l'idée que, si l'économie de l'IA se développe vraiment, la couche économique/attribution devient aussi critique que le calcul lui-même. Peut-être même plus. Parce que les outils deviennent des commodités. Mais l'économie autour d'eux ? C'est là que la valeur se fixe.
Mais je ne sais pas encore si OpenLedger sera celui qui possédera cette couche… ou si quelqu'un d'autre les surpassera. Tout ce que je sais c'est : les projets qui se concentrent uniquement sur les outils, pas sur l'économie qui les entoure, pourraient finir par devenir une infrastructure de commodités. Ceux qui résolvent la propriété, l'attribution et la liquidité… pourraient être les vrais gagnants.
Je réfléchis encore à cela. Je continue de regarder. Et honnêtement, c'est là où je suis le plus à l'aise—curieux, sceptique, mais impliqué.
#bitcoin #crypto #Binance #CryptoExchangeNews $BTC