

Il y a quelques années, je pensais que la ressource la plus importante en IA était la puissance de calcul.
Celui qui a le plus de puissance de traitement gagnerait. Cette hypothèse semblait évidente à l'époque. Récemment cependant, je me suis surpris à prêter attention à quelque chose de beaucoup moins excitant. Pas à l'intelligence. Pas même à l'exactitude.
Ou plus précisément, que se passe-t-il lorsque la mémoire des machines commence à se comporter différemment de celle des humains.
Les humains oublient des choses tout le temps. Nous oublions des conversations, des détails, des noms, des erreurs. Parfois, oublier est sain. Des systèmes juridiques entiers sont construits autour de la limitation de la durée pendant laquelle certaines informations suivent les gens. Mais quand une économie oublie des informations importantes, les conséquences peuvent être étonnamment coûteuses.
Cette distinction me trotte sans cesse dans la tête quand j’observe l’infrastructure de l’IA.
La plupart des gens parlent encore de l’IA comme si le problème central était de produire de meilleures réponses. Pourtant, plus j’observe les entreprises expérimenter avec l’IA, moins je suis convaincu que de meilleures réponses soient le goulot d’étranglement réel. Dans bien des cas, le problème survient après que la réponse a été générée.
D’où vient cette information ?
Qui y a contribué ?
Est-ce que quelqu’un peut vérifier ?
Et surtout, si quelque chose tourne mal six mois plus tard, est-ce que quelqu’un pourra reconstituer ce qui s’est passé ?
Ces questions semblent ennuyeuses jusqu’à ce que l’argent entre en jeu.
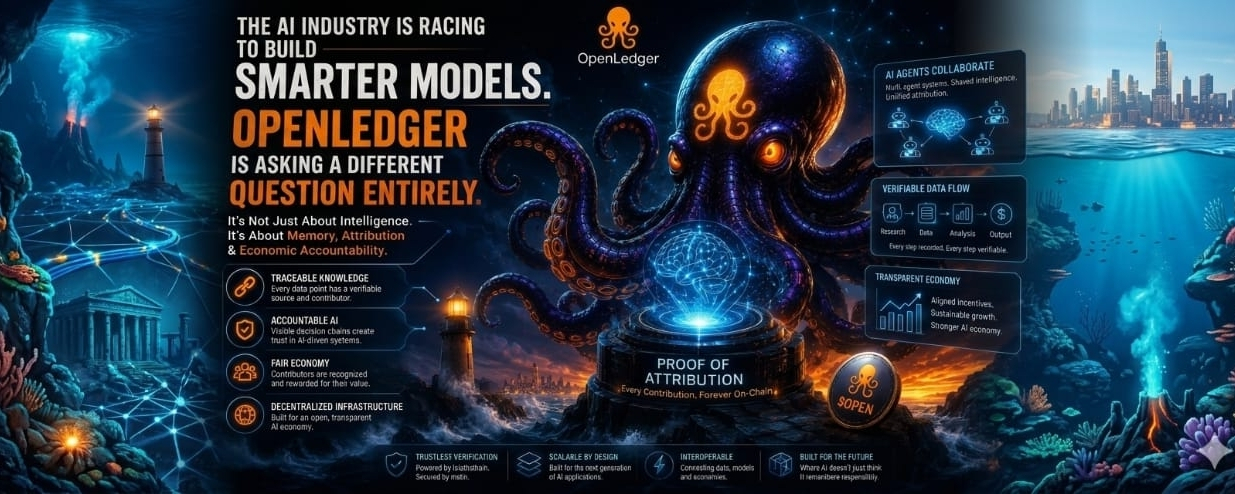
Beaucoup de projets d’IA se livrent une compétition pour la course à l’intelligence. Des modèles plus rapides. Un meilleur raisonnement. Un entraînement plus efficient. @OpenLedger se semble regarder ailleurs. Presque sous l’IA elle-même.
D’après la façon dont je l’interprète, le projet pose une question étrange : et si la ressource rare n’était pas l’intelligence, mais la connaissance traçable ?
Au début, je me suis dit que cela ressemblait à un exercice de branding autour de la propriété des données. Plus j’y réfléchissais, moins cette explication me mettait à l’aise.
Parce qu’une fois que les systèmes d’IA commencent à interagir entre eux, la chaîne de connaissances devient rapidement chaotique. Imaginez dix systèmes d’IA contribuant à une seule sortie. L’un fournit de la recherche. Un autre fournit des données de marché. Un autre ajoute des archives historiques. D’autres encore apportent des mécanismes d’analyse, de filtrage ou de classement. Finalement, une réponse apparaît. Tout le monde voit la réponse. Presque personne ne voit le chemin. Ce chemin caché pourrait finir par compter davantage que la sortie finale.
Je me souviens avoir lu au sujet d’une institution financière qui testait des flux de travail assistés par l’IA. Ce qui m’intéressait n’était pas de savoir si le modèle produisait des sorties utiles. C’était plutôt la discussion de conformité qui suivait. L’organisation ne demandait pas si l’IA était intelligente. Elle cherchait à savoir si, le cas échéant, elle pouvait expliquer le processus de prise de décision aux régulateurs. Cela ressemble à une catégorie de problème tout à fait différente.
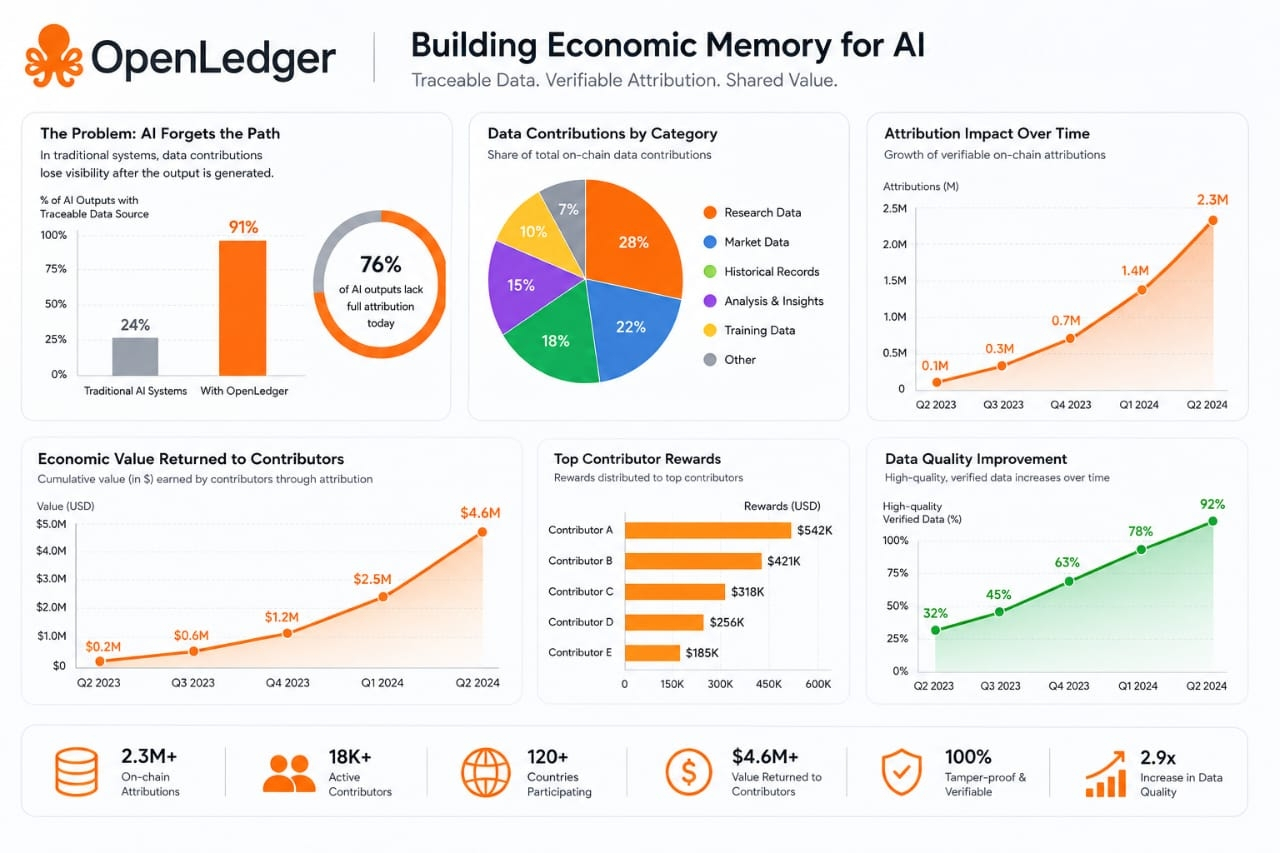
Une économie peut tolérer une intelligence imparfaite pendant une durée surprenamment longue. Ce qu’elle a du mal à tolérer, c’est une responsabilité invisible.
C’est en partie pour cela que OpenLedger a retenu mon attention.
Dans les chaînes d’approvisionnement, les registres de provenance comptent parce que les entreprises doivent savoir d’où viennent les produits. En santé, la documentation existe parce que la mémoire ne peut pas être fiable à elle seule. Pourtant, une grande partie de l’IA fonctionne encore comme si l’attribution était optionnelle. Je trouve cela étrange. Nous construisons des systèmes qui influencent de plus en plus des décisions économiques tout en traitant la traçabilité de l’information comme une infrastructure secondaire. Peut-être que c’est acceptable tant que l’IA reste un outil de productivité. Je suis moins certain si l’IA devient elle-même un participant à l’activité économique.
La thèse d’OpenLedger devient plus intéressante à travers ce prisme.
Si les contributions de données restent traçables, la connaissance n’entre pas simplement dans un modèle puis disparaît. Les contributeurs peuvent potentiellement rester connectés à la création de valeur en aval. Plus important encore : les chaînes de décision deviennent observables. La preuve d’attribution, le mécanisme central, enregistre chaque contribution de données comme un état permanent et vérifiable sur la chaîne. Pas dans une base de données privée d’une entreprise. Pas dans un journal qui peut être révisé discrètement. Sur un registre dont l’exactitude dépend des mathématiques, et non de la bonne volonté institutionnelle.
Le problème plus large pourrait être la mémoire économique.
Quand un système perd la trace de l’origine de la connaissance, il perd progressivement sa capacité à distinguer le signal du bruit. Les contributeurs de haute qualité deviennent plus difficiles à identifier. Les mauvaises informations et les bonnes informations commencent à concourir sur un pied presque égal. Finalement, les incitations dérivent. Ce processus est lent. Presque invisible. Puis, d’un coup, tout le monde remarque que la qualité se dégrade.
J’ai vu des schémas similaires en dehors de l’IA. Les marchés financiers passent souvent des années à optimiser l’efficacité avant de découvrir qu’ils ont supprimé par inadvertance la transparence. Les plateformes sociales optimisent l’engagement avant de réaliser qu’elles ont affaibli leur crédibilité. Les systèmes ne cassent que rarement d’un seul coup. Ils dérivent. L’infrastructure de l’IA pourrait faire face à quelque chose de similaire.
Pourtant, je ne pense pas que le chemin d’OpenLedger soit simple. Il y a un compromis ici, dont on ne parle vraiment pas. Tout le monde soutient la redevabilité en théorie. Elle devient beaucoup plus ténue quand la redevabilité crée une charge opérationnelle. C’est pourquoi je ne vois pas OpenLedger comme un vainqueur garanti. Ce qui m’intéresse, c’est la direction même du pari.
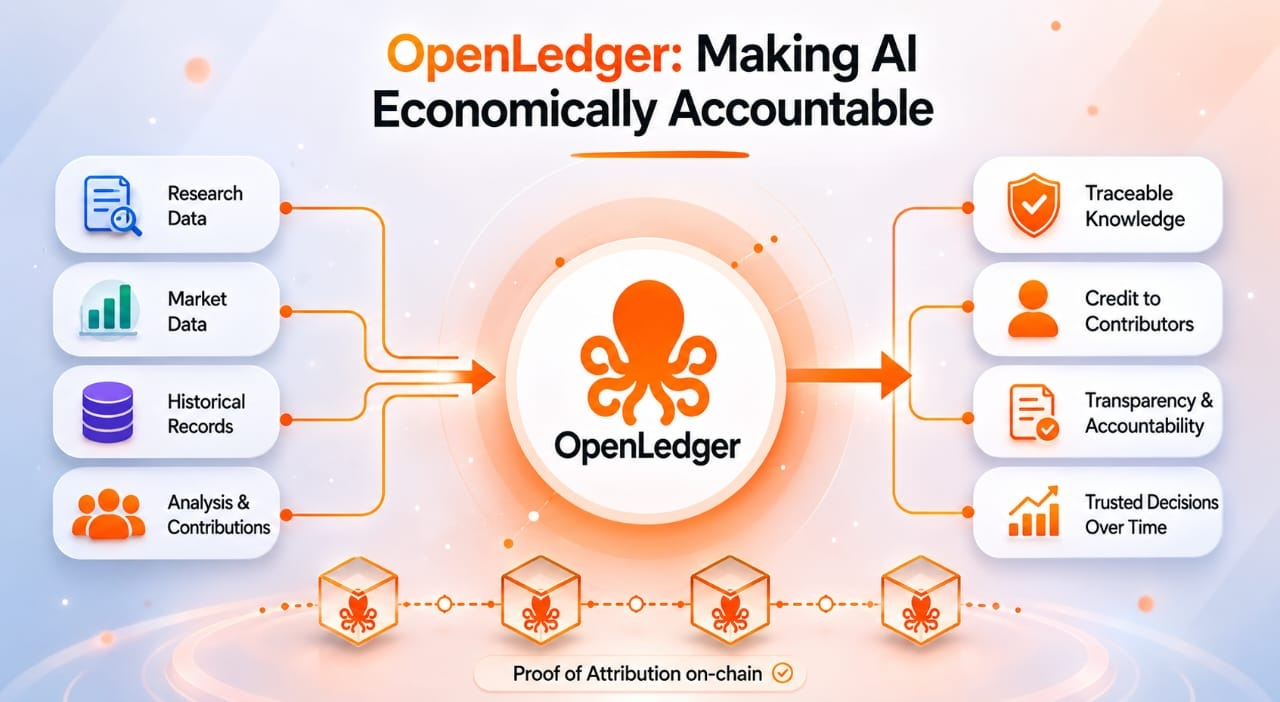
L’industrie est obsédée par le fait de rendre l’IA plus intelligente. OpenLedger semble plutôt s’intéresser à rendre l’IA économiquement redevable. Ce ne sont pas les mêmes objectifs. Et je continue à me demander si le marché se concentre sur la mauvaise rareté.
Le calcul devient moins cher avec le temps. Les modèles s’améliorent. Les coûts d’inférence baissent. Mais des enregistrements dignes de confiance ont une étrange tendance à devenir plus précieux quand les systèmes deviennent plus complexes.
Peut-être que l’oubli de l’IA ressemble aujourd’hui à une simple gêne technique. Un problème produit. Quelque chose que les ingénieurs finiront par résoudre. Ou alors l’oubli devient la source de risque cachée que personne ne remarque jusqu’au moment où l’ensemble des marchés pilotés par l’IA dépend de se souvenir de qui a contribué quoi, quand et pourquoi.
C’est le pari qu’OpenLedger fait.
Je trouve cela plus intéressant que la plupart des paris qui sont faits
