

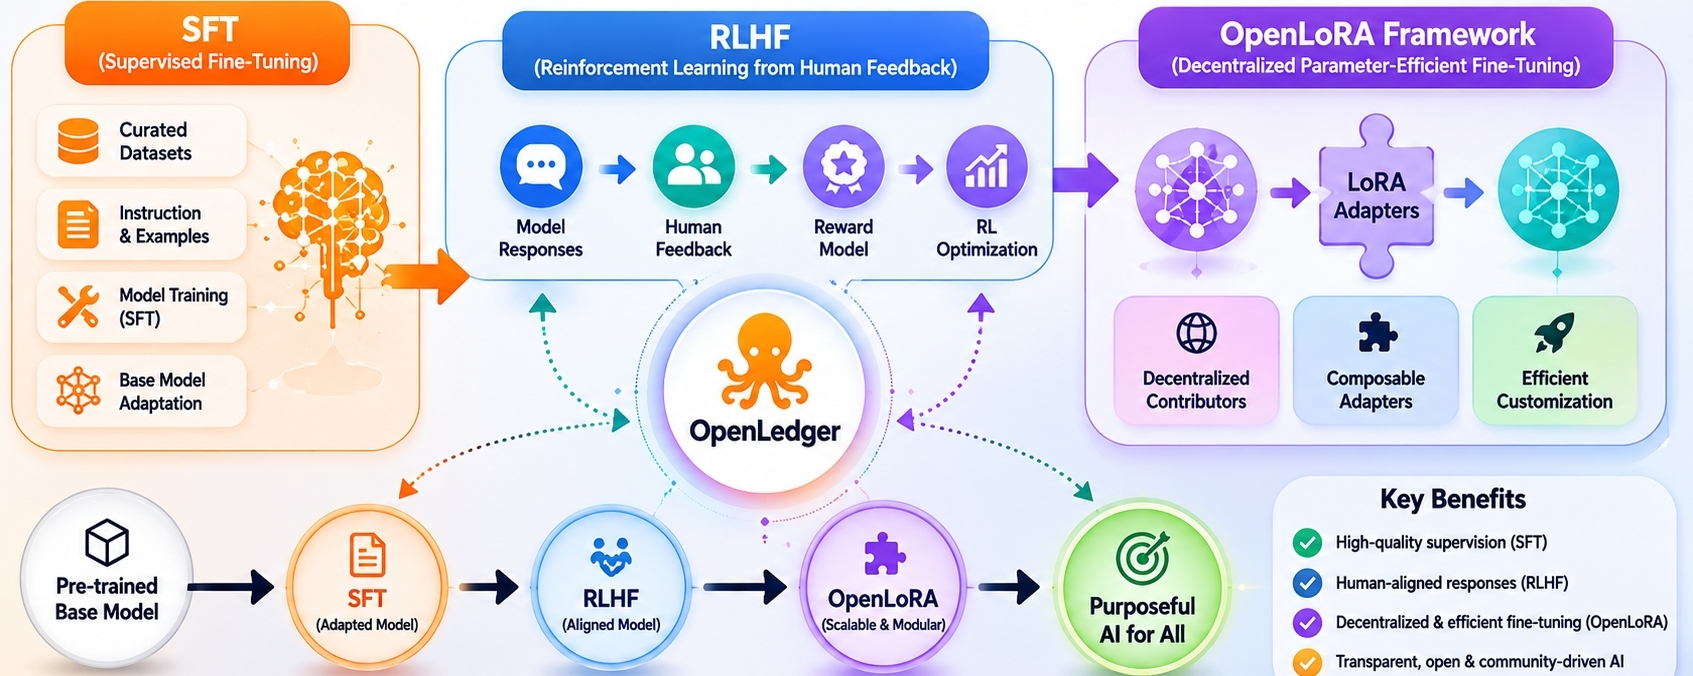
Ce qui attirait mon attention vers OpenLedger, ce n'était pas la qualité du modèle. C'était la question de savoir où se situe réellement le frottement d'alignement une fois qu'un système dépasse l'entraînement d'un seul modèle et commence à coordonner des contributeurs, des validateurs, des ensembles de données et des boucles de rétroaction à grande échelle.
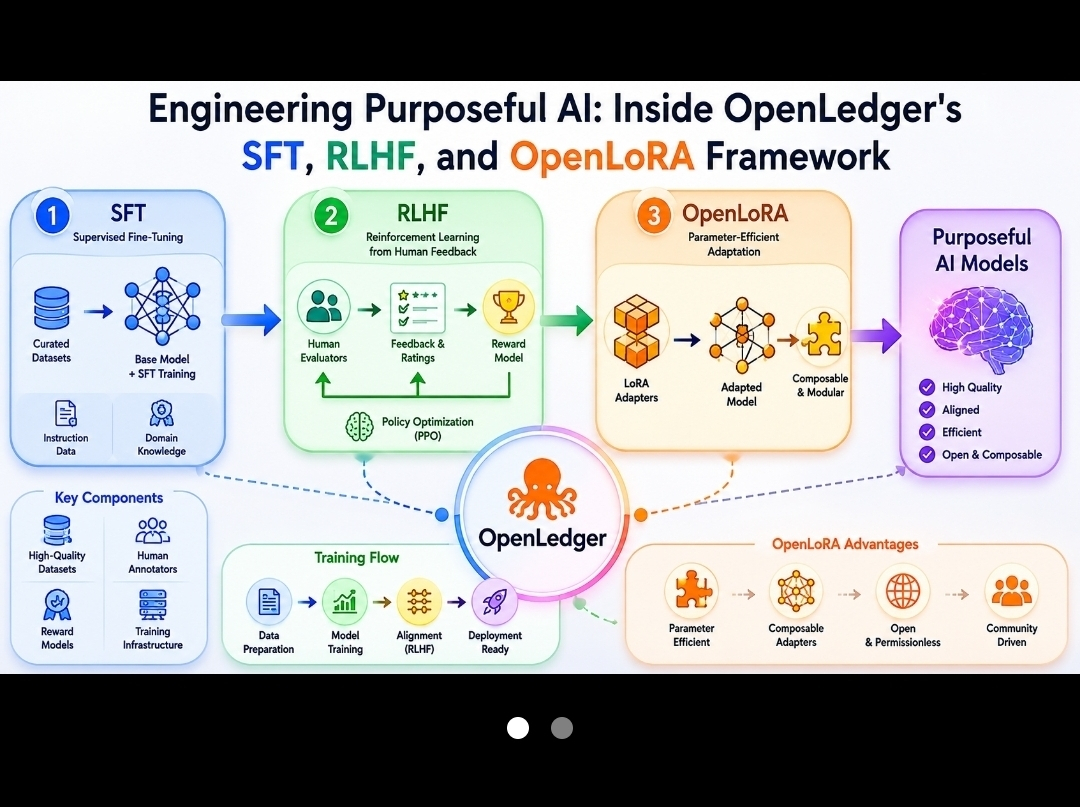
À l'intérieur d'OpenLedger, le problème intéressant n'est pas de savoir si SFT, RLHF ou OpenLoRA fonctionnent individuellement. La plupart des gens acceptent déjà qu'ils fonctionnent. La question plus difficile est ce qui se passe lorsque ces mécanismes deviennent partie intégrante d'un environnement de production partagé où plusieurs acteurs façonnent en continu le comportement du modèle.
C'est là que la tension opérationnelle commence.
Un modèle peut sembler fiable pendant l'évaluation et devenir pourtant étonnamment instable une fois que les voies de réglage fin se multiplient. Chaque nouveau jeu de données introduit des préférences. Chaque contributeur introduit des hypothèses. Chaque optimisation pousse discrètement le modèle vers une version différente d'utilité.
Le défi n'est pas de créer de l'intelligence.
Le défi est de préserver l'intention tout en modifiant l'intelligence.
Je continuais à remarquer cela en regardant comment OpenLedger combine le réglage fin supervisé, le renforcement de l'apprentissage par retour humain et l'adaptation modulaire via OpenLoRA. Sur le papier, ces composants semblent complémentaires. En pratique, ils créent des pressions concurrentes qui doivent être gérées quelque part.
Prenez d'abord SFT.
La plupart des gens considèrent le réglage fin supervisé comme la phase simple. Des exemples soigneusement sélectionnés sont introduits. Un meilleur comportement en ressort. La réalité est plus complexe. Une fois que plusieurs contributeurs commencent à fournir des données d'entraînement, le problème passe de la qualité à la cohérence.
Imaginez deux contributeurs résolvant la même tâche de support client. L'un récompense la brièveté. L'autre récompense les explications exhaustives.
Aucun jeu de données n'est nécessairement incorrect.
Mais lorsque les deux entrent dans le pipeline d'entraînement, le modèle commence à apprendre des définitions conflictuelles du succès.
Le mode de défaillance est subtil. Les sorties restent techniquement correctes tout en devenant opérationnellement imprévisibles.
Un utilisateur pose la même question deux fois et reçoit des styles de réponse dramatiquement différents.
Rien ne semble cassé.
Pourtant, la confiance commence à s'éroder.
C'est ici que l'accent mis par OpenLedger sur l'attribution devient plus intéressant que l'entraînement lui-même. Si un changement comportemental particulier apparaît après l'introduction de jeux de données spécifiques, tracer l'influence devient possible plutôt que spéculatif.
Le risque réduit n'est pas l'hallucination.
C'est l'ambiguïté sur l'origine de la dérive comportementale.
Cela semble petit jusqu'à ce que le débogage commence.
Sans attribution, chaque réponse inattendue du modèle devient une histoire de détective.
Avec attribution, l'enquête devient plus étroite et moins coûteuse.
Cependant, l'attribution introduit son propre coût. Les contributeurs deviennent des participants visibles dans le comportement du modèle. La visibilité crée une responsabilité, mais elle crée aussi de l'hésitation. Certains contributeurs deviennent plus conservateurs car leur influence peut être mesurée.
Ce compromis semble réel.
Une meilleure traçabilité signifie souvent une expérimentation plus lente.
Alors le RLHF entre en jeu et les choses deviennent encore moins claires.
Le retour humain est généralement présenté comme la couche d'alignement. La phase où les modèles apprennent ce que les gens préfèrent réellement.
Je ne suis pas entièrement convaincu que ce soit si simple.
Le retour humain capture souvent la satisfaction immédiate plus efficacement que l'utilité à long terme.
Cette distinction est importante.
Considérez un scénario où deux réponses répondent à la même question.
La confiance devient un raccourci.
Au fil du temps, la pression d'optimisation peut pousser les modèles vers des réponses qui semblent meilleures avant de devenir plus véridiques.
OpenLedger ne peut pas complètement éliminer cette tension car aucun cadre ne peut le faire. Ce qu'il peut faire, c'est exposer davantage le processus d'alignement au lieu de le cacher derrière un pipeline centralisé.
Cela crée un test intéressant.
Si deux groupes de feedback ne s'accordent pas sur les résultats préférés, quelles préférences devraient dominer ?
Il n'y a pas de réponse évidente.
Je soupçonne que beaucoup de gens pensent que la décentralisation résout automatiquement ce problème.
Je ne suis pas sûr que ce soit le cas.
Cela rend simplement le désaccord visible.
Et la visibilité est différente de la résolution.
Un exemple mécanique illustre cela clairement.
Supposons qu'un modèle reçoive 1 000 événements de feedback sur des tâches de raisonnement financier.
Sept cents récompensent les réponses concises.
Trois cents récompensent l'analyse détaillée des risques.
Le chemin d'optimisation dépend entièrement de la façon dont ces signaux sont pondérés.
La machinerie technique importe moins que les hypothèses de gouvernance qui y sont intégrées.
Finalement, quelqu'un décide de ce que signifie "meilleur".
Même si cette décision émerge collectivement.
La partie qui m'intéresse le plus est OpenLoRA car c'est là que la friction d'alignement devient tangible.
Le réglage fin traditionnel se comporte souvent comme le remplacement de pièces d'un moteur pendant qu'il fonctionne. Chaque modification porte la possibilité de conséquences non intentionnelles ailleurs.
OpenLoRA change l'unité d'adaptation.
Au lieu de modifier sans cesse de grands modèles de base, les contributeurs peuvent créer des adaptations spécialisées qui restent plus modulaires.
Cela semble être une amélioration pure jusqu'à ce que la réalité opérationnelle apparaisse.
Un système modulaire réduit une catégorie de défaillance tout en en créant une autre.
Maintenant, le défi devient la sélection.
Quelle adaptation devrait être utilisée ?
Quelle version devrait recevoir la priorité ?
La friction ne disparaît pas.
Ça bouge.
Je pense que ce mouvement est l'une des dynamiques les plus sous-estimées dans l'infrastructure de l'IA.
Les systèmes éliminent rarement la complexité.
Ils la relocalisent.
OpenLoRA semble relocaliser la complexité loin du réentraînement du modèle et vers la coordination du modèle.
C'est souvent un bon compromis.
Mais c'est toujours un compromis.
Imaginez deux LoRAs spécifiques à un domaine.
Un se spécialise dans le raisonnement juridique.
Un autre se spécialise dans le support client.
Individuellement, les deux fonctionnent bien.
Un flux de travail mixte nécessite soudainement des décisions sur le routage, la priorité, la compatibilité et l'évaluation.
La couche du modèle devient plus facile à mettre à jour.
La couche de coordination devient plus difficile à gérer.
Quel fardeau aimeriez-vous porter ?
Je pense sincèrement que des personnes raisonnables pourraient répondre différemment.
Cela explique aussi pourquoi la couche économique d'OpenLedger devient finalement pertinente.
Pas immédiatement.
Pas comme spéculation.
En tant qu'infrastructure.
Une fois que l'attribution, le retour et l'adaptation deviennent des activités mesurables, les incitations entrent inévitablement dans la conversation. Les contributeurs ont besoin de raisons de maintenir les jeux de données. Les validateurs ont besoin de raisons d'évaluer la qualité. Les fournisseurs de feedback ont besoin de raisons de participer honnêtement.
Finalement, le rôle du jeton OPEN émerge presque par nécessité car la coordination sans incitations a tendance à se dégrader sous l'échelle.
La question intéressante n'est pas de savoir si des incitations existent.
La question intéressante est de savoir si les incitations continuent à récompenser l'utilité après l'arrivée de la croissance.
L'histoire suggère que c'est là que de nombreux systèmes rencontrent des difficultés.
Ce qui me pousse à revenir à OpenLedger, ce n'est pas la promesse d'un développement d'IA ouvert. De nombreux projets promettent l'ouverture.
C'est la volonté d'exposer où les coûts d'alignement s'accumulent réellement.
Pas dans l'architecture du modèle.
Pas dans les scores de référence.
Dans l'espace désordonné entre les contributeurs tentant de façonner la même intelligence vers des objectifs légèrement différents.
Peut-être que le véritable test est étonnamment simple.
Si deux contributeurs également qualifiés entraînent le système vers différentes définitions de la qualité, le cadre peut-il révéler ce conflit avant que les utilisateurs ne subissent les conséquences ?
Et si cela peut, cette transparence améliore-t-elle les résultats ou rend-elle simplement le désaccord plus facile à observer ?
Je ne pense pas que la réponse soit encore tranchée.
Plus je regarde SFT, RLHF et OpenLoRA ensemble, moins ils semblent être des techniques d'optimisation et plus ils semblent être des mécanismes de négociation.
Une négociation entre jeux de données.
Une négociation entre préférences.
Une négociation entre ouverture et cohérence.
La plupart des systèmes d'IA cachent ces négociations derrière l'interface.
OpenLedger semble déterminé à les faire surface.
Que cela produise finalement une meilleure intelligence ou simplement plus de friction visible est encore quelque chose que je me trouve à tester.
