
En rangeant quelques anciens journaux de projets sur mon PC en soirée, je me suis arrêté pour feuilleter quelques pages de mes notes manuscrites sur le débogage de contrats intelligents. Les pages étaient remplies de courbes de consommation de gas et de pistes pour résoudre des échecs de synchronisation d'état dans divers cas extrêmes, ce qui m'a fait sourire. Au fil des ans, j'ai alimenté de nombreux outils avec mes expériences pratiques et mes données pour valider mes idées, mais j'ai découvert que les véritables expériences de base ayant de la valeur sont souvent facilement récoltées sur des plateformes centralisées, tandis que les contributeurs peinent à obtenir des retours justes. Ce sentiment me rend naturellement plus prudent vis-à-vis des projets qui prétendent vouloir reconstruire la valeur des données.
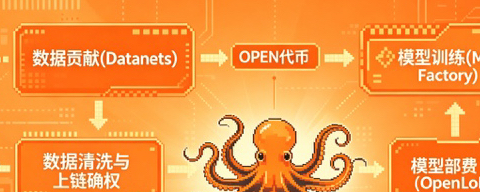
C'est dans cet état d'esprit que Kazi a récemment porté son attention sur OpenLedger, un projet qui commence à être mentionné dans la communauté. Au début, je n'avais pas de grandes attentes, ayant déjà vu trop de solutions qui s'affichaient comme AI mais ne faisaient que frapper à la surface. Mais après avoir pris quelques jours pour étudier sérieusement leur code de protocole central, en particulier le module de réseau de données décentralisé appelé Datanets, j'ai découvert qu'ils essaient effectivement de suivre un chemin plus pragmatique, en utilisant la blockchain pour faire en sorte que le flux de valeur dans le processus de raisonnement AI soit réellement réglé sur une chaîne vérifiable.
Le mécanisme AI payable qu'ils proposent repose sur un système d'identification cryptographique et une conception de contrats modulaires, permettant de suivre clairement chaque appel de modèle, contribution de données ou fourniture de puissance de calcul, et d'obtenir une compensation correspondante. Imaginez un développeur qui télécharge son module d'extraction de caractéristiques propriétaire sur le réseau ; si une équipe de quant utilise ce module pour aider à l'analyse des marchés, le protocole sous-jacent répartira automatiquement les frais en fonction du poids de contribution prédéfini et les fera circuler vers les adresses concernées. Ce type de conception est assez propre dans son principe, tentant de décentraliser le pouvoir de distribution qui était auparavant complètement monopolisé par de grandes plateformes, et de le transférer aux véritables contributeurs.
D'un point de vue d'ingénieur, ce qui m'impressionne le plus dans cette architecture est sa pensée modulaire. Datanets organise relativement indépendamment les couches de données, de modèles et de règlements, facilitant les itérations futures et les mises à niveau locales, de sorte qu'un problème à un niveau ne paralyse pas l'ensemble du système. J'ai moi-même exécuté plusieurs fois le processus d'appel de bout en bout sur le testnet selon la documentation ; la barrière à l'entrée n'est pas très basse, mais la logique est relativement claire. Pour ceux qui ont de l'expérience en Solidity et en systèmes distribués, il est possible de mettre en place les interactions de base en un jour ou deux, et une fois en fonctionnement, la latence et les performances des frais se sont révélées plus stables que je ne l'avais prévu. Bien sûr, ce n'est qu'un test à petite échelle ; les performances dans des scénarios de haute concurrence réels nécessiteront une observation plus longue.
Cependant, je suis conscient que toute tentative de ce genre ne peut échapper aux défis d'ingénierie de la réalité. Un mécanisme hautement dépendant des règlements en temps réel sur la chaîne, face à des tâches AI multimodales et de grande échelle, va rapidement amplifier la latence réseau et la pression de synchronisation des nœuds. J'ai déjà été pris au dépourvu lors de périodes de forte charge sur d'autres chaînes publiques, où des retards de confirmation fréquents et des fluctuations soudaines des frais ont perturbé de nombreux processus automatisés que j'avais initialement conçus. Si Datanets ne parvient pas à itérer continuellement sur l'extension des nœuds et l'optimisation du sharding, ce risque pourrait amener certains utilisateurs à préférer les services centralisés traditionnels.
De plus, actuellement, les types de données en circulation dans leur réseau sont encore relativement concentrés, principalement autour des enregistrements structurés liés à la finance et de certains ensembles d'entraînement publics. Cela peut certes rendre la validation précoce plus ciblée, mais cela signifie également qu'il y a une distance évidente avant de soutenir des applications AI réellement diversifiées et intersectorielles. Si l'écosystème des développeurs ne parvient pas à se diversifier rapidement, en continuant d'injecter de nouvelles données de haute qualité, l'ensemble du cycle de distribution de valeur pourrait facilement tomber dans un cycle de faible activité, ne devenant qu'un petit nombre de nœuds autosuffisants.
Malgré ces problèmes potentiels, je garde un accord prudent avec cette direction. Récupérer le pouvoir de tarification de l'offre AI des mains de quelques géants et utiliser la technologie blockchain pour réduire le seuil d'accès des développeurs ordinaires à la monétisation de leurs ressources uniques est en soi une tentative qui mérite d'être sérieusement explorée. Au moins, cela offre une nouvelle voie aux personnes détenant des ensembles de données de niche ou des modèles optimisés.
Au cours des prochains mois, je prévois de continuer à surveiller leurs activités réelles sur la chaîne en tant qu'observateur : le volume réel des appels de contrats intelligents, la courbe de croissance des adresses de téléchargement de données indépendantes sur le réseau Datanets, ainsi que la stabilité des règlements inter-modules. Ces données seront plus honnêtes que n'importe quel livre blanc. Une fois la période d'observation écoulée, je déciderai de consacrer plus d'énergie en fonction des performances réelles. Dans l'ensemble, je reste prudemment optimiste quant à ce type d'exploration qui ancre la sincérité technologique au niveau du code — non pas parce que cela semble révolutionnaire, mais parce qu'il n'ignore pas la complexité du monde réel dans les détails d'ingénierie.