

Écoute, laisse-moi te dire un truc dès le départ - quand tu regardes ces types de systèmes, tu penses d'abord "tout est contrôlé, règles strictes, restrictions..." Mais si tu regardes de plus près, tu peux comprendre qu'ici ce n'est pas vraiment le chaos, mais plutôt une tentative de créer une structure intentionnelle - c'est exactement ça.
Si je parle la vérité du fond de mon cœur.... La façon dont je lis @OpenLedger la documentation, en une ligne - ce n'est pas juste une IA ou une plateforme de données, mais une expérimentation dans toute l'idée de comment les données peuvent être un "actif gagnant". Maintenant, décomposons cela parce que si tu mets tout ensemble, ça ne va pas tenir dans ta tête - ça ne va pas tenir du tout.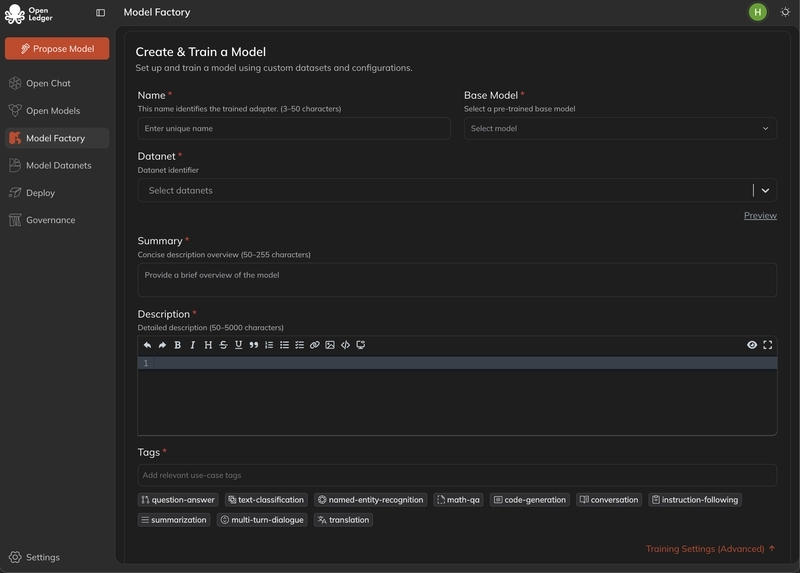
D’abord vient la couche Contribution des Datanets.
Le plus intéressant ici, ce sont les contraintes. Texte, images, audio — vous ne pouvez pas tout mélanger. Ça paraît un peu étrange, parce que quand on parle de Web3, on pense généralement à tout, sans autorisation. Mais ici c’est l’inverse — format rigoureux, validation rigoureuse. Limite de 10 MB par jour, 20 fichiers — ça aussi, ça ressemble à peu, mais en réalité ce n’est pas un contrôle anti-spam, c’est plutôt une tentative de garder un bon rapport signal-bruit. Parce que si c’était illimité, tout le monde contribuerait, mais il serait difficile de trouver de la valeur.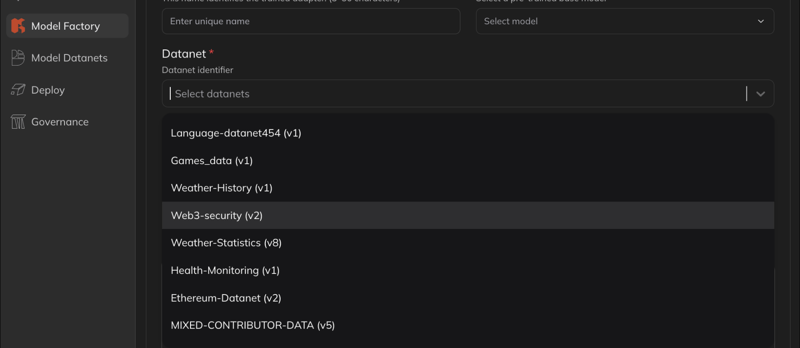
Un autre truc qui semble un peu drôle — le système de leaderboard.
Vous pensez peut-être « plus je fais des uploads, plus je vais monter » — mais non, absolument pas. Ici, ce n’est pas la quantité qui compte, mais le taux d’acceptation. Je veux dire, si vous donnez 10 données erronées, votre ego peut être content, mais le système ne se souciera pas de vous. Un peu dur, mais juste. Et la partie intéressante, c’est que les fichiers refusés ne font pas baisser le classement. C’est une conception étrangement saine. Parce qu’ici, l’expérimentation est encouragée, pas la contribution motivée par la peur.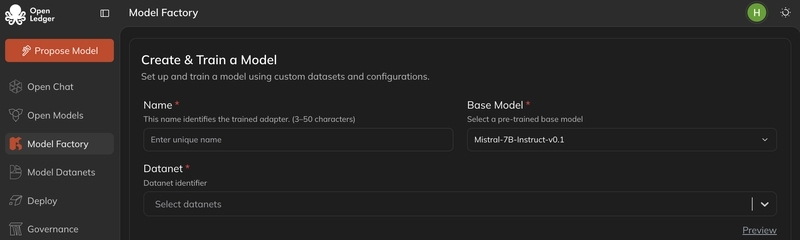
Ensuite, on a la mécanique de ModelFactory.
C’est en fait la partie la plus sérieuse d’OpenLedger. Ça change complètement la vibe ici. Ils essaient de transformer le fine-tuning des LLM en un flux de travail guidé par interface au lieu de le laisser juste comme un outil de recherche. Cela signifie que vous n’avez pas besoin d’être un guerrier du terminal. Taux d’apprentissage, taille de lot, époque — tout peut être ajusté visuellement. À première vue, ça semble — d’accord, c’est convivial pour les débutants, mais en réalité il y a une idée plus profonde derrière : démocratiser le développement de l’IA sans perdre le contrôle.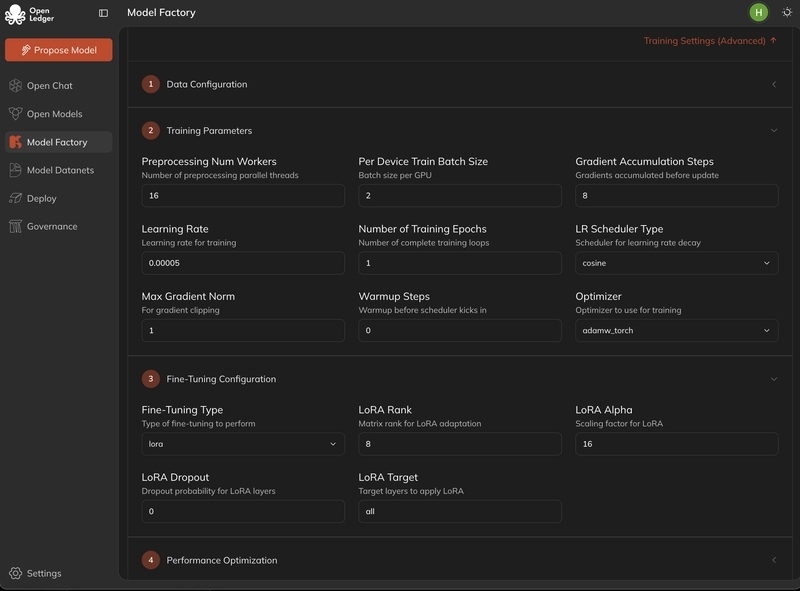
Le support de LoRA et QLoRA est une approche pratique ici. Parce que le fine-tuning complet coûte cher dans la réalité d’aujourd’hui. Donc ils suivent une voie d’adaptation légère. Un tableau de bord en temps réel et une interaction après l’entraînement — ce truc est assez intéressant, parce qu’ils veulent faire de l’entraînement des modèles une boucle continue sans point final. Cela signifie entraîner ⇨ tester ⇨ interagir ⇨ affiner.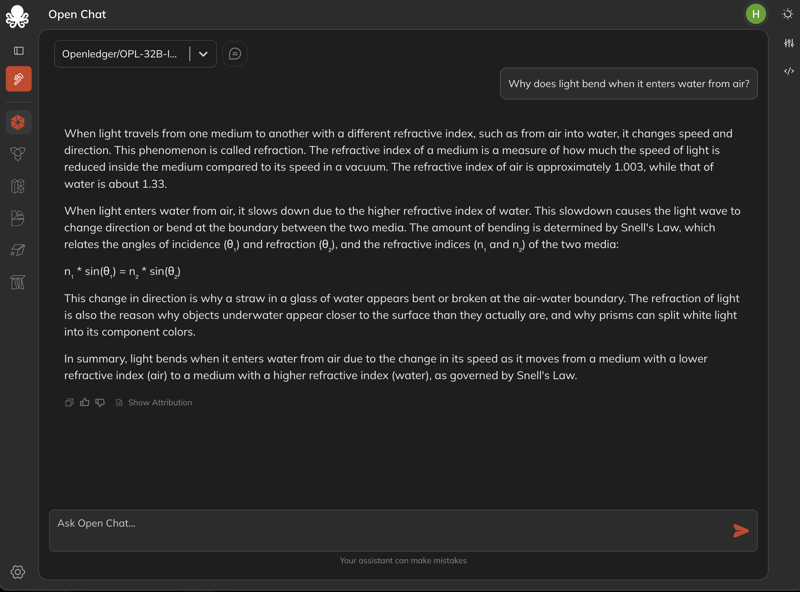
Parlons maintenant des LLM pris en charge.
Deepseek, Mistral, Qwen, la série LLaMA — tous les grands écosystèmes ouverts sont là. Même jusqu’au GPT-2, BLOOM, ChatGLM sont pris en charge. Au premier abord, ça peut sembler qu’ils ont tout inclus, mais en réalité c’est une stratégie de couverture de l’écosystème. Parce que si vous ne gardiez que des modèles d’élite, vous vous limiteriez. Mais un support large signifie un grand terrain pour l’expérimentation.
Maintenant, laissez-moi vous raconter une partie drôle
Une image me vient à l’esprit quand je vois tout ce système : une cuisine très disciplinée, où personne ne peut jeter des ingrédients au hasard. Mais quand la cuisson est terminée, tout le monde peut goûter et évaluer. Cela signifie que vous ne pouvez pas survivre ici uniquement avec de bonnes vibes, même si vous le voulez.
La dernière partie des Instructions de l’Agent est en fait la plus sous-estimée.
Parce qu’ici, on dit que pour des requêtes approfondies, des réponses dynamiques peuvent être obtenues en utilisant l’URL du GitBook. Ce ne sont pas essentiellement des documents statiques, mais plutôt un système de connaissance consultable.
Maintenant, si on pense à ça de façon générale, une chose devient claire..... @OpenLedger en fait, tout se situe entre deux tensions : d’un côté, la décentralisation + une contribution ouverte, de l’autre, une validation rigoureuse + une structure contrôlée. Ce n’est pas facile de garder ces deux éléments ensemble. Mais si l’équilibre est bon, alors on peut créer une vraie économie de données plutôt que du bruit. Et pour être honnête, c’est là que la question devient intéressante : les données seront vraiment un actif du futur, ou bien on essaie juste de résoudre un vieux problème de validation avec un nouveau nom ?
Je ne suis pas sûr qu’il y ait une réponse finale pour l’instant. Mais comme une couche d’expérimentation, ça ne vaut pas la peine d’ignorer... Mais vraiment🚀