

J'ai testé beaucoup de récits de "trading AI", et honnêtement, la plupart d'entre eux ressemblent à de jolis emballages autour de signaux vagues. Ils diront "sentiment haussier", "activité de gros capitaux", ou "momentum détecté par l'AI", mais quand je demande pourquoi, quelles données ont façonné cette réponse, ou comment le modèle a atteint cet appel, la piste disparaît généralement. C'est exactement là où OpenLedger me semble différent.
@OpenLedger ne cherche pas à être juste une autre chaîne polyvalente. Son idée principale est plus spécifique : construire une blockchain AI où les données, modèles, agents et contributeurs peuvent être suivis, attribués et monétisés. Ça sonne technique, mais l'angle trading est simple. Dans les marchés, un signal n'est aussi précieux que sa source. Si un agent AI me dit qu'un token semble solide, je ne veux pas juste la conclusion. Je veux savoir ce qui l'a alimenté : changements de liquidité, historique de gouvernance, influence sociale, déblocages de tokens, précédents d'exploits, mouvements de baleines, ou données d'échange en temps réel.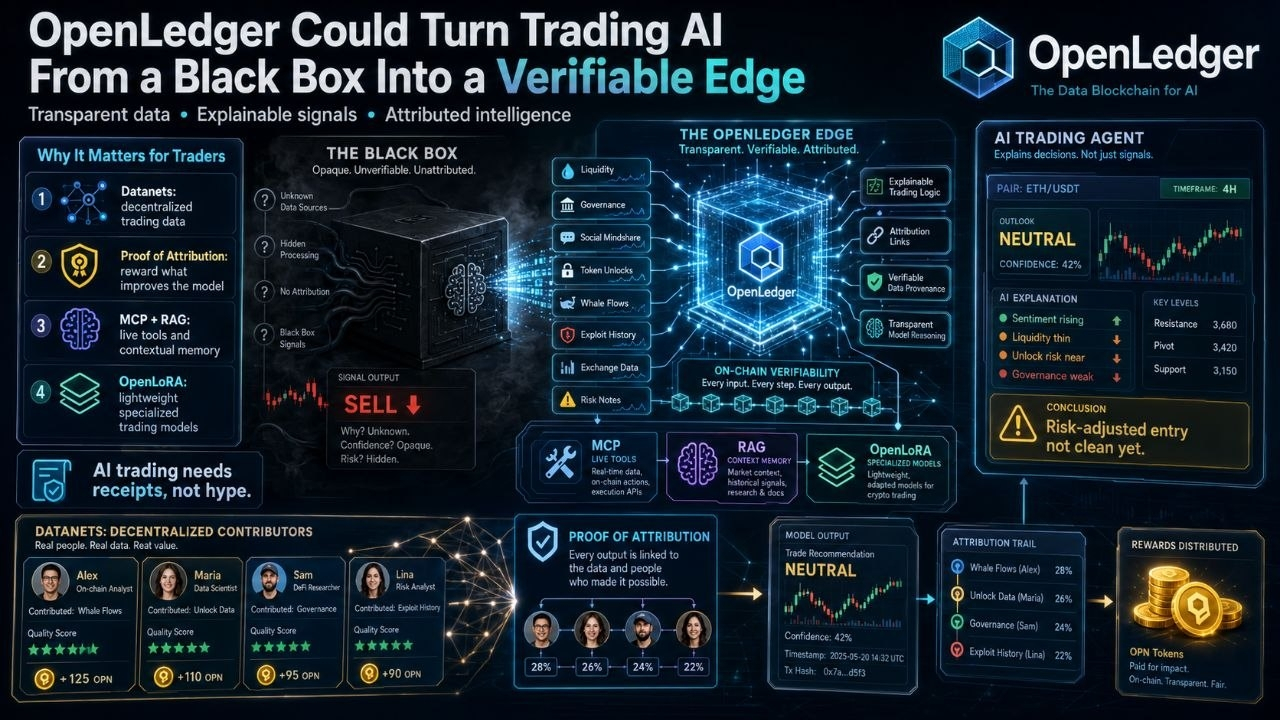
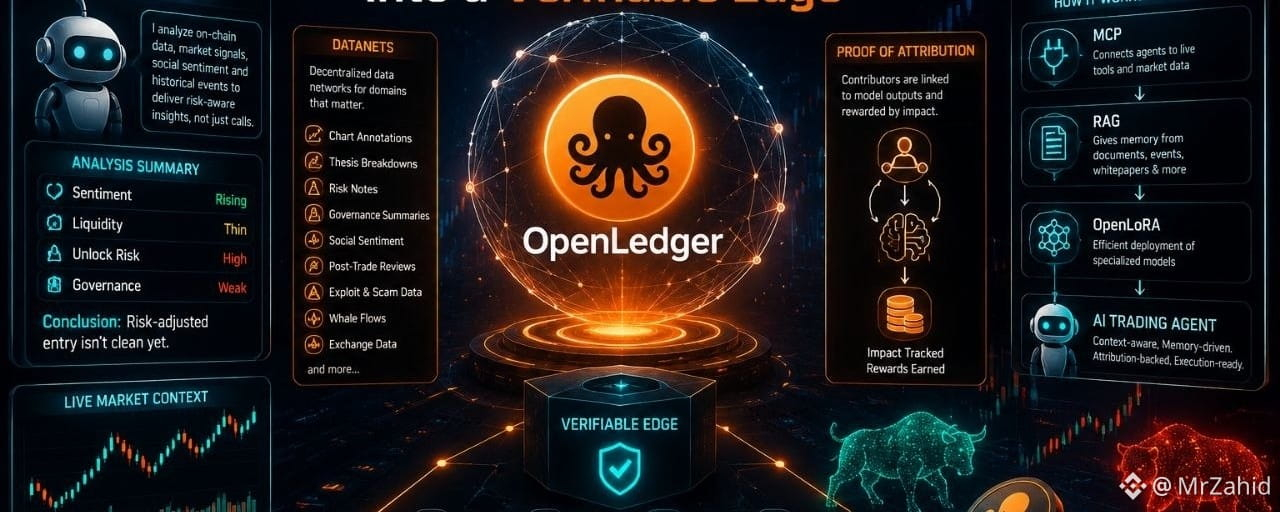
C’est pourquoi les Datanets d’OpenLedger comptent. Un Datanet est essentiellement un réseau de données décentralisé où les gens peuvent contribuer des ensembles de données spécifiques à un domaine, avec une attribution vérifiable. Pour le trading, cela pourrait signifier des annotations de graphiques, des décompositions de thèses, des notes sur le risque, de la recherche sur les tokens, le sentiment sur Discord, des résumés de gouvernance, ou des retours après exécution. Le “hot take” ? Le prochain grand modèle de trading ne viendra probablement pas d’une seule équipe secrète de quant. Il viendra de milliers d’observations humaines imparfaites mais utiles, nettoyées, validées et transformées en carburant pour le modèle.
La preuve d’attribution est la partie qui rend le tout moins extractif. Dans l’IA traditionnelle, les contributeurs alimentent souvent la machine et n’obtiennent rien en retour. Sur OpenLedger, les contributions peuvent être liées aux sorties du modèle et récompensées en fonction de leur impact. C’est énorme, parce que l’intelligence pour le trading s’accumule. Un bon avertissement sur la liquidité, une note d’ouverture exacte, un dataset historique de schémas frauduleux : tout cela peut façonner les décisions futures. Si cette influence est traçable, alors les données deviennent enfin un actif, pas seulement du travail gratuit.
Ma logique de trading ici est simple : je ne fais pas confiance à une IA qui ne fait que donner des “calls” ; je fais confiance à une IA qui explique les contraintes. Un agent de trading utile basé sur OpenLedger ne devrait pas crier “acheter”. Il devrait plutôt dire quelque chose comme : “le sentiment est en hausse, la liquidité est faible, le risque lié à l’ouverture est proche, la participation à la gouvernance est faible, donc l’entrée ajustée au risque n’est pas encore propre.” C’est comme ça que pensent les vrais traders. Pas le buzz d’abord. Le risque d’abord.
La vision MCP et RAG d’OpenLedger rend tout cela encore plus concret. MCP peut connecter des agents à des outils en temps réel comme des exchanges, des sources de liquidité ou des API de marché, tandis que RAG donne à l’agent de la mémoire à partir de documents, de propositions, de livres blancs et d’événements passés. Ajoutez OpenLoRA pour un déploiement de modèle spécialisé léger, et soudain l’agent n’est plus un chatbot statique. C’est un système de trading modulaire avec du contexte, de la mémoire, de l’attribution et une logique d’exécution.
Alors pourquoi est-ce que je surveille OpenLedger de près ? Parce que le trading assisté par IA n’a pas besoin de plus de mystère. Il lui faut des preuves. La promesse la plus forte d’OpenLedger, c’est de transformer les sorties de l’IA en quelque chose que les traders peuvent inspecter, remettre en question et évaluer. Et dans un marché saturé de bruit, une intelligence vérifiable pourrait devenir le véritable avantage.