

Regardez autour de vous dans l'espace Web3, et vous remarquerez un schéma répétitif, presque épuisant : la crypto adore traiter les problèmes comportementaux humains comme des tâches d'ingénierie simples.
Un nouveau projet émerge, balance un whitepaper lourd rempli de jargon architectural, et soudain tout le monde agit comme si un code propre pouvait magiquement réparer des incitations humaines cassées. Ça n'a jamais marché. Ça ne marchera jamais.
La vraie et moche vérité des économies numériques est beaucoup plus simple, mais bien plus difficile à résoudre : Les gens créent constamment de la valeur, mais les systèmes échouent constamment à suivre qui mérite réellement le crédit.
Le Web2 a maîtrisé cette relation extractive. Les utilisateurs ont généré les données, affiné les algorithmes avec leurs clics, et bâti le paysage numérique. Les plateformes ont capturé 99% du profit financier. Maintenant, l'Intelligence Artificielle entre dans la pièce, et cela rend cette crise de capture de valeur infiniment plus compliquée.
Parce que l'IA ne consomme pas seulement des données. L'IA consomme la contribution humaine.
La Boîte Noire de l'Intelligence Machine
Lorsque vous regardez un output d'IA—une ligne de code, une œuvre d'art numérique ou une stratégie de trading—vous regardez un produit final poli. Ce que vous ne voyez pas, c'est la machinerie chaotique et fragmentée en dessous.
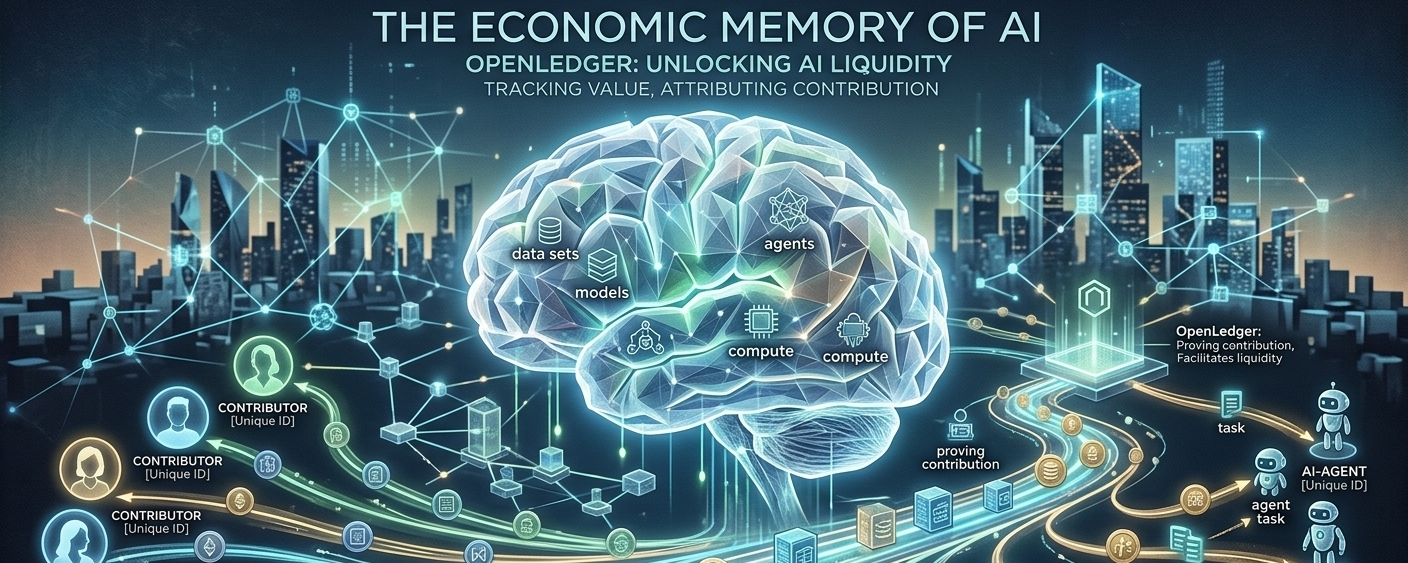
Un output d'IA est une collision de mondes séparés :
Injection de Données : Ensembles de données massifs curés par des milliers de mains individuelles.
Architecture de Modèle : Réseaux neuronaux conçus par des chercheurs.
Infrastructure de calcul : Matériel lourd traitant des données à une échelle immense.
Agents Autonomes : Entités spécialisées exécutant des micro-tâches.
Dans la fabrication traditionnelle, nous avons des chaînes d'approvisionnement. Un constructeur automobile sait exactement d'où vient chaque vis, morceau de cuir et microchip. La propriété a des frontières légales claires.
L'IA brouille complètement ces frontières. Elle prend des données de la Source A, un modèle du Créateur B, un calcul du Fournisseur C, et livre une expérience utilisateur parfaite où tous les contributeurs originaux sont rendus invisibles.
Ce n'est pas seulement un problème éthique ; c'est un énorme goulet d'étranglement économique. Les économies s'arrêtent lorsque les participants réalisent que leur contribution ne génère aucune récompense traçable.
Entrez OpenLedger : Construire une Couche de Coordination, Pas une Narrative
C'est exactement la plaie qu'OpenLedger essaie de panser. Ils ne lancent pas une autre narrative vide sur l'IA ou ne tentent pas de pomper une histoire de token temporaire. Ils posent une question beaucoup plus ennuyeuse—mais entièrement dangereuse :
Comment créer une mémoire économique autour de l'intelligence elle-même ?
Enlever les mots à la mode de la crypto, et la thèse centrale d'OpenLedger est simple : Les systèmes d'IA fonctionnent sur des entrées. Ces entrées proviennent de véritables contributeurs. Par conséquent, ces contributeurs doivent avoir une empreinte permanente et mesurable dans le cycle économique de cette IA.
Au lieu de laisser les ensembles de données, modèles et agents disparaître dans une boîte noire d'entreprise, OpenLedger se positionne comme une couche de coordination décentralisée. Elle traite ces éléments non pas comme des outils isolés, mais comme des participants économiques actifs et visibles.
Pensez-y comme à la logistique avant les chaînes d'approvisionnement modernes. Les usines, les navires et les matières premières ont toujours existé, mais la coordination était rompue. La valeur s'échappait partout à cause d'un manque de visibilité. OpenLedger n'essaie pas d'inventer l'intelligence IA ; elle essaie de l'organiser.
Le Piège des Tokenomics : Distinguer le Mouvement de la Traction
Mais soyons totalement francs. L'exécution dans cet espace est un champ de mines, et OpenLedger fait face à la même menace existentielle qui a détruit des dizaines d'écosystèmes Web3 prometteurs : la gamification des incitations.
La crypto a une mauvaise habitude de tomber amoureuse des métriques superficielles. Nous regardons les tableaux de bord Dune, examinons le volume des transactions, les comptes de wallets actifs et l'engagement explosif sur les réseaux sociaux, et nous nous convainquons qu'un projet est en train de gagner.
Nous avons déjà vu ce film. Nous l'avons vu avec le minage de liquidité DeFi. Nous l'avons vu avec le jeu Play-to-Earn (P2E). Les écosystèmes semblaient massifs jusqu'à ce que les récompenses s'épuisent—et puis les utilisateurs ont disparu du jour au lendemain. Ils ont confondu l'agriculture avec la demande réelle du marché.
Dès que vous rendez mesurable la contribution de données et d'IA, les utilisateurs changent d'état d'esprit. Ils arrêtent de demander "Comment puis-je contribuer quelque chose de vraiment utile ?" et commencent à demander "Comment puis-je manipuler l'algorithme pour maximiser mes c-114 récompenses ?"
Sur un registre blockchain, une ferme de bots sybillins et un contributeur de données humaines de haute qualité peuvent sembler terriblement similaires. Un volume faux peut masquer la santé du réseau tandis que la véritable utilité organique est noyée par le bruit.
Les Questions Impitoyables qu'OpenLedger Doit Répondre
Une technologie supérieure ne gagne que rarement le marché. La commodité, la vitesse et la simplicité le font. Si OpenLedger veut survivre au-delà de sa phase d'incitation initiale, elle doit répondre aux questions peu glamours que la plupart des projets axés sur le battage médiatique ignorent :
Qualité vs. Bruit : Comment le protocole filtre-t-il les données synthétiques, poubelles, conçues uniquement pour récolter des récompenses ?
Attribution Granulaire : Lorsqu'un modèle d'IA utilise 50 000 entrées de données différentes pour générer une seule sortie précieuse, comment fractionnez-vous équitablement les micro-récompenses ?
Confidentialité vs. Provenance : Comment suivez-vous la lignée et l'attribution des données sans compromettre la vie privée des utilisateurs ou révéler des données propriétaires ?
Afflux de Valeur Externe : Comment l'écosystème apporte-t-il des revenus externes durables afin que la valeur ne tourne pas simplement dans un cercle fermé et spéculatif ?
Le Verdict : Oublier Coûtera Cher
OpenLedger n'est pas un coup sûr garanti, mais ce n'est pas non plus une machine à hype vide. Elle occupe un terrain critique intermédiaire. Elle fait un pari macro à long terme que dans la prochaine décennie, l'intelligence elle-même deviendra une classe d'actifs liquide et négociable.
Si ce pari est correct, la manière traditionnelle de gérer les données d'IA est complètement insoutenable. Nous ne pouvons pas construire l'avenir de l'intelligence mondiale sur une base de contributions humaines non créditées et non suivies.
En fin de compte, le succès d'OpenLedger peut ne même pas être la principale histoire ici. La véritable leçon est que les futures économies d'IA exigeront absolument un système qui se souvient de qui les a construites. Car lorsque l'intelligence devient le principal moteur de la richesse mondiale, oublier qui y a contribué deviendra tout simplement trop coûteux.