Titre :
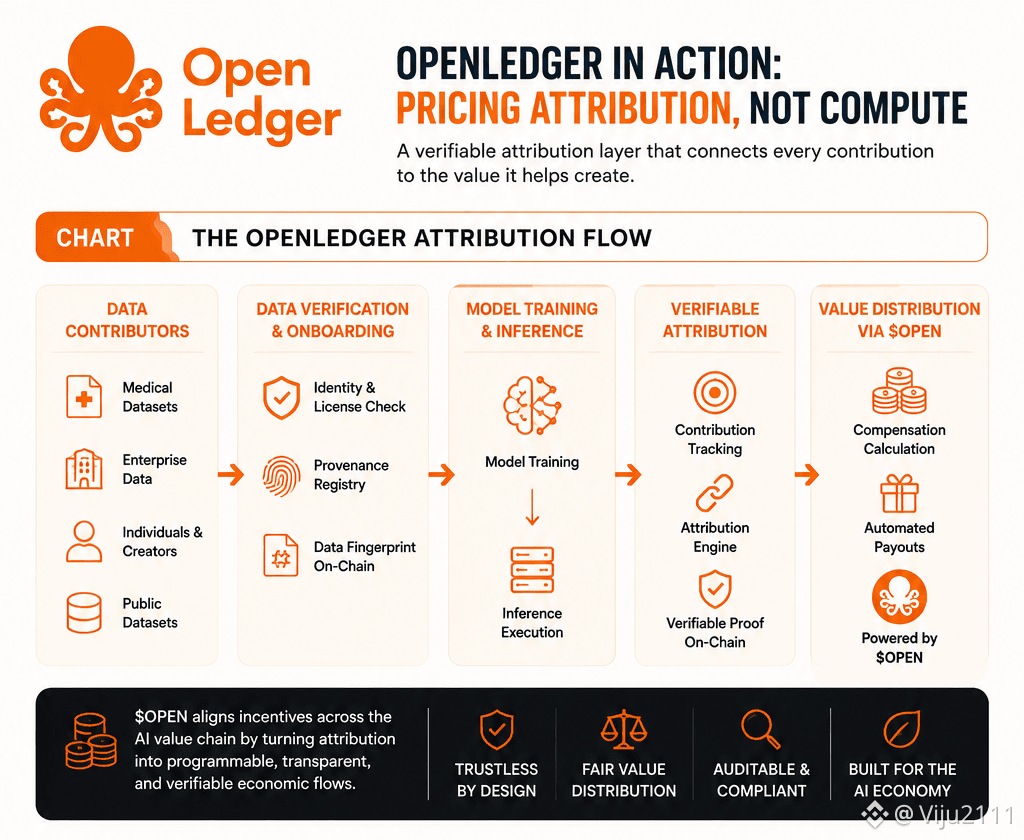
OpenLedger ressemble à une chaîne d'IA… Mais $OPEN pourrait en fait être une attribution de prix, pas de calcul 🧠🔍
Si vous regardez de près le paysage de l'IA décentralisée (DeAI), 90 % des projets se ressemblent. Ils se battent pour commoditiser la puissance de calcul—essentiellement en construisant des fermes de serveurs décentralisées pour louer des GPU. Mais OpenLedger ($OPEN) exécute discrètement un livre de jeu fondamentalement différent.
Bien qu'il ressemble, respire et agisse comme une blockchain IA hautes performances standard à la surface, son moteur économique central ne tarifie pas les cycles de calcul. Il tarifie l'attribution des données IA.
Voici pourquoi cette distinction compte pour la valeur future de $OPEN.
Le piège du calcul vs. le goulet d'étranglement des données
Louer des GPU (calcul décentralisé) est une course vers le bas. Les grandes entreprises technologiques construisent d'énormes centres de données centralisés, et les protocoles de calcul web3 se sous-cotent constamment les uns les autres en termes de prix. Le calcul est une commodité.
Cependant, les données ne le sont pas. Le plus grand goulet d'étranglement dans l'IA aujourd'hui n'est pas de trouver une carte graphique ; c'est d'acquérir des données de haute qualité, spécialisées et vérifiables pour entraîner des modèles. L'architecture d'OpenLedger—construite comme une infrastructure compatible EVM utilisant le OP Stack—se concentre entièrement sur ce pipeline de données. Grâce à ce qu'ils appellent les Datanets, les communautés peuvent co-créer, héberger et organiser des ensembles de données spécialisés sur la chaîne.
Entrez la Preuve d'Attribution (PoA)
C'est là que la physique du token $OPEN devient intéressante. Au lieu d'utiliser un mécanisme standard de Preuve de Travail ou de Preuve d'Enjeu simplement pour sécuriser les transactions, OpenLedger met en œuvre la Preuve d'Attribution (PoA).
💡 La Preuve d'Attribution est un mécanisme au niveau du protocole qui suit exactement comment un ensemble de données spécifique, LoRA, ou modèle de base influence la sortie finale d'un agent IA.
Lorsqu'un modèle IA est déployé ou qu'un agent IA répond à une requête, OpenLedger trace la filiation des données utilisées sur la chaîne. Si vos données contribuent à affiner ce modèle, le protocole le vérifie et s'assure que vous êtes crédité. @OpenLedger #OpenLedger