1. Des données nouvelles sont comme du pétrole, mais qui met l’argent dans sa poche ?
Saviez-vous que de gigantesques modèles d’IA comme ChatGPT ou Midjourney « gratuits » collectent chaque jour des données issues de vos propres publications, images et idées ? L’IA est en train de se concentrer de façon extrême sur la collecte des données. Les géants de la tech engrangent des milliards de dollars, tandis que les personnes qui créent directement ces données – les « batteries » qui alimentent l’IA – ne touchent pas un centime.
Pourquoi les nouvelles données sont l’or noir de l’IA, mais la propriété appartient à une minorité ? @Openledger apparaît pour inverser cette dynamique. Au-delà de simples promesses, le projet propose une infrastructure on-chain optimisée visant à redéfinir le jeu des données grâce à un mécanisme d’attribution des contributions (Attribution).
Disséquons ensemble l’architecture et la tokenomics pour voir si c’est réellement « la pièce maîtresse suprême » du récit Narrative AI x Web3 ou non.
2. Qu’est-ce qu’OpenLedger ? Redéfinir l’infrastructure de données pour l’IA
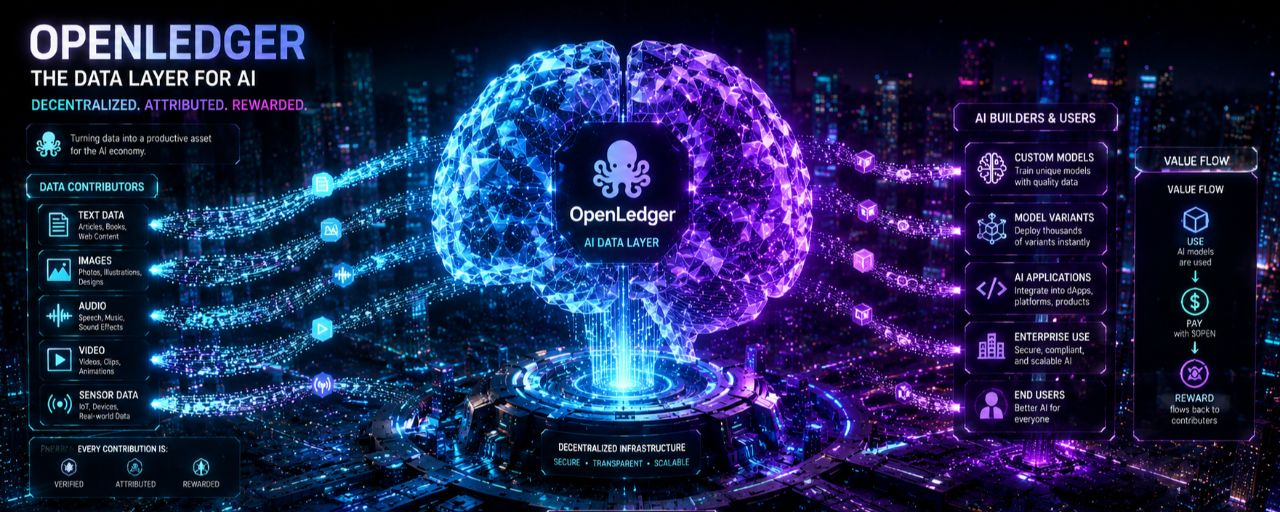
Pour faire simple, OpenLedger n’est pas seulement un token d’IA suivant la tendance du hype : c’est une couche d’infrastructure de type Layer 2 compatible EVM, conçue spécialement pour stocker, contribuer et commercialiser les données d’IA de manière décentralisée.
┌────────────────────────────────────────────────────────┐ │ Économie d’IA décentralisée │ ├────────────────────────────────────────────────────────┤ │ Couche de données │ Usine de modèles (OpenLoRA) │ Engagement des agents │ ├────────────────────────────────────────────────────────┤ │ Chaîne OpenLedger (infrastructure EVM L2) │ └────────────────────────────────────────────────────────┘
Dans le paysage Narrative AI x Web3, alors que des projets comme io.net ou Aethir se concentrent sur la couche Compute (fournir de l’énergie de calcul / GPU), OpenLedger se concentre entièrement sur la couche Data & Intelligence (Données et Intelligence). Le projet crée un réseau blockchain où les flux de données, l’entraînement des modèles (Model Training) et l’exécution des AI Agents autonomes se font on-chain de manière transparente.
Cet écosystème transforme des actifs de données auparavant « statiques » et isolés en actifs très liquides (Liquid Assets) grâce aux Datanets (réseaux de collaboration de données on-chain). Ici, la communauté peut contribuer ensemble, affiner et gérer des ensembles de données spécialisés pour entraîner l’IA.
3. La souffrance actuelle de l’IA : la domination monopolistique et la « boîte noire » opaque
L’industrie traditionnelle de l’IA (Centralized AI) s’approche dangereusement d’une limite due à la structure de centralisation qu’elle implique :
Le monopole des « Centralized AI Giants » : de grandes entreprises contrôlent toute l’infrastructure de calcul (Compute Monopoly) et conservent en exclusivité de vastes entrepôts de données. Les startups plus petites ont presque aucune chance d’accéder à ces données de haute qualité.
Boîte noire de l’IA (Opaque Training Process) : le processus d’entraînement du modèle est entièrement une « boîte noire ». Les utilisateurs ne peuvent jamais savoir avec quelles sources de données le modèle est entraîné, s’il est biaisé (bias) ou s’il viole la confidentialité (Privacy Violation).
Exploitation des données (Data Exploitation) : les créateurs de contenu, les médecins, les ingénieurs ou les utilisateurs ordinaires contribuent en continu des connaissances sur internet. Pourtant, les modèles d’IA les collectent gratuitement. La propriété des données (Data Ownership) est dépouillée sans vergogne.
Quand les données s’épuisent et que les procès pour violation des droits d’auteur se multiplient, l’IA a forcément besoin d’une solution décentralisée. C’est la raison pour laquelle Web3 est né pour réparer l’IA.
4. Comment OpenLedger résout à la source le problème des données
OpenLedger brise la structure de « boîte noire » de l’IA traditionnelle grâce à 4 piliers technologiques clés :
4.1. Mécanisme de preuve d’attribution (Proof of Attribution)
C’est l’arme suprême d’OpenLedger. Lorsqu’un modèle d’IA est appelé pour exécuter une tâche (inférence), le système est capable de retracer précisément sur quel modèle il a été entraîné, à partir de quel jeu de données, et qui a contribué ce jeu de données. Cette transparence garantit que les récompenses économiques seront automatiquement distribuées vers le portefeuille du contributeur d’origine, en temps réel.
4.2. Architecture modulaire et cadre technique OpenLoRA
Au lieu d’essayer d’exécuter des modèles d’IA lourds, OpenLedger prend en charge le framework OpenLoRA (Low-Rank Adaptation). Cette technologie permet à des milliers de petits modèles d’IA, optimisés et ajustés de manière spécialisée, de tourner en même temps sur le même GPU. Cela permet de réduire au maximum les coûts matériels et d’obtenir une flexibilité (Composability) nettement supérieure.
4.3. Une économie des données ouvertes via Datanets
N’importe qui peut créer ou rejoindre un Datanet. Par exemple : un groupe de médecins peut créer un Datanet sur des dossiers médicaux sécurisés, le chiffrer, puis l’utiliser pour entraîner un IA spécialisée en médecine. Toute tentative de fraude sur les données ou des données inutilisables sera éliminée par la couche Validator du réseau.
4.4. Une transparence absolue (On-chain Transparency)
Tous les cycles de vie de l’IA, de la proposition de modèle, au chargement des données, jusqu’au vote, puis au paiement des coûts d’inférence, sont consignés on-chain. Cela crée un système de minimisation de la confiance (Trust Minimization), permettant aux grandes entreprises d’utiliser l’IA sans craindre de fuite de données ni d’être impliquées dans des problèmes juridiques.
5. Analyse approfondie de la tokenomics : rôle et moteurs de valeur du token $OPEN
Le token est le flux sanguin de l’économie centrale, qui assure le fonctionnement et le maintien de la nature décentralisée de l’ensemble du réseau OpenLedger.
📊 Indicateurs clés (Key Metrics)
Ticker : OPEN
Offre totale (Total Supply) : 1 000 000 000 OPEN (1 milliard de tokens)
Réseau : Layer 2 compatible EVM (avec un Bridge vers Ethereum L1)
🪙 Répartition des tokens (Token Allocation)
La répartition des tokens d’OpenLedger reflète clairement une priorité accordée à la communauté et à la durabilité à long terme :
Répartition Catégorie Taux Rôle principal Communauté (Cộng đồng) 51,71 % Récompenses pour les Data Contributors, les Validators et les campagnes d’incitations. Investisseurs (Nhà đầu tư) 18,29 % Versé aux fonds partenaires issus des tours Seed/Private. Équipe (Đội ngũ) 15,00 % Moteur clé du développement pour l’équipe core (souvent avec un calendrier de lock long terme). Écosystème (Hệ sinh thái) 10,00 % Financement du développement de dApps, partenariats stratégiques intégrés au réseau. Liquidité (Thanh khoản) 5,00 % Assurer une liquidité fluide sur les exchanges DEX/CEX.
Répartition des tokens :
🟩 Communauté : 51,71 %
🟧 Investisseur : 18,29 %
🟦 Équipe : 15 %
🟨 Écosystème : 10 %
🟪 Liquidité : 5 %
⚙️ Utilité concrète & moteurs de demande (Utility & Demand Drivers)
La croissance de la valeur du token est liée au niveau d’utilisation du réseau grâce à des mécanismes puissants de « Token Sink » (absorption et maintien du token) :
Frais Gas du réseau (jeton gas natif) : contrairement aux Layer 2 classiques utilisant ETH, OpenLedger utilise neuf tokens pour payer les transactions. Lorsque des millions d’AI Agents effectuent des transactions ou mettent à jour les données en continu, la consommation de gas sera extrêmement élevée.
Mise en jeu pour faire fonctionner les AI Agents (AI Agent Staking) : pour que les AI Agents puissent opérer et fournir des services sur le réseau, ils doivent obligatoirement staker une quantité importante de $OPEN. Si l’agent fonctionne mal ou adopte un comportement frauduleux, ces tokens seront réduits (Slashing). Cela crée une énorme demande de tokens, immobilisés hors de la circulation.
Récompenses d’attribution et gouvernance : les tokens servent à payer automatiquement les contributeurs de données de qualité et les Validator qui valident le système. En plus, la détention de tokens permet aux utilisateurs de voter pour déterminer quels modèles seront financés.
6. Pourquoi le récit « Narrative AI x Web3 » est-il au point d’explosion ?
L’explosion de l’IA n’est plus une simple tendance passagère : c’est une nouvelle révolution industrielle. Toutefois, l’IA traditionnelle se heurte à un « mur de cash-flow » alors que les coûts liés aux droits d’auteur des données deviennent de plus en plus élevés.
Le modèle d’Ownership Economy (économie de la propriété) de Web3 est la clé universelle. Il transforme les données, autrefois spoliées, en un type d’actif qui peut générer des revenus (Data Monetization). Le prochain sommet de l’IA ne viendra pas des modèles génériques (General AI), mais d’AI Agents spécialisés en profondeur dans chaque niche (santé, finance, droit…). Une infrastructure de données ouverte comme OpenLedger est le seul endroit qui fournit assez de « nourriture propre » pour nourrir ces AI Agents.
7. Comparaison d’OpenLedger avec d’autres projets d’IA
Pour comprendre la position d’OpenLedger, regardez le tableau des différentes orientations dans le segment Crypto x IA aujourd’hui :
Projet phare Classement Axes centraux Position vs OpenLedger io.net, Aethir, Akash Compute-focused (axé calcul) : collecte et partage la puissance matérielle, des GPU « bruts ». Fournit les « muscles », tandis qu’OpenLedger apporte les « cerveaux et la connaissance » (Données). Bittensor (TAO) Inference/Model-focused (axé inférence/modèle) : crée un réseau compétitif entre des modèles d’intelligence artificielle. Met l’accent sur la sortie du modèle, alors qu’OpenLedger se concentre sur le traitement à la racine dès la couche d’entrée (Data Layer). OpenLedger ($OPEN) Data & Attribution-focused (axé données et attribution) : optimise le pipeline de données, la traçabilité des contributions et la propriété des données. Comble le plus grand vide actuel de l’IA : la transparence de la provenance des données propres.
8. Thèse d’investissement personnelle (Investment Thesis)
Potentiel : à long terme, lorsque les pays renforceront les lois de protection des données et des droits d’auteur (comme l’EU AI Act), les grandes entreprises d’IA ne pourront plus moissonner librement des données illégales. OpenLedger avance d’un pas en construisant dès maintenant un « marché de données » sous droits, avec une validation on-chain clairement traçable. C’est une vision qui anticipe le flux de capitaux des grands fonds.
Attente réaliste : le projet est en phase de finalisation de l’infrastructure. Ne vous attendez pas à ce qu’Open progresse x100 en quelques jours façon memecoin. Il s’agit d’un investissement de type Value Investing (investissement axé sur la valeur) dans une couche d’infrastructure ; la valeur du token augmentera au même rythme que le nombre de Datanets et d’AI Agents lancés sur la chaîne.
9. Risques & défis (Risks & Challenges)
Une analyse objective ne peut pas ignorer la partie risques afin d’éviter un FOMO aveugle :
Défi d’adoption : faire évoluer les habitudes des développeurs d’IA traditionnels (habitués au Web2 comme Hugging Face, AWS) vers une Layer 2 Web3 nécessite un énorme travail d’éducation du marché, et donc du temps.
Qualité des données de contribution (Data Quality) : même avec une couche Validator qui valide, un réseau décentralisé reste exposé au risque d’être spam avec des jeux de données poubelles ou des données falsifiées afin de « grignoter » la part des récompenses en tokens.
Pression de l’inflation en tokens : avec 51,71 % de tokens réservés à la communauté et aux incentives, si le rythme de développement des applications concrètes ne rattrape pas celui des unlocks/distributions de tokens de récompense, Open subira une forte pression de vente de la part des participants au réseau.
10. Conclusion
OpenLedger prouve qu’il ne s’agit pas d’un projet « estampillé IA » pour faire monter le prix du token. En traitant de front le problème le plus brûlant de l’IA moderne : la propriété et la preuve de contribution des données, le projet se construit une solide « tranchée » économique dans le segment Couche de données (Data Layer).
Le marché décentralisé de l’IA en est encore à ses tout premiers chapitres. Faites une recherche approfondie et rigoureuse (DYOR) et suivez de près les prochaines étapes mainnet du projet.
👉 Suivez immédiatement @Openledger pour mettre à jour les programmes de contribution de données menant aux récompenses les plus précoces !