

#techsetup
techsetup
367 vues
16 mentions
Populaire
Récents
Vous pourriez partager vos réflexions sur la finance numérique : l’avenir de la finance numérique est là, et les transactions transfrontalières n’ont jamais été aussi fluides grâce à des plateformes comme RedotPay et Binance. #CryptoTransaction actions.
Autre sujet autour de la configuration technologique : installer ma couche de compatibilité Android sous Linux a été une excellente décision. Exécuter des applications mobiles dans un environnement de bureau maximise la productivité. #linux #TechSetup en hausse.
Autre sujet autour de la configuration technologique : installer ma couche de compatibilité Android sous Linux a été une excellente décision. Exécuter des applications mobiles dans un environnement de bureau maximise la productivité. #linux #TechSetup en hausse.
39

·
--
🚀 $AI CLOUDFLARE CLAIRIC RÉDUIT LE TEMPS DE TRAITEMENT DE 96 % ⚡
📊 L’aperçu de Clairic montre une extraction époustouflante en 0,46 seconde sur des factures volumineuses, éclipsant les LLM traditionnels qui peinent pendant 16 secondes. ⚡ En déléguant les calculs bruts à un traitement distinct de la génération token par token, l’outil fournit des scores de confiance et attribue la valeur null aux champs non étayés en un seul passage. 🦈 Cette cascade d’efficacité fait passer les coûts de traitement des demandes de 11 740 $ à 6 032 $ par million, soit une baisse de 49 % qui pourrait transformer les chaînes de traitement financier pilotées par l’IA. 💡 Comment tirerez-vous parti d’une telle vitesse brute pour distancer la concurrence ? 🤔
⚠️ Ceci ne constitue pas un conseil financier. Gérez toujours vos risques. 🛡️
🏷️ #AI #TechSetup #Efficiency #Crypto
🔥 💎
5

🚀 $AI RÉVÈLE UN MODÈLE VIDÉO SPATIAL EN TEMPS RÉEL – LA PROCHAINE GÉNÉRATION DE LA VR EST LÀ ! 🦈
🦈 Le nouvel moteur « Seedance » de ByteDance peut diffuser des nuages à 20 ips avec une latence de 0,05 s, en déléguant les calculs au cloud et en libérant les casques Pico pour une interaction d’une fluidité remarquable. 📊 Cela fait écho au benchmark de Google « Genie 3 », mais repousse les limites en combinant un contenu réactif à la voix avec du jeu en direct, un court drame et du streaming— le tout dans une seule couche virtuelle. ⚡ Ce changement stratégique signale une recherche de liquidités résolument portée par l’IA, positionnant $AI comme le conduit pour une exposition institutionnelle à la tech immersive.
💬 Comment allez-vous répartir l’exposition au croisement IA‑VR—jouer tôt avec des tokens, ou attendre que l’écosystème mûrisse ? 👇
⚠️ Ceci ne constitue pas un conseil financier. Gérez toujours votre risque. 🛡️
🏷️ #AI #TechSetup #VRInnovation #Crypto
🔥 💎
30
·
--
🚀 $AI DÉCHAÎNE une grande plateforme d’échange CLI POUR LA CRÉATION DE CONTENU PROPULSÉE PAR DES AGENTS ! 📈
📊 Les investisseurs avisés connectent déjà leurs bots à la nouvelle CLI de l’API Gemini, permettant à des agents comme Claude Code de récupérer des résultats multimodaux à la volée. La possibilité de générer des images, des vidéos, des voix off et des analyses de PDF directement depuis la ligne de commande réduit la latence et allège la pile technologique.
🦈 Cette efficacité se traduit par des signaux de trading plus précis et des cycles de recherche plus rapides — exactement ce que recherchent les bureaux de trading algorithmique d’une plateforme d’échange de premier plan. Avec la clé d’une grande plateforme d’échange configurée, vous évitez la corvée d’écriture de scripts et laissez le moteur multimodal de Google faire le gros du travail. ⚡
💬 Comment comptez-vous intégrer la puissance multimodale d’une grande plateforme d’échange à votre prochain bot de trading ? 👇
⚠️ Ceci ne constitue pas un conseil financier. Gérez toujours vos risques. 🛡️
🏷️ #AI #TechSetup #GeminiCLI #CryptoTools
🚀 🔥
16

·
--
🚀 $AI RIPL RÉDUIT LA LATENCE D’INFÉRENCE DE 14× – L’EDGE EN TEMPS RÉEL REPENSÉ ! 📈
📊 Le moteur RIPL de Liquid AI réduit la latence du LFM2.5, avec ses 1,2 milliard de paramètres, à 34,6 ms sur un seul NVIDIA B200, en traitant 95 % des 1 000 requêtes par seconde dans ce délai. ⚡ Face aux 498 ms de vLLM, l’écart atteint 14,4×, ce qui confère un avantage décisif en matière de vitesse pour le classement des résultats de recherche et la gestion des risques de paiement.
🦈 Cette accélération transforme les modèles de langage en outils agiles de première ligne, permettant aux institutions de saisir les opportunités de liquidité avant que les flux d’ordres ne se stabilisent. 💡 Attendez-vous à une vague d’adoption rapide, les entreprises cherchant à tirer parti de cet avantage en matière de latence pour devancer leurs rivales dans les boucles de décision en temps réel. 💬 Comment cet avantage de vitesse va-t-il transformer votre stratégie d’IA en temps réel ? 👇
⚠️ Ceci ne constitue pas un conseil financier. Gérez toujours vos risques. 🛡️
🏷️ #AI #TechSetup #Inference #Speed #Crypto
🔥 💎
Voir la traduction
🚨 $AI UNVEILS MATH-DRIVEN BUG ELIMINATION – CLAUDE'S NEW EDGE! 🦈
Claude’s partnership with Theorem turns random fuzzing into formal proofs, 📊 delivering deterministic guarantees that conventional testing can’t match. Within weeks the model verified 239 entry points across 123 libraries, generating 180 million lines of proof and sealing out crashes for inputs under 64 MB. ⚡ Hundreds of hidden bugs—like a 20 MB out‑of‑bounds write—were not only spotted but patched, showcasing a scalability leap that rivals decades‑long human verification efforts.
The market is watching how this proof‑first paradigm could reshape risk models for AI‑driven assets. 📌 Will smart‑money allocations pivot toward projects that embed formal verification as a moat? 💬 What’s your read on the long‑term premium for mathematically‑secured code? 👇
⚠️ Not financial advice. Always manage your risk. 🛡️
🏷️ #AI #TechSetup #Verification #Crypto #Innovation
🔥 💎
3

·
--
Voir la traduction
🚀 $AI UNVEILS GPT‑6 SOL & LUNA – CHEAPER POWER PLAY! 📈
📊 Sol’s code‑crunching muscle lands at $2 input / $10 output per million tokens, a clean 50% cut versus Opus 5.5, igniting a fresh demand wave for AI‑driven dev pipelines ⚡. Luna flips the script with $0.10/$0.50 pricing, turning high‑frequency chores into cheap arbitrage while deception rates tumble below 3% 🦈💡. Both models are already live in the API, primed for early‑adopter bots to sweep the new liquidity pool.
💬 Which model will you stack in your automation stack first? 👇
⚠️ Not financial advice. Always manage your risk. 🛡️
🏷️ #AI #TechSetup #Automation #Crypto
🚀 💎
3

·
--
🚀 $DUSK FONDATION COMPLÈTE – LE PLANCHER INSTITUTIONNEL EST EN PLACE ? 💥
📊 Lorsque la couche de base fonctionne sur une sécurité renforcée et que la couche supérieure remet les clés aux développeurs, ce n’est pas seulement une pile technologique : c’est un aimant à liquidité. $DUSK a terminé le gros du travail : l’ingénierie est faite, l’infrastructure est éprouvée au combat, et la dernière pièce repose désormais sur le flux de capitaux. Les « smart money » n’attendent pas des entrées parfaites ; elles s’accumulent là où les fondations sont indéniables. 📈
💡 Plus la phase de consolidation latérale dure, plus le ressort se resserre. Une fois que la première bougie de cassure dépasse le plus haut récent, l’élan suit souvent – car le carnet d’ordres a eu le temps de s’alléger. 💬 Surveillez-vous la clôture quotidienne pour confirmation, ou êtes-vous déjà positionné avant le mouvement ? 👇
⚠️ Ceci n’est pas un conseil financier. Gérez toujours votre risque. 🛡️
🏷️ #DUSK #Altcoin #TechSetup #Bullish #Crypto
🎯 🦈
17
·
--
🚀 🦈 $AI FLASH SPEED SURGES TO 420 TOKENS/SEC – UNE CHASSE À LA LIQUIDITÉ MENÉE PAR LES ACTEURS AVERTIS
📊 Le dernier benchmark DeepSeek V4.1 Flash affiche 420 tokens par seconde, dépassant le plafond précédent de 128 tps. Plus de 71 000 tokens sont traités en moins de trois minutes, une vélocité qui reflète les pics de flux d’ordres institutionnels sur une plateforme de premier plan. 🦈
⚡ Ce débit brut devient un véritable aimant à liquidité, permettant au modèle d’ingérer et de réagir aux micro‑signaux du marché plus vite que la plupart des traders algorithmiques. Attendez-vous à des re-tests des blocs d’ordres pendant que le marché se réajuste autour de cette nouvelle frontière de vitesse. 📌
💬 Est-ce que vous positionnez $AI pour tirer parti de cet avantage en vitesse d’exécution ? 👇
⚠️ Ceci n’est pas un conseil financier. Gérez toujours votre risque. 🛡️
🏷️ #AI #TechSetup #FlashSpeed #Crypto #SmartMoney
🔥 💎
46

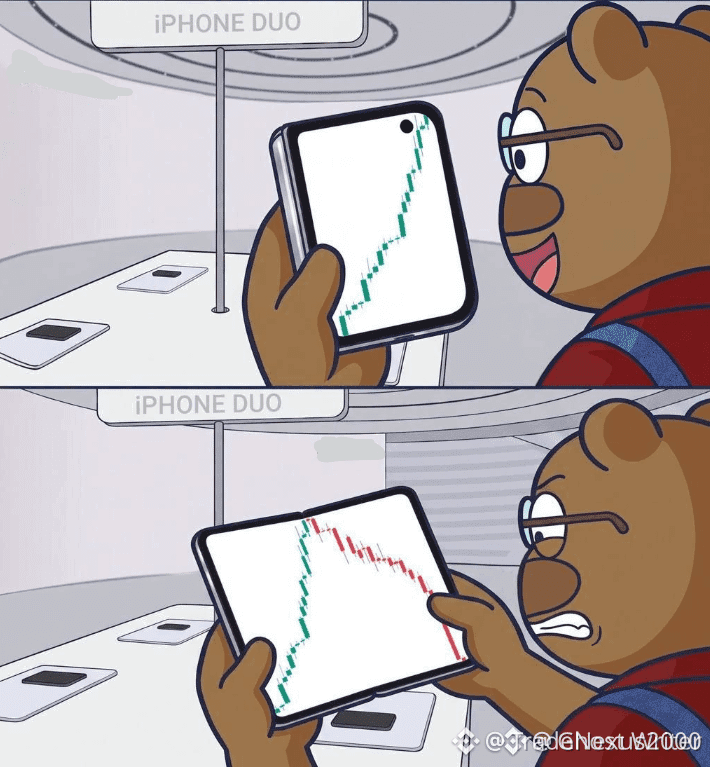
🦈 $AAPL FOLDÉ EN UN NOUVEAU TÉLÉPHONE : L’ARGENT « SMART » VA-T-IL RÉÉCRIRE LE PLAYBOOK ? 📈
📊 Le lancement pliable d’Apple, c’est bien plus qu’une simple présentation produit ; c’est une opération de liquidité qui reconfigure le capital institutionnel au sein de l’écosystème tech. 📌
🦈 L’analyse des zones d’ordre montre que le corridor $AAPL se resserre, avec des grappes de « smart money » qui s’accumulent avant les résultats, laissant entrevoir une impulsion haussière possible une fois que le marché digère le nouveau facteur de forme. ⚡
💬 Comment vous positionnez-vous face à ce changement structurel ? 👇
⚠️ Ceci n’est pas un conseil financier. Gérez toujours votre risque. 🛡️
🏷️ #AAPL #Foldable #TechSetup #Liquidity #SmartMoney
🔥 💎
49
·
--
🚀 $AI BREAKTHROUGH : SWE-2 RÉDUIT LES COÛTS ET AMÉLIORE L’EFFICACITÉ DE CODAGE ! 💥
📊 SWE-2, la nouvelle progéniture de l’agent de codage de Cognition, Devin, ravage les benchmarks, fait grimper les scores de 5 à 6 % et réduit de 64 % l’étiquette de prix par rapport aux leaders. 🦈 Sur FrontierCode 1.1 Main, il atteint 50,0 %, soit seulement 0,9 point de moins que le leader, tout en offrant une réduction de 58 % des tours d’interaction et une chute de 81 % des coûts à effort moyen. ⚡ La seule marque ? Un modeste 27,3 % sur le brutal Terminal‑Bench 4, nous rappelant que la course n’est pas terminée.
💬 Les traders vont-ils commencer à couvrir leurs chaînes de développement avec SWE‑2, ou attendre le prochain saut vers la prochaine frontière ? 👇
⚠️ Ceci n’est pas un conseil financier. Gérez toujours votre risque. 🛡️
🏷️ #AI #TechSetup #CodingAI #Innovation #Crypto
🔥 💎
26

$REFONTE FOLD : ÉCRAN PLUS LARGE, ENTRÉE PLUS NETTE – LA FORME QUE APPLE VAS SUIVRE 🦈
Entrée : 1 899 ⚡
Objectif : 2 099 🚀
Stop Loss : 1 200 ⚠️
📌 Samsung vient de transformer l’ancienne silhouette haute et étroite en un écran 4:3 de 7,6 pouces — exactement la géométrie que le premier iPhone pliable d’Apple serait censé copier. 📊 Les précommandes ont ouvert le même jour, avec des expéditions à partir du 7 août, créant une hausse immédiate du volume pour l’écosystème $FOLD. 💡 Ce n’est pas juste une mise à jour produit : c’est une percée structurelle d’une forme qui avait échoué, soutenue par un châssis plus léger (201 g) et une couche en titane qui élimine la pliure.
💬 L’Ultra à 2 099 ajoute un capteur de 200 MP et une batterie de 5 000 mAh, mais la vraie “collecte” de liquidités se fait sur le Fold 8 standard. Vas-tu te positionner avant le catalyseur Apple de septembre ou laisser l’Ultra mener la dynamique ? 👇
⚠️ Ceci n’est pas un conseil financier. Gère toujours ton risque. 🛡️
🏷️ #FOLD #Foldable #Samsung #TechSetup #Breakout
🦈 📱
38
·
--
🚀🦈 $AI DÉVERROUILLE DES AGENTS DE CODAGE MULTI‑MACHINES – LA PROCHAINE VAGUE D’INFRASTRUCTURE IA !
Herdr 0.9.0 débarque comme un tmux conçu pour les robots de codage, permettant à Claude, Codex et Cursor CLI de tourner côte à côte sur des nœuds SSH locaux ou distants. Même si votre terminal disparaît, les agents restent opérationnels, synchronisant leur statut dans une barre latérale unique 📊⚡.
Les acteurs avisés y voient un catalyseur de liquidité : une orchestration unifiée des agents réduit la latence, augmente la vélocité de développement et pourrait relancer une demande pour des jetons de calcul IA 📈🦈. La feuille de route promet une collaboration entre machines — pensez à une intelligence en essaim multi‑nœuds.
💬 Êtes-vous prêt à empiler votre pile IA sur cette montée en puissance multi‑machines ? 👇
⚠️ Ceci n’est pas un conseil financier. Gérez toujours votre risque. 🛡️
🏷️ #AI #TechSetup #AgentOps #Crypto
🔥 💎
42
Connectez-vous pour découvrir plus de contenu
Rejoignez la communauté mondiale des adeptes de cryptomonnaies sur Binance Square
⚡️ Suviez les dernières informations importantes sur les cryptomonnaies.
💬 Jugé digne de confiance par la plus grande plateforme d’échange de cryptomonnaies au monde.
👍 Découvrez les connaissances que partagent les créateurs vérifiés.
Adresse e-mail/Nº de téléphone
Sujets d’actualité
1
#BinanceSAFUFundTransferCompleted7499BTC
24,348 vues
618 mentions
2
#BinanceRecovery90% of stolen assets
98,868 vues
147 mentions
3
#YiHe:ProofOfReserves:10TokensAt100%Backing
111,765 vues
638 mentions
4
#BackedNotBroken:RichardTengSaysUsersBearNoLoss
22,683 vues
397 mentions
5
#CZSaysCompensationIsinPlaceUsersAreProtected
107,098 vues
1,299 mentions
6
#IntelHasItsWorstDaySince1974
37,894 vues
646 mentions
7
#TRMCambodianCasinosReceived$1.07BInCrypto
9,791 vues
66 mentions
8
#USDCCirculationFallsAbout800MInSevenDays
60,931 vues
685 mentions
9
#SuspectedNorthKoreaAttacksAccountForNearly89%OfCryptoHackLosses
13,451 vues
94 mentions
10
#OpenAICutsFundraisingTargetBy$10B
3,134 vues
73 mentions