
#sxt $SXT @SpaceandTime Quelque chose d'étrange m'a frappé en parcourant la documentation de Proof of SQL... la preuve est vérifiée sur la chaîne pour environ 150k gas, et sa vérification ne dépend pas vraiment de la taille de la table.
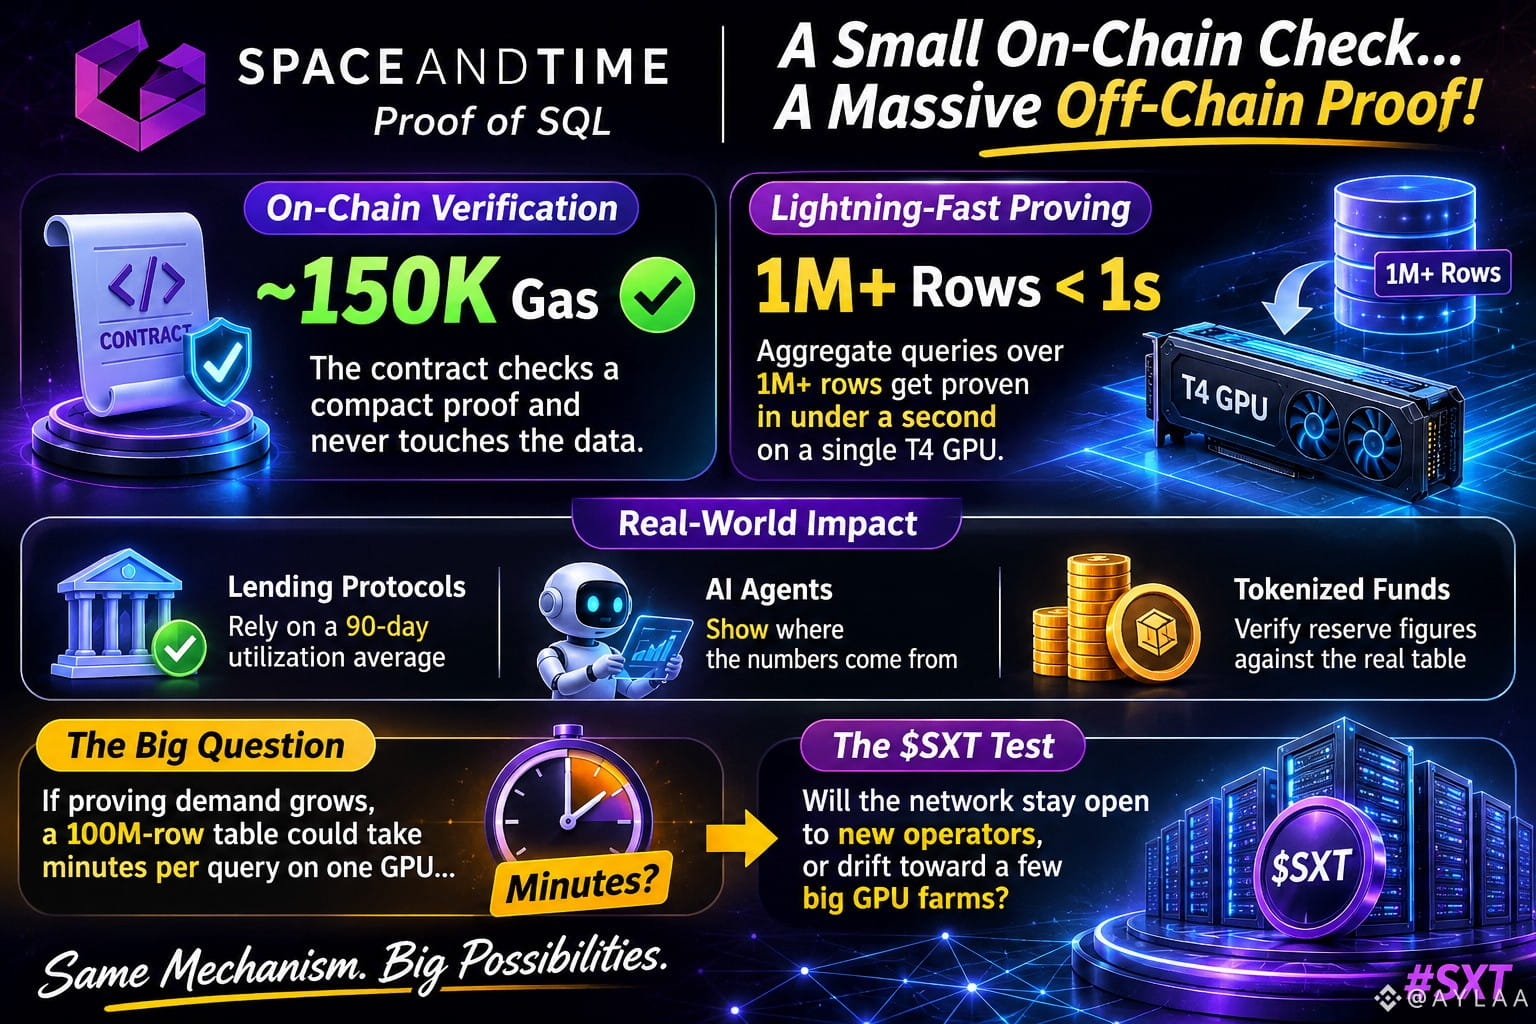
La vérification peut coûter à peine environ 150k gas, tandis que les requêtes d'agrégation sur plus d'un million de lignes sont prouvées en moins d'une seconde sur un seul GPU T4. Le benchmark précédent était de 3,2 secondes sur un million de lignes, donc le prouveur est devenu beaucoup plus rapide. Le rôle du contrat reste limité dans les deux cas. Il vérifie une preuve compacte et ne touche jamais aux données.
Je pense que cette séparation résume tout. Un protocole de prêt pourrait s'appuyer sur une moyenne d'utilisation sur 90 jours sans faire confiance à la personne qui l'a calculée. Un agent d'IA pourrait montrer d'où viennent ses chiffres. Le chiffre des réserves d'un fonds tokenisé pourrait être vérifié par rapport à la table sous-jacente. Le même mécanisme à chaque fois, c'est pourquoi @SpaceandTime m'intéresse davantage que ne le laisse entendre l'étiquette « données vérifiables ».
Mon hésitation porte sur la génération de la preuve. La vérification est peu coûteuse, mais le temps nécessaire à la génération augmente avec la taille de la table. Si la croissance était linéaire (ma propre estimation approximative, pas un benchmark publié), une table de 100 millions de lignes ferait passer le temps de quelques secondes à quelques minutes par requête sur un seul GPU. Une telle demande ferait de l'accès aux GPU le goulot d'étranglement, et la question serait alors de savoir qui finirait par exploiter les prouveurs.
C'est probablement là que $SXT serait mis à l'épreuve, puisque c'est ce qui est censé coordonner ceux qui prouvent et ceux qui paient. #SXT
Si la demande de génération de preuves devenait importante, le réseau resterait-il ouvert à de nouveaux opérateurs, ou dériverait-il vers quelques grandes fermes de GPU ?
La vérification peut coûter à peine environ 150k gas, tandis que les requêtes d'agrégation sur plus d'un million de lignes sont prouvées en moins d'une seconde sur un seul GPU T4. Le benchmark précédent était de 3,2 secondes sur un million de lignes, donc le prouveur est devenu beaucoup plus rapide. Le rôle du contrat reste limité dans les deux cas. Il vérifie une preuve compacte et ne touche jamais aux données.
Je pense que cette séparation résume tout. Un protocole de prêt pourrait s'appuyer sur une moyenne d'utilisation sur 90 jours sans faire confiance à la personne qui l'a calculée. Un agent d'IA pourrait montrer d'où viennent ses chiffres. Le chiffre des réserves d'un fonds tokenisé pourrait être vérifié par rapport à la table sous-jacente. Le même mécanisme à chaque fois, c'est pourquoi @SpaceandTime m'intéresse davantage que ne le laisse entendre l'étiquette « données vérifiables ».
Mon hésitation porte sur la génération de la preuve. La vérification est peu coûteuse, mais le temps nécessaire à la génération augmente avec la taille de la table. Si la croissance était linéaire (ma propre estimation approximative, pas un benchmark publié), une table de 100 millions de lignes ferait passer le temps de quelques secondes à quelques minutes par requête sur un seul GPU. Une telle demande ferait de l'accès aux GPU le goulot d'étranglement, et la question serait alors de savoir qui finirait par exploiter les prouveurs.
C'est probablement là que $SXT serait mis à l'épreuve, puisque c'est ce qui est censé coordonner ceux qui prouvent et ceux qui paient. #SXT
Si la demande de génération de preuves devenait importante, le réseau resterait-il ouvert à de nouveaux opérateurs, ou dériverait-il vers quelques grandes fermes de GPU ?