

Claude Code lit désormais vos fichiers avec Opus.
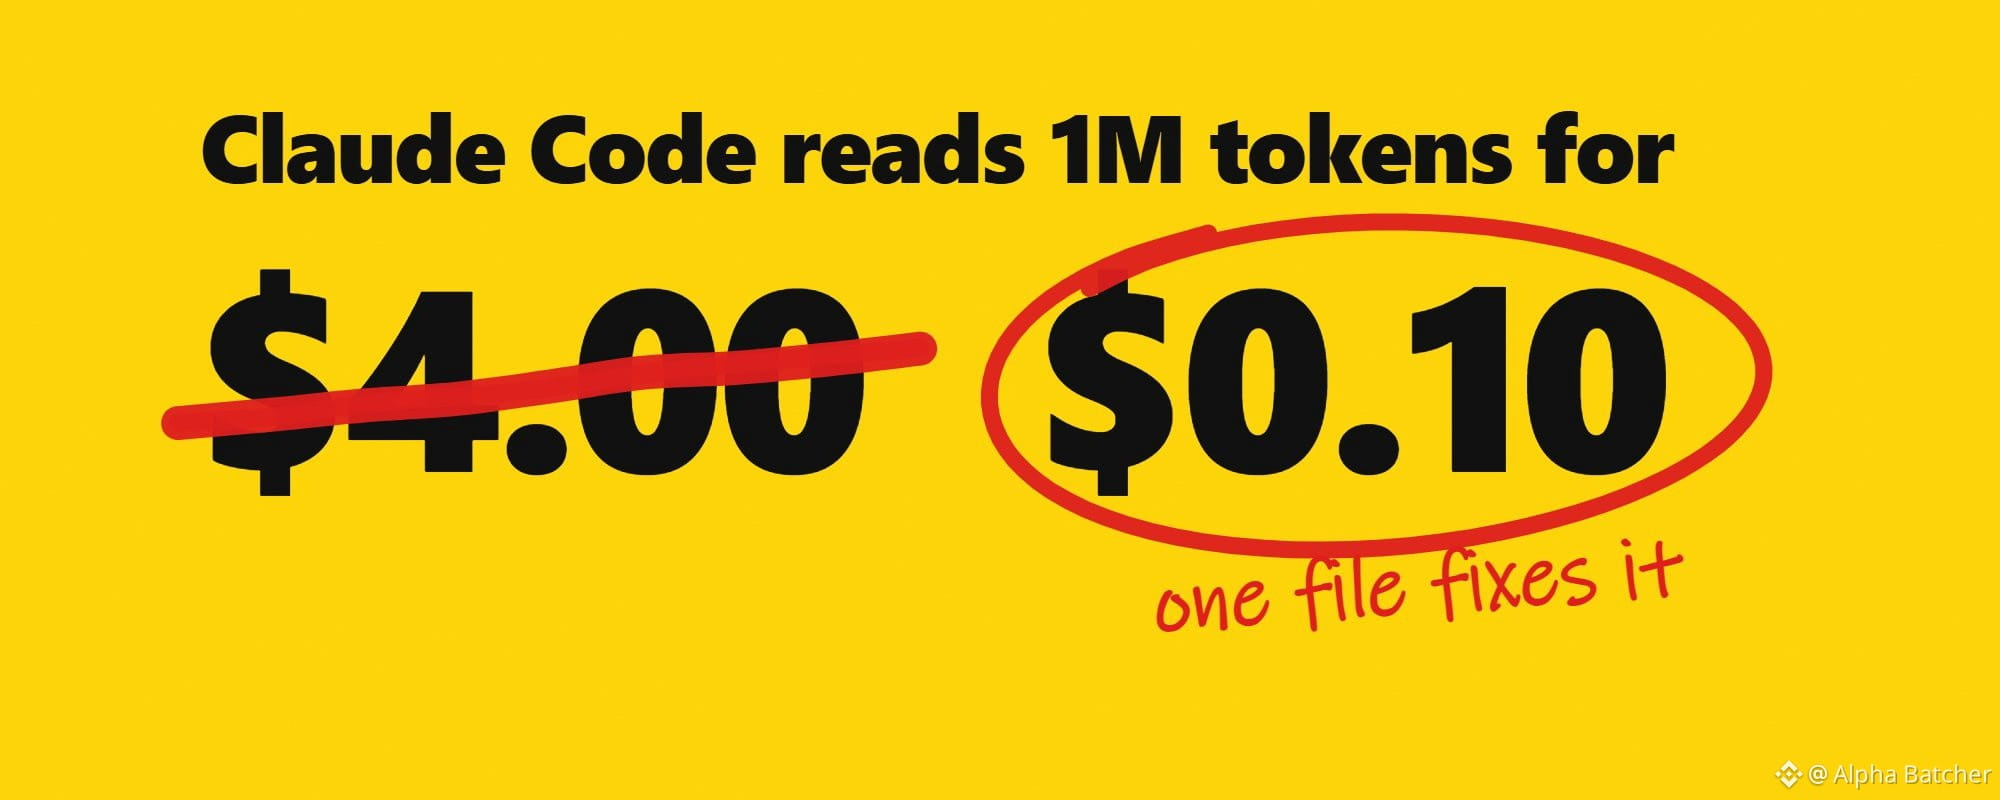
Le sous-agent Explore intégré, celui que Claude utilise pour rechercher dans votre base de code, fonctionnait auparavant avec Haiku. Dans les versions actuelles, il utilise le modèle de votre session. Avec la configuration par défaut, c’est Opus 5.5 : 4 $ par million de jetons d’entrée, contre 0,10 $ pour Haiku 5.5.
C’est un paramètre. Anthropic a publié les chiffres qui sous-tendent les autres dans son guide du 9 novembre pour choisir un modèle Claude, ainsi que dans un article de septembre sur le coût d’une tâche avec Opus 5.5 :
• Toutes les tâches avec un niveau d’effort faible, en ne relançant à un niveau élevé que celles qui échouaient, ont permis de terminer environ 97 % des tâches pour 0,17 $ chacune. Avec un niveau élevé pour toutes les tâches, le taux de réussite était de 95,3 %, pour 0,29 $ chacune.
• un responsable Opus avec jusqu’à 25 agents Sonnet coûte environ un tiers de moins qu’Opus seul, pour un score à peu près équivalent.
• avec une clé API, une pause-café de 6 minutes à 120K jetons de contexte transforme la prochaine lecture du cache à 0,02 $ en une écriture à 0,60 $.
• dans un benchmark de 20 problèmes, 2 problèmes représentaient 43 % des dépenses.
ce cours transforme ces chiffres en réglages. Chaque chapitre se termine par quelque chose à coller dans Claude Code, et vous dépenserez moins après chacun d’eux :
• où va l’argent : tours, cache, sortie et modèle
• mettez Explore et les autres agents de lecture sur Haiku
• définissez l’effort avant de changer de modèle
• gardez le cache chaud
• envoyez moins à chaque tour
• choisissez le modèle en fonction de la tâche
• un responsable et des agents à bas coût
• mesurez les résultats sur votre propre travail
si vous n’avez que 30 secondes, ces 5 lignes résument tout le cours :
créez un sous-agent nommé Explore avec model: haiku, et mettez sur Haiku tous les sous-agents qui ne font que lire.
commencez avec un effort medium. Exécutez les lots en low et ne relancez que les échecs en high.
avec une clé API, compactez avant une pause, jamais après.
limitez CLAUDE.md à moins de 200 lignes et désactivez les serveurs MCP que vous n’utilisez pas.
gardez Opus pour les décisions et les modifications de code, et vérifiez /usage après chaque tâche réelle.
où va l’argent
une tâche Claude Code est une boucle : lire la conversation, appeler un outil, lire le résultat, recommencer. Chaque tour de boucle est une requête, et 4 éléments déterminent son prix.
• les tours. Chaque tour renvoie toute la conversation. Dans l’exemple d’Anthropic, une tâche dont le contexte passe de 20K à 120K jetons sur 40 tours envoie environ 2,8M jetons d’entrée. La même tâche en 25 tours en envoie environ 1,75M.
• les lectures du cache. La majeure partie du contenu renvoyé à chaque tour a déjà été envoyée au tour précédent ; elle est donc facturée comme une lecture du cache : 0,20 $ par million sur Opus 5.5, soit un vingtième du tarif d’entrée de 4 $. Ces 2,8M jetons coûtent 11,20 $ sans cache, 1,62 $ avec un taux de succès de 90 % et environ 0,99 $ à 96 %.
• la sortie. 20 $ par million sur Opus 5.5, soit 100 fois le coût d’une lecture du cache. La réflexion est facturée comme de la sortie, même si Claude Code ne vous montre qu’un résumé. 60K jetons de sortie coûtent 1,20 $, soit autant que 6M jetons lus depuis le cache.
• le modèle. Il détermine le prix de chaque jeton, et chaque sous-agent qui hérite du modèle hérite aussi de son tarif.
à la fin de votre prochaine tâche réelle, exécutez /usage et lisez 3 lignes.
partage du cache : élevé lors d’une longue session. Faible signifie une longue pause, un changement de modèle ou la connexion d’un serveur MCP en cours de route.
sortie par rapport à l’entrée : beaucoup de sortie pour un petit changement signifie que l’effort est trop élevé ou que le modèle réessaie.
entrée totale par rapport à la taille de la conversation : un total bien plus élevé signifie de nombreux tours. Lisez la session et repérez la boucle.
vous avez la ligne de votre facture à corriger en premier.
moins de tours et un cache chaud font économiser plus que n’importe quelle remise.
mettez Explore et les autres agents de lecture sur Haiku
un sous-agent est un assistant que Claude lance pour une tâche secondaire. Il travaille dans sa propre fenêtre de contexte et renvoie un résumé ; ses jetons sont facturés au tarif de son propre modèle.
Les sous-agents intégrés à Claude Code, d’après la documentation :
• Explore parcourt votre base de code en lecture seule. Il utilise le modèle de votre session. Si votre session utilise Fable, Explore passe à Opus avec un abonnement Claude, un compte Anthropic Console ou une passerelle, et reste sur Fable avec Bedrock, Google Cloud, Foundry, Claude Platform sur AWS et une passerelle d’applications Claude.
• Plan fait des recherches en mode planification. Il hérite du modèle de votre session.
• general-purpose explore et modifie des fichiers. Il en hérite également.
un fichier nommé Explore dans votre dossier agents remplace celui intégré et conserve son propre modèle. Le guide d’Anthropic recommande exactement cette démarche.
enregistrez ceci sous ~/.claude/agents/Explore.md pour tous les projets, ou sous .claude/agents/Explore.md pour un seul :
---
name: Explore
description: Agent rapide de recherche en lecture seule pour parcourir et comprendre une base de code. À utiliser pour trouver des fichiers, rechercher du code et répondre aux questions du type « où se trouve ceci ? ».
tools: Read, Grep, Glob
model: haiku
omitClaudeMd: true
---
Rechercher et lire uniquement. Ne jamais créer ni modifier de fichiers. Répondre avec les chemins des fichiers, les numéros de ligne et un bref résumé des éléments trouvés.
omitClaudeMd le lance sans votre CLAUDE.md, comme le fait Explore intégré. Redémarrez Claude Code si le dossier agents n’existait pas auparavant, et exécutez claude update : sur l’API Anthropic, l’alias haiku pointe vers Haiku 5.5 à partir de la version v2.1.293. Sur Bedrock, Google Cloud, Foundry et Claude Platform sur AWS, il désigne toujours Haiku 4.5.
faites de même pour chaque assistant qui ne fait que lire des journaux, des résultats de tests ou des résultats de recherche. Voici l’exemple d’Anthropic :
---
name: log-reader
description: Lit les résultats de tests et les journaux, et signale chaque échec. À utiliser après une exécution de tests.
tools: Read, Grep, Glob, Bash
model: haiku
---
Lisez les journaux fournis. Pour chaque échec, indiquez le fichier, le nom du test et la première ligne d’erreur. Ne modifiez aucun fichier.
pour utiliser un seul modèle pour tous les sous-agents, définissez la variable d’environnement CLAUDE_CODE_SUBAGENT_MODEL. Un modèle indiqué dans le fichier d’un sous-agent a priorité sur cette variable.
gardez les modifications de code et les décisions de jugement pour votre modèle principal. Un petit modèle qui interprète mal un résultat de recherche envoie le modèle principal dans le mauvais fichier, et c’est le modèle principal qui paie ce détour.
vous obtenez la lecture des recherches, des journaux et des résultats de tests à 0,10 $ par million de jetons d’entrée au lieu de 4 $. Exécutez /tasks la prochaine fois que Claude délègue une tâche, et vous verrez quel modèle utilise chaque sous-agent.
un fichier par agent de lecture, et la lecture ne coûte plus le tarif d’Opus.
définissez l’effort avant de changer de modèle
l’effort détermine combien le modèle réfléchit, écrit et appelle des outils à chaque tour. Opus 5.5 propose les niveaux low, medium, high et xhigh, ainsi que max pour une seule session. Dans Claude Code, medium est le niveau par défaut.
Anthropic l’a mesuré sur un sous-ensemble de SWE-bench Pro avec Opus 5.5 :
• medium : environ 2,5 points de moins que high, pour environ 70 % du coût.
• low : environ 8 points de moins que high, pour environ un tiers du coût.
• xhigh : environ 1,4 point de plus que high, pour 2,5 fois le coût.
puis l’exécution qui les a toutes surpassées : tout en low, et seuls les échecs relancés en high. Environ 97 % des tâches accomplies à 0,17 $ chacune, contre 95,3 % à 0,29 $ lorsque toutes les tâches étaient en high.
cela ne fonctionne que lorsque Claude peut vérifier son propre travail : avec un test, une compilation ou un script qui appelle le point de terminaison. Une vérification coûte un tour et sa sortie. Un effort plus élevé ajoute de la réflexion à chaque tour.
quand un modèle n’est pas assez performant, le guide d’Anthropic recommande cet ordre :
1. donnez-lui un moyen de vérifier son travail.
2. augmentez l’effort d’un niveau.
3. passez au modèle supérieur, avec un effort inférieur à celui utilisé pour le modèle plus petit.
pour un lot de tâches, exécutez /effort low et collez :
effectue chaque tâche de todo.md, une par une. Après chacune, lance son test. Écris dans failed.md les tâches dont les tests échouent, avec la première ligne d’erreur pour chacune. Ne change rien en dehors de ce dépôt et ne pousse rien.
puis exécutez /effort high et collez :
refais uniquement les tâches de failed.md et relance leurs tests. Dis-moi lesquelles échouent encore. Ne pousse rien.
vous obtenez une première passe économique sur l’ensemble, et un effort élevé uniquement là où la première passe a échoué.
avec une clé API ou un abonnement, modifier l’effort conserve votre cache. Sur Bedrock, Google Cloud Agent Platform ou une passerelle, cela vide le cache : faites donc ce changement pendant une pause.
low d’abord, high pour les échecs, et vous ne payez la réflexion que là où elle change le résultat.
gardez le cache chaud
le cache contient la partie de la conversation que Claude Code n’a pas à renvoyer au tarif normal. Sur Opus 5.5, la lecture du cache coûte 5 % du prix d’un nouveau jeton d’entrée. L’écriture du cache coûte 1,25 fois le prix d’entrée pour un cache de 5 minutes, et 2 fois pour une heure.
sa durée dépend de votre mode de paiement : une heure avec un abonnement Claude, 5 minutes avec une clé API ou un fournisseur cloud, et 5 minutes dès qu’un abonnement utilise des crédits d’usage.
c’est la pause-café. Avec 120K jetons de contexte, une lecture coûte environ 0,02 $ et une nouvelle écriture de 5 minutes environ 0,60 $. Si vous faites une pause de 6 minutes avec une clé API, votre prochain tour paiera l’écriture.
ces actions entraînent également une écriture au tour suivant :
• changer de modèle : le nouveau modèle démarre avec un cache vide.
• connecter ou déconnecter un serveur MCP en cours de session.
• activer le mode rapide pour la première fois dans une conversation.
• compacter, ce qui réécrit l’historique associé au cache.
• modifier l’effort sur Bedrock, Google Cloud Agent Platform ou une passerelle.
configurez ces éléments au début de la session, puis n’y touchez plus pendant qu’elle est en cours.
compactez à une pause naturelle, tant que le cache est encore chaud. À 150K jetons, un /compact coûte environ 0,25 $ et économise environ 0,025 $ à chaque tour suivant : il est donc rentabilisé en une dizaine de tours. Après une pause plus longue que la durée de vie du cache, le même /compact relit toute la conversation : environ 0,75 $ pour 150K jetons.
/clear ne coûte rien : utilisez-le entre des tâches sans rapport. /rewind revient à un tour précédent encore en cache, si vous voulez supprimer une piste.
avant de vous absenter, collez :
/compact conserve les noms des tests en échec, les fichiers modifiés et la prochaine étape
vous retrouvez une conversation courte, toujours en cache à votre retour.
compactez avant la pause-café, jamais après.
envoyez moins à chaque tour
chaque tour renvoie tout le contenu précédent. Avec 20K jetons de contexte, la lecture du cache d’un tour coûte environ 0,004 $ sur Opus 5.5. À 150K, elle coûte environ 0,03 $ : 30 tours représentent donc 0,90 $ rien qu’en lectures, contre environ 0,12 $ à 20K.
3 éléments sont chargés avant même que vous commenciez à taper :
• CLAUDE.md est chargé dans chaque session et renvoyé à chaque tour. La documentation tarifaire d’Anthropic recommande de le limiter à moins de 200 lignes.
• Les serveurs MCP. Seuls les noms des outils et les instructions du serveur sont chargés au début ; une définition complète est chargée lorsque l’outil est utilisé. Exécutez /mcp et désactivez les serveurs que vous n’utilisez pas.
• Les anciennes instructions. Les invites conçues pour un modèle plus ancien peuvent pousser Opus 5.5 à écrire davantage et à répéter les appels d’outils. Dans le benchmark d’assistance d’Anthropic, composé de 44 tickets, passer d’Opus 4.8 à Opus 5.5 avec un effort low a réduit le coût d’environ 18 %, et la commande /claude-api prompt-audit de Claude Code l’a réduit de 9 % supplémentaires.
exécutez d’abord /claude-api prompt-audit, puis collez :
lis mon CLAUDE.md et tous les fichiers qu’il importe. Propose une version de moins de 200 lignes : conserve les commandes de compilation et de test, les règles que Claude ne peut pas déduire du code et tout ce qui a déjà posé problème. Déplace le reste dans docs/ et ajoute un lien vers ces éléments depuis CLAUDE.md. Montre-moi le diff et ne change rien avant que je te dise de le faire.
vous obtenez un CLAUDE.md plus court, débarrassé des anciennes consignes rituelles, ainsi qu’une liste de serveurs à désactiver.
un contexte court rend chacun de vos tours moins coûteux.
choisissez le modèle en fonction de la tâche
les tarifs par million de jetons :
• Haiku 5.5 : 0,10 $ en entrée, 0,50 $ en sortie pour les invites jusqu’à 100K jetons ; 0,50 $ et 2,50 $ au-delà.
• Sonnet 5.5 : 2 $ en entrée, 10 $ en sortie.
• Opus 5.5 : 4 $ en entrée, 20 $ en sortie.
• Fable 5.2 : 8 $ en entrée, 40 $ en sortie.
Les recommandations de départ d’Anthropic :
• Haiku 5.5 : classification, routage, extraction et sous-agents qui recherchent des fichiers, lisent des journaux ou résument des informations.
• Sonnet 5.5 : programmation bien délimitée, comme des corrections de bogues et des fonctionnalités conformes à une spécification, discussion, documents courants et tâches d’agent répétées régulièrement.
• Opus 5.5 en medium : ingénierie et débogage au quotidien, ainsi que tout ce dont vous n’êtes pas sûr. C’est le modèle par défaut de Claude Code.
• Fable 5.2 : refactorisations et migrations majeures, architecture, recherche approfondie et coordination de nombreux sous-agents. Passez-y si Opus 5.5 en high ne suffit toujours pas.
un prix par jeton plus élevé ne signifie pas toujours un prix par tâche plus élevé. Sur FrontierCode 2.0, Fable 5.2 en high a obtenu un score proche de celui d’Opus 5.5 en max, 45,3 % contre 45,5 %, pour environ la moitié du coût par tâche. Avant de pousser Opus au-delà de high pour une tâche difficile, essayez Fable avec un effort moindre.
changez de modèle à une pause naturelle. Le cache appartient au modèle qui l’a créé : le premier tour avec un nouveau modèle paie l’écriture de toute la conversation. Exécutez d’abord /compact ou repartez de zéro avec un plan écrit succinct.
l’alias opusplan planifie avec Opus et laisse Sonnet effectuer les modifications. Vos changements de code sont ainsi confiés au modèle moins coûteux, à l’inverse de la configuration des agents de lecture ci-dessus : mesurez les résultats sur vos propres tâches avant d’en faire votre réglage par défaut.
collez :
lis todo.md. Pour chaque tâche, indique le modèle et le niveau d’effort de départ : Haiku pour les recherches rapides et la lecture de journaux, Sonnet pour les corrections bien délimitées conformes à une spécification, Opus en medium pour le travail courant et tout ce qui est flou, Fable pour les migrations, les grosses refactorisations et les tâches qui coordonnent de nombreux sous-agents. Enregistre routing.md avec une ligne par tâche et sa justification. Ne change aucun réglage.
vous obtenez routing.md : un modèle et un niveau d’effort pour chaque tâche avant de commencer.
Opus par défaut, Haiku pour la lecture, Fable quand Opus en high ne suffit pas.
un responsable et des agents à bas coût
quand une tâche ne tient pas dans une seule fenêtre de contexte, confiez-la au modèle le plus puissant et répartissez les sous-tâches entre des modèles moins coûteux.
dans un benchmark interne qui recherchait des défauts dans environ 22 millions de jetons de code source, un responsable Opus 5.5 assisté par des agents Sonnet 5.5 — jusqu’à 25 simultanément — a coûté environ un tiers de moins qu’Opus 5.5 seul à son effort par défaut, pour un score à peu près équivalent.
évitez cette méthode si le travail consiste en une seule chaîne d’étapes dépendantes ou tient dans une seule fenêtre de contexte. Dans ces cas, la planification et la fusion coûtent plus qu’elles ne rapportent.
gardez les équipes réduites. Les équipes d’agents, une fonctionnalité expérimentale, exécutent chaque coéquipier dans sa propre instance de Claude Code. La documentation tarifaire d’Anthropic estime qu’une équipe consomme environ 7 fois plus de jetons qu’une session standard lorsque ses membres travaillent en mode planification. Arrêtez chaque coéquipier une fois sa partie terminée.
l’outil advisor associe un exécutant peu coûteux à un conseiller plus puissant qu’il peut solliciter. Dans le tableau d’Anthropic, aucune des 4 associations ne surpasse clairement l’exécutant seul : mesurez la fréquence à laquelle votre exécutant demande de l’aide avant de payer pour un conseiller.
collez :
divise [la tâche] en parties indépendantes qui tiennent chacune dans une seule fenêtre de contexte. Tu es le responsable : rédige le plan dans plan.md, puis confie chaque partie à un sous-agent Sonnet en lui indiquant la liste des fichiers qu’il peut modifier, et fusionne les résultats. Deux parties ne doivent jamais modifier le même fichier. Lance les tests après chaque fusion. Montre-moi plan.md avant de lancer le moindre sous-agent.
vous obtenez plan.md, les sous-tâches réalisées en parallèle avec Sonnet, et Opus réservé au plan et aux fusions.
le responsable décide, les agents lisent et tapent.
mesurez les résultats sur votre propre travail
tous les chiffres ci-dessus viennent des essais d’Anthropic. Les vôtres dépendent de votre base de code et de vos habitudes.
• /usage à la fin d’une tâche affiche les jetons, la part du cache et un coût estimé en dollars au tarif catalogue. /cost fait la même chose. Avec un forfait Pro, Max, Team ou Enterprise, le montant en dollars donne une indication de la quantité de travail effectuée, et le même écran affiche vos barres d’utilisation.
• /effort status affiche votre niveau d’effort, et /tasks indique quel modèle utilise chaque sous-agent.
• pour une équipe, l’API Claude Code Analytics fournit un coût estimé par utilisateur, et l’API Usage and Cost ventile les dépenses par modèle et distingue les jetons mis en cache de ceux qui ne le sont pas.
• référence tirée de la documentation tarifaire d’Anthropic : environ 13 $ par développeur et par jour actif dans les déploiements d’entreprise, et moins de 30 $ par jour pour 90 % des utilisateurs.
choisissez une tâche réelle de votre backlog et exécutez-la avec 2 configurations. Collez ceci une fois pour chaque configuration :
Je compare 2 configurations sur la même tâche. La tâche : [tâche]. Effectue-la, lance son test et, une fois terminé, indique-moi combien de tours tu as utilisés et ce qui aurait permis de les réduire. Ne pousse rien.
après chaque exécution, vérifiez /usage, puis /clear, changez de configuration avec /model ou /effort, et collez de nouveau la demande.
vous obtenez votre propre coût par tâche pour chaque configuration.
c’est votre propre résultat /usage qui fait foi.
un seul texte à coller configure les agents de lecture Haiku, le CLAUDE.md raccourci et le routage des modèles. Ouvrez Claude Code dans votre dépôt et collez :
aide-moi à dépenser moins dans Claude Code, une étape à la fois. Après chaque étape, montre-moi le changement et attends mon « vas-y ».
1. Crée ~/.claude/agents/Explore.md : name Explore, une description indiquant qu’il s’agit d’un agent de recherche rapide en lecture seule, tools Read, Grep, Glob, model: haiku, omitClaudeMd: true, et un corps précisant qu’il ne fait que rechercher et lire, sans jamais créer ni modifier de fichiers.
2. Crée .claude/agents/log-reader.md avec model: haiku. Il lit les résultats de tests et les journaux et signale chaque échec avec le fichier, le nom du test et la première ligne d’erreur. Il ne modifie jamais de fichiers.
3. Lis CLAUDE.md et tous les fichiers qu’il importe, puis propose une version de moins de 200 lignes. Déplace le reste dans docs/.
4. Liste les serveurs MCP dans ma configuration et indique ceux que ce dépôt n’utilise jamais.
5. Lis todo.md et rédige routing.md avec un modèle et un niveau d’effort de départ pour chaque tâche.
ne modifie aucun autre réglage, ne pousse rien et ne supprime rien sans demander.
après avoir collé le texte, vous aurez :
• Explore et un agent de lecture de journaux sur Haiku.
• un CLAUDE.md de moins de 200 lignes, avec le reste dans docs/.
• une liste des serveurs MCP à désactiver.
• routing.md : un modèle et un niveau d’effort pour chaque tâche.
la configuration en une page
EXPLORE ~/.claude/agents/Explore.md, model: haiku, omitClaudeMd: true.
LECTURE sous-agents de lecture des journaux et de recherche sur haiku. Les modifications de code restent confiées au modèle principal.
EFFORT medium par défaut. Lots en low, échecs relancés en high.
VÉRIFICATION un test ou une compilation que Claude peut exécuter, avant d’augmenter l’effort.
CACHE abonnement : 1 heure, clé API : 5 minutes. /compact avant une pause.
CONTEXTE CLAUDE.md de moins de 200 lignes. Serveurs MCP inutilisés désactivés.
MODÈLE haiku pour la lecture, sonnet pour les tâches ciblées, opus au quotidien, fable pour les plus difficiles.
ÉQUIPES responsable opus + agents sonnet seulement si la tâche ne tient pas dans une seule fenêtre de contexte.
VÉRIFIER /usage après les tâches réelles, /tasks pour les modèles des sous-agents.
faites-en une capture d’écran.
ce soir, enregistrez le fichier Explore, redémarrez Claude Code et exécutez /tasks la prochaine fois qu’il recherche dans votre code.