@SpaceandTime L’IA commence à acheter des données toute seule, mais elle ne sait même pas quand elle se trompe dans ses calculs
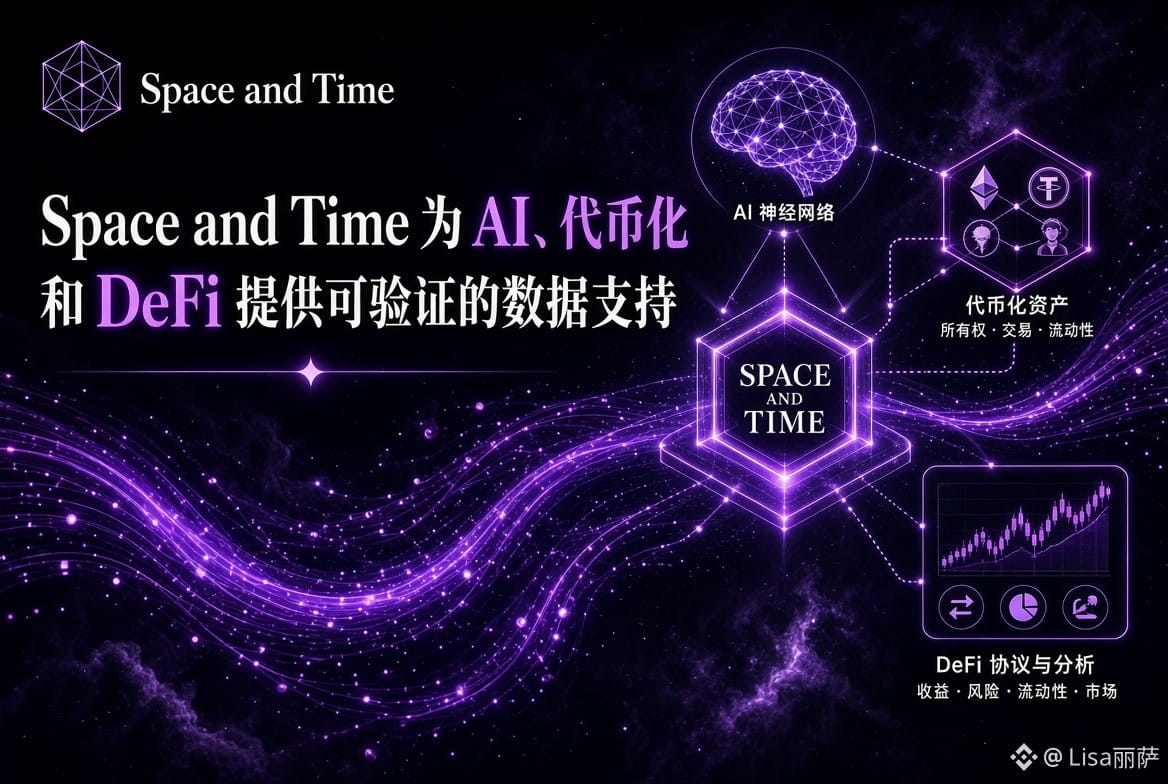
Ces deux derniers jours, j’ai branché un agent de requête de données sur un environnement de démonstration et lui ai soumis des dizaines de questions. Le plus inquiétant, ce n’est pas qu’il se trompe, mais que le ton soit exactement le même quand il a tort et quand il a raison. La version Enterprise lancée par Space and Time le 9 novembre tombe pile sur ce problème. La logique est simple : les calculs sont effectués sur des données privées, et un reçu cryptographique Proof of SQL est généré. Avant de transmettre le résultat à l’agent, l’application vérifie le reçu. Une fois celui-ci validé, l’agent peut agir. Les données restent dans la base et le processus de calcul est vérifiable. Cette promesse va prendre beaucoup de valeur dès que les agents commenceront à appeler des API de leur propre initiative. De mon côté, j’ai d’abord connecté une table métier, puis lancé une requête avec le SDK, récupéré le résultat et la preuve, avant de vérifier cette dernière dans un contrat on-chain. La première mise en route m’a pris à peu près un après-midi. Le blocage ne venait pas de la cryptographie, mais de la configuration de l’environnement et du fait qu’il faut d’abord déterminer quelle table mérite d’être vérifiée. Cet obstacle est bien réel, mais il permet d’obtenir quelque chose de très concret : l’exactitude du résultat ne dépend plus de la personne à qui l’on fait confiance. Par rapport à une solution d’oracle de prix comme Chainlink, celle-ci vous dit combien vaut un nombre à l’instant présent ; SXT vous indique selon quelle méthode et à partir de quelle table ce nombre a été calculé. Par rapport à un tableau de bord en lecture seule comme Dune, la différence, c’est que le second ne peut vous fournir qu’une capture d’écran, tandis que le premier peut vous remettre un reçu. Laisser une IA prendre des décisions à partir de captures d’écran, ce n’est qu’une question de temps avant que ça tourne mal. Il y a aussi un effet secondaire auquel je n’avais pas pensé au début. Avec les preuves, chaque décision de l’agent peut être rejouée. En cas de problème, on peut retrouver précisément quelle requête a utilisé quelles données. L’attribution des responsabilités est plus claire qu’en épluchant les journaux, mais aussi plus coûteuse. Je ne m’intéresse donc pas tellement à l’engouement autour de son discours actuel. Ce qui m’intéresse, c’est de savoir qui pourra prélever un péage au niveau du reçu lorsque les agents commenceront vraiment à appeler des API et à dépenser de l’argent pour acheter des données. #sxt $SXT
Ces deux derniers jours, j’ai branché un agent de requête de données sur un environnement de démonstration et lui ai soumis des dizaines de questions. Le plus inquiétant, ce n’est pas qu’il se trompe, mais que le ton soit exactement le même quand il a tort et quand il a raison. La version Enterprise lancée par Space and Time le 9 novembre tombe pile sur ce problème. La logique est simple : les calculs sont effectués sur des données privées, et un reçu cryptographique Proof of SQL est généré. Avant de transmettre le résultat à l’agent, l’application vérifie le reçu. Une fois celui-ci validé, l’agent peut agir. Les données restent dans la base et le processus de calcul est vérifiable. Cette promesse va prendre beaucoup de valeur dès que les agents commenceront à appeler des API de leur propre initiative. De mon côté, j’ai d’abord connecté une table métier, puis lancé une requête avec le SDK, récupéré le résultat et la preuve, avant de vérifier cette dernière dans un contrat on-chain. La première mise en route m’a pris à peu près un après-midi. Le blocage ne venait pas de la cryptographie, mais de la configuration de l’environnement et du fait qu’il faut d’abord déterminer quelle table mérite d’être vérifiée. Cet obstacle est bien réel, mais il permet d’obtenir quelque chose de très concret : l’exactitude du résultat ne dépend plus de la personne à qui l’on fait confiance. Par rapport à une solution d’oracle de prix comme Chainlink, celle-ci vous dit combien vaut un nombre à l’instant présent ; SXT vous indique selon quelle méthode et à partir de quelle table ce nombre a été calculé. Par rapport à un tableau de bord en lecture seule comme Dune, la différence, c’est que le second ne peut vous fournir qu’une capture d’écran, tandis que le premier peut vous remettre un reçu. Laisser une IA prendre des décisions à partir de captures d’écran, ce n’est qu’une question de temps avant que ça tourne mal. Il y a aussi un effet secondaire auquel je n’avais pas pensé au début. Avec les preuves, chaque décision de l’agent peut être rejouée. En cas de problème, on peut retrouver précisément quelle requête a utilisé quelles données. L’attribution des responsabilités est plus claire qu’en épluchant les journaux, mais aussi plus coûteuse. Je ne m’intéresse donc pas tellement à l’engouement autour de son discours actuel. Ce qui m’intéresse, c’est de savoir qui pourra prélever un péage au niveau du reçu lorsque les agents commenceront vraiment à appeler des API et à dépenser de l’argent pour acheter des données. #sxt $SXT