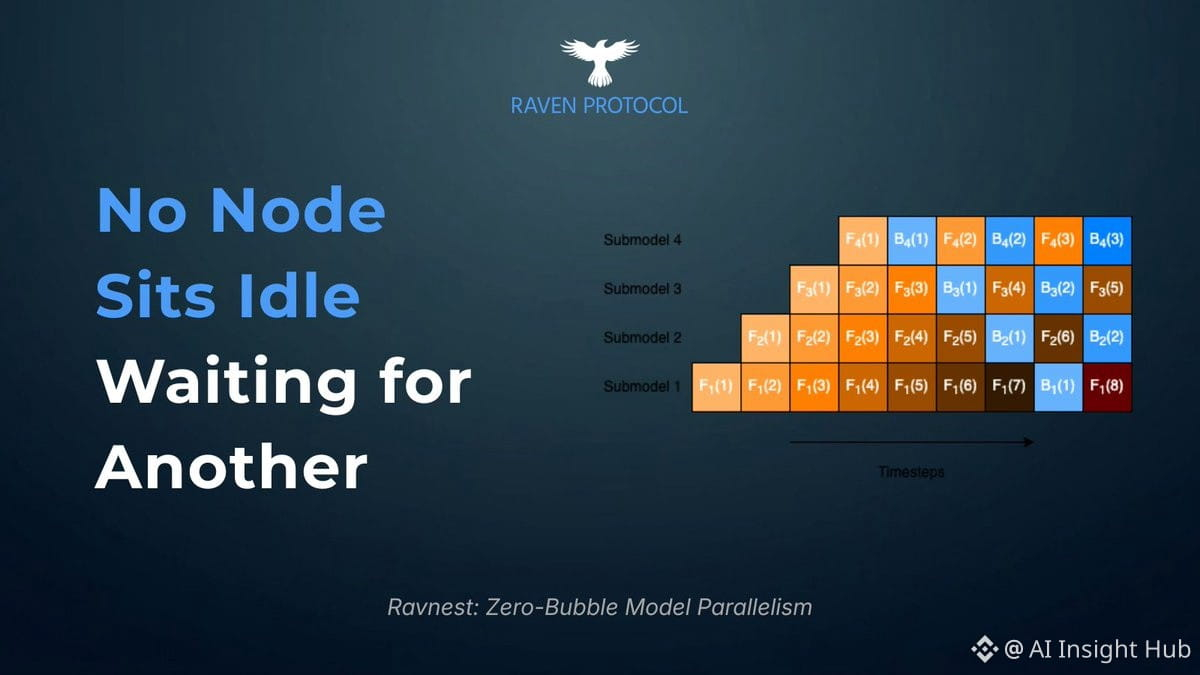
Le parallélisme en pipeline cache un lourd secret : les entraînements sur 4 machines peuvent gaspiller 75 % du temps de calcul à ne rien faire, même lorsque tout fonctionne parfaitement.
C’est le problème de la bulle de pipeline. Quand on répartit un modèle sur plusieurs machines, chaque étape attend que la précédente ait terminé avant de commencer son travail. La machine 1 traite le lot A → la machine 2 reste inactive. La machine 2 reçoit enfin le lot A → la machine 3 attend. Cette dépendance séquentielle crée d’immenses périodes d’inactivité.
Ravnest affirme avoir conçu un parallélisme de modèles sans bulle qui élimine complètement ce temps d’attente. Si c’est vrai, l’entraînement distribué serait 4 fois plus efficace sans qu’il soit nécessaire de changer de matériel.
La question clé : comment planifient-ils le travail pour que toutes les machines restent actives en même temps ? Le pipeline traditionnel est intrinsèquement séquentiel. Pour y remédier, il faut soit entrelacer intelligemment les lots, soit repenser la façon dont les gradients remontent le pipeline.
Pour les développeurs d’IA open source qui utilisent plusieurs GPU : les bulles de pipeline expliquent pourquoi vos graphiques d’utilisation des GPU sont si mauvais pendant l’entraînement distribué. Vous payez pour 4 GPU, mais vous n’obtenez que la puissance de calcul réelle de 1,5 GPU.
C’est le problème de la bulle de pipeline. Quand on répartit un modèle sur plusieurs machines, chaque étape attend que la précédente ait terminé avant de commencer son travail. La machine 1 traite le lot A → la machine 2 reste inactive. La machine 2 reçoit enfin le lot A → la machine 3 attend. Cette dépendance séquentielle crée d’immenses périodes d’inactivité.
Ravnest affirme avoir conçu un parallélisme de modèles sans bulle qui élimine complètement ce temps d’attente. Si c’est vrai, l’entraînement distribué serait 4 fois plus efficace sans qu’il soit nécessaire de changer de matériel.
La question clé : comment planifient-ils le travail pour que toutes les machines restent actives en même temps ? Le pipeline traditionnel est intrinsèquement séquentiel. Pour y remédier, il faut soit entrelacer intelligemment les lots, soit repenser la façon dont les gradients remontent le pipeline.
Pour les développeurs d’IA open source qui utilisent plusieurs GPU : les bulles de pipeline expliquent pourquoi vos graphiques d’utilisation des GPU sont si mauvais pendant l’entraînement distribué. Vous payez pour 4 GPU, mais vous n’obtenez que la puissance de calcul réelle de 1,5 GPU.