


Auteur : David Christopher, Bankless
Traduction : 深潮 TechFlow
Introduction de 深潮 : MegaETH, le projet Ethereum L2 qui misait autrefois sur des performances extrêmes, a officiellement été rebaptisé MEGA. Le projet a annoncé qu’il prélèverait 30 millions de dollars sur sa trésorerie pour se réorienter vers le développement de produits en interne. Sa première application, axée sur le marché décentralisé de l’inférence IA, devrait être lancée en décembre.
Face à l’homogénéisation croissante des technologies de vérification des modèles sur le marché, prouver simplement qu’un nœud « n’a pas été compromis » ne suffit plus à établir un avantage concurrentiel durable. Cet article analyse en profondeur les deux idées de différenciation les plus remarquables du livre blanc de MEGA : la désensibilisation des données personnelles sans dépendre d’une perspective centralisée, et des contrats à terme sur la puissance de calcul, particulièrement prometteurs pour l’avenir.
Mardi dernier, la fondation MegaETH a officiellement changé de nom pour devenir MEGA et a annoncé l’allocation de 30 millions de dollars provenant du trésor au développement de produits conçus en interne. Le produit phare annoncé est un marché d’inférence IA (Inference Market), dont le lancement est prévu en décembre.
Le marché de l’inférence est un secteur émergent que je suis de près depuis quelque temps : sur ces marchés ouverts, tout le monde peut acheter, vendre ou revendre des droits d’accès à des modèles d’IA, généralement à un prix inférieur aux tarifs officiels des grands laboratoires. La demande est actuellement très forte, et l’utilisation de la plupart des marchés d’inférence augmente régulièrement.
Ce créneau étant encore à ses débuts, et la financiarisation des services d’IA étant tout juste naissante, je pense que, pour l’équipe de MegaETH — qui a créé une solution Ethereum de couche 2 à la « vitesse extrême » —, ce virage est certes radical, mais reste une décision judicieuse.
Ce changement de cap répond aussi à une certaine urgence bien réelle. La TVL de cette blockchain ne dépasse actuellement pas 10 millions de dollars, un net recul par rapport au sommet de 245 millions de dollars atteint en mai. La cofondatrice Shuyao Kong a également reconnu sur X : « Après avoir créé la blockchain la plus rapide sans parvenir à trouver une adéquation produit-marché (PMF) », l’équipe devait changer de direction.
Les modalités précises du nouveau marché de l’inférence, ses fournisseurs de calcul et la liste des modèles disponibles restent confidentielles avant son lancement officiel. Mais un livre blanc de trois pages esquisse déjà les grandes lignes de la stratégie de l’équipe.
Examinons les principales propositions de ce récit commercial, voyons où se trouvent ses points les plus faibles et ce qui pourrait encore permettre à MEGA de se démarquer.
Dans un message publié sur X, le compte officiel de MEGA (@mega_holdings) a annoncé : « Aujourd’hui, nous nous engageons à investir 30 millions de dollars pour créer de nouveaux produits sur MegaETH, en commençant par l’inférence IA. Pour en savoir plus : mega.holdings. »
Les grandes lignes de la thèse
MEGA fonde sa stratégie sur ce qu’elle appelle le « paradoxe de l’offre » : de nombreux fournisseurs de calcul tiers proposent l’exécution d’un même modèle open source à un tarif bien inférieur à celui du laboratoire qui l’a développé.
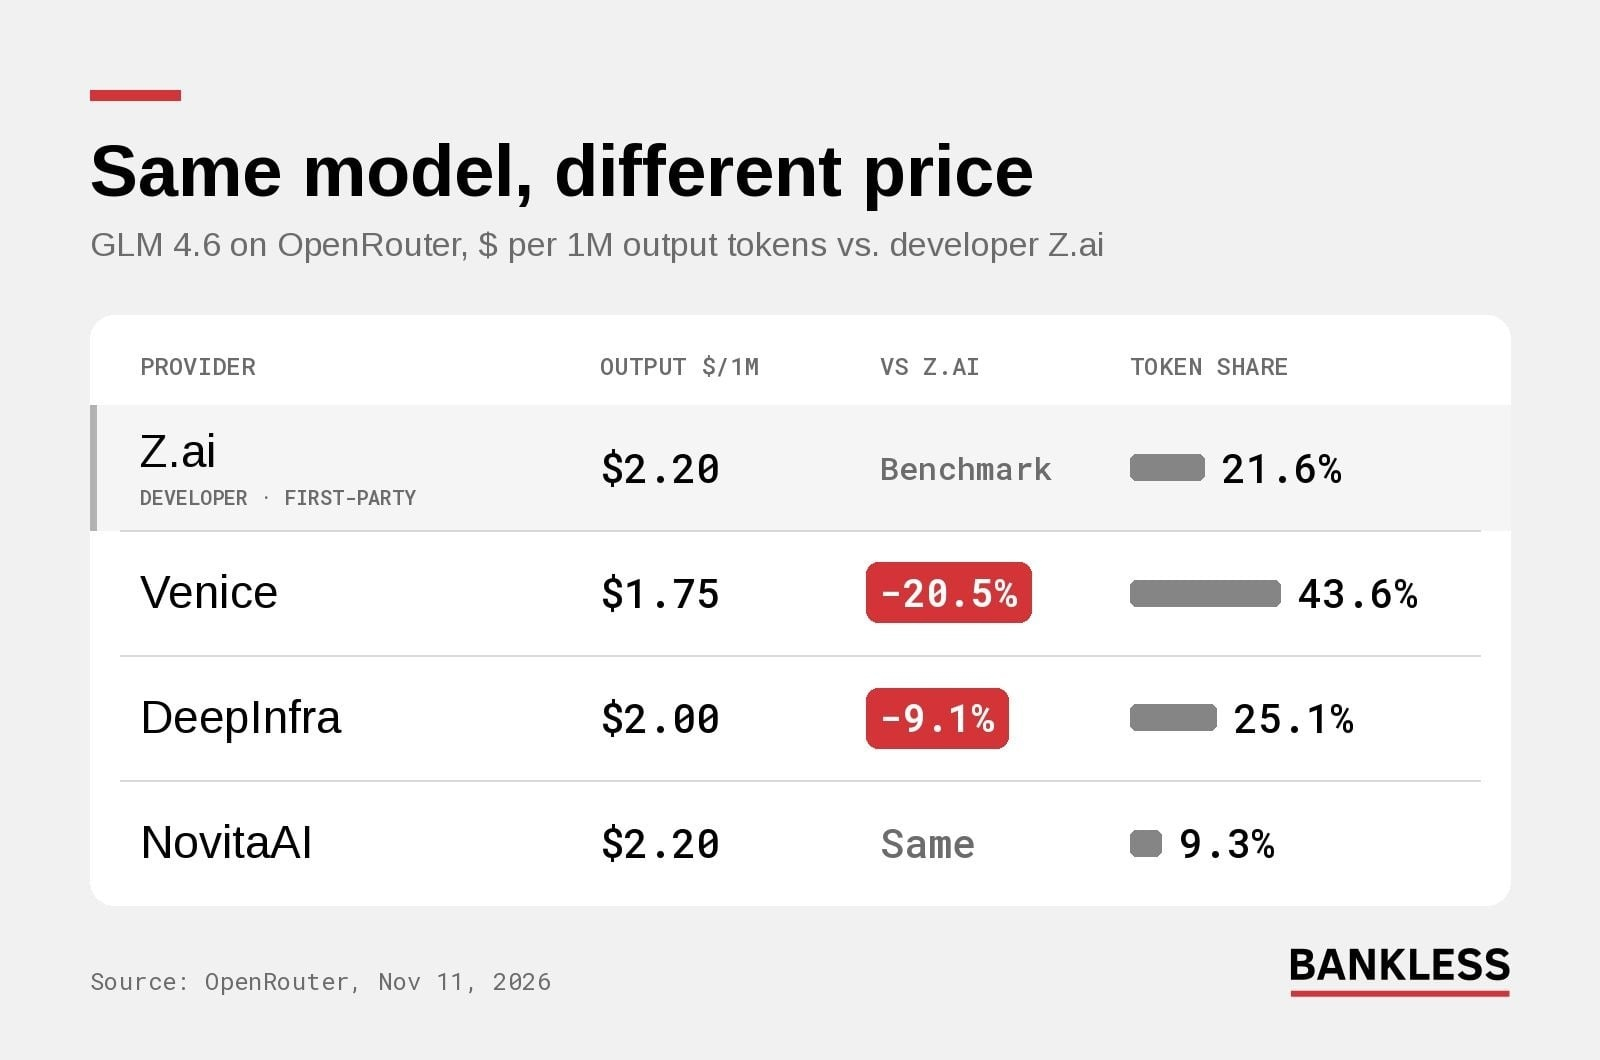
Prenons l’exemple de la plateforme OpenRouter : pour un million de tokens générés par GLM 4.6, le développeur Z.ai facture 2,20 $, contre seulement 1,75 $ chez le fournisseur tiers Venice. Malgré cet écart de prix évident, MEGA estime que la grande majorité des acheteurs préfère payer plus cher pour passer par un canal officiel connu.
Pour y remédier, MEGA propose un ensemble de mécanismes de vérification appelé « intelligence purifiée » (Purified Intelligence). Il s’agirait de vérifier l’authenticité des modèles utilisés par les fournisseurs, leur conformité en matière de confidentialité et leur sécurité, afin de démontrer que des tiers moins connus sont tout aussi dignes de confiance.
L’objectif ultime est de créer un marché où les capacités d’inférence seraient entièrement standardisées. Comme l’indique le livre blanc, dans l’idéal, « l’identité du fournisseur de ce service d’inférence deviendra de moins en moins importante ».
Autrement dit, tout ce récit repose sur l’établissement de la confiance, et plus particulièrement sur la vérification de l’exécution réelle du modèle demandé. C’est précisément là que j’ai commencé à avoir des doutes.
Sans MEGA, les technologies de vérification progressent déjà à grands pas
Tout d’abord, le postulat de départ de MEGA sur le secteur n’est pas entièrement fondé.
Les fournisseurs de calcul à bas prix ne sont pas boudés par le marché. La plateforme populaire de routage d’inférence OpenRouter privilégie déjà les canaux les moins chers dans son routage par défaut. Elle attribue par ailleurs la plupart des différences de qualité des résultats entre fournisseurs à des différences de configuration de leurs logiciels d’appel d’outils (tool-calling), et non à une substitution délibérée des modèles.
Le « remplacement de modèle » (Model Swapping), que le livre blanc condamne comme l’un de ses principaux problèmes, existe bel et bien. Toutefois, les preuves les plus solides concernent surtout des circuits parallèles de revente non autorisés. Une étude publiée en mars dernier, après avoir testé trois revendeurs opaques de ce type, a révélé un taux d’échec de 46 % pour la vérification de l’identité des modèles.
Plus important encore, les outils permettant de détecter ces substitutions se multiplient rapidement de toutes parts :
• Empreintes numériques (Fingerprinting) : la semaine dernière, le marché de l’inférence Antseed a lancé une nouvelle couche de vérification par empreinte numérique. Le système soumet les vendeurs de calcul à des questions de niche auxquelles seul un modèle donné devrait pouvoir répondre. S’il constate que le vendeur n’exécute pas le modèle annoncé, il redirige immédiatement les requêtes des acheteurs vers d’autres fournisseurs.
• Matériel sécurisé (TEE) : un environnement d’exécution de confiance (TEE) est une zone sécurisée à l’intérieur de la puce, inaccessible même à son propriétaire, qui permet de prouver publiquement quel code y est exécuté. Les acheteurs d’Antseed peuvent déjà demander directement aux fournisseurs d’activer cette vérification matérielle.
• Preuves cryptographiques : au début du mois, Anthropic a publié en open source un prototype de solution, FlashProve, qui vérifie mathématiquement qu’une réponse a bien été générée par les poids d’un modèle donné, même si chaque inférence exige entre 70 et 95 fois plus de puissance de calcul qu’une requête ordinaire.
Par ailleurs, l’équipe de Pearl développe également sa propre version du système de preuve en s’appuyant sur Attestable.
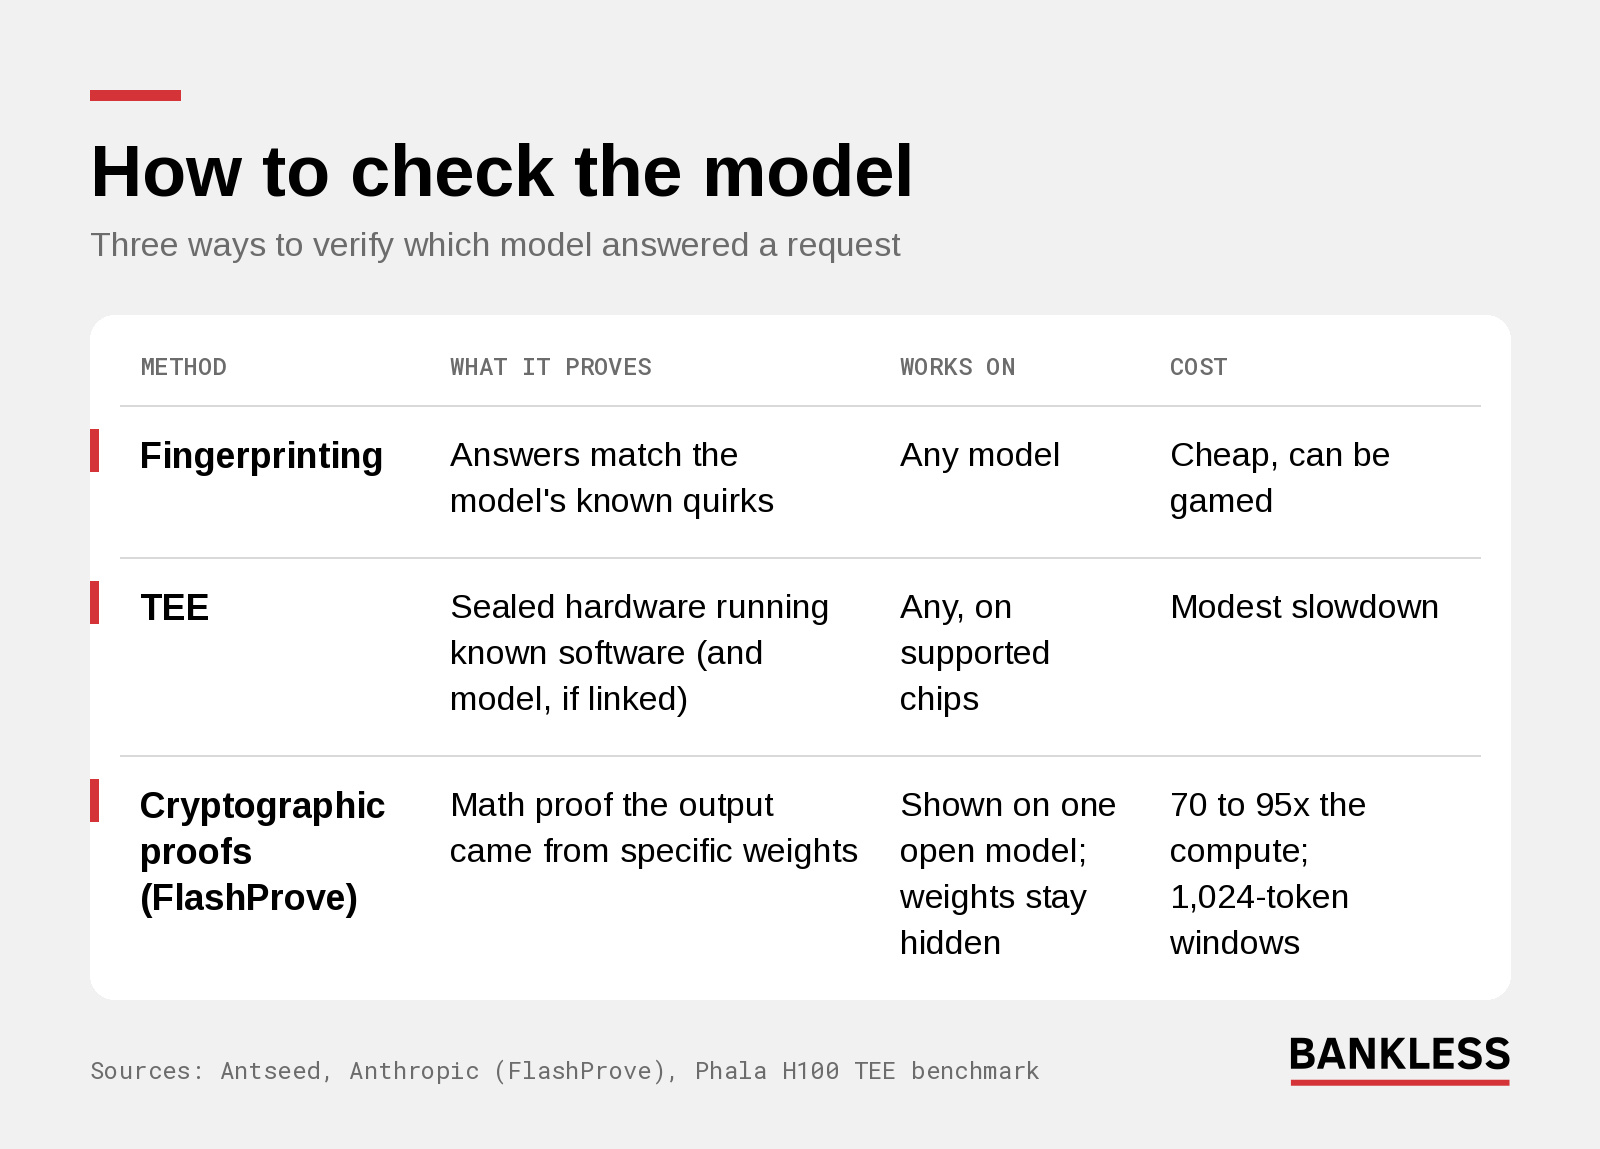
Le livre blanc de MEGA mentionne également ces trois solutions et reconnaît leurs limites techniques respectives, sans préciser laquelle l’équipe compte finalement adopter. Elle intégrera probablement une ou plusieurs d’entre elles, ce qui est bien sûr une démarche louable.
Pourtant, la réalité est qu’un grand nombre d’équipes s’attaquent déjà au même problème, et que la grande majorité des outils de vérification sont open source et accessibles à l’ensemble du secteur. La méfiance des acheteurs envers les prestataires tiers s’estompe rapidement ; le simple lancement d’une fonctionnalité de « vérification des modèles » ne suffit plus vraiment à distinguer MEGA.
Les deux pistes qui pourraient vraiment permettre à MEGA de se démarquer
Dès lors, les éléments susceptibles de véritablement différencier MEGA se trouvent dans deux autres idées majeures avancées dans le livre blanc.
La première piste concerne la protection de la vie privée. MEGA envisage d’anonymiser et de nettoyer les données sensibles avant que le fournisseur de calcul ne voie les requêtes des utilisateurs, puis de répartir les tâches complexes entre des nœuds de confiance et des nœuds non fiables. Cette conception répond à un véritable besoin : aujourd’hui, les solutions de protection de la vie privée capables d’empêcher les prestataires d’espionner les prompts grâce à du matériel sécurisé restent, pour la plupart, limitées aux modèles open source.
Pour utiliser en toute sécurité des modèles de pointe propriétaires tout en préservant la vie privée, le « nettoyage local des informations sensibles » est presque la seule voie de compromis. Mais sa mise en œuvre technique est tout aussi complexe.
L’an dernier, Freysa avait lancé une fonctionnalité similaire dans son application Enchanted, désormais rebaptisée Silo. Celle-ci remplaçait les mots et expressions confidentiels par des espaces réservés, afin de permettre aux utilisateurs d’accéder en toute sécurité à des modèles propriétaires comme GPT et Claude.
Mais en novembre 2025, Freysa a annoncé que, les performances réelles des téléphones étant très variables, l’équipe avait dû déplacer les calculs d’anonymisation hors des appareils mobiles. Le journal des mises à jour de juillet de son application iOS indiquait encore plus clairement que cette fonctionnalité avait été désactivée et supprimée.
De même, le processus d’anonymisation de MEGA devra se dérouler entièrement hors de portée de MEGA, par exemple en étant exécuté exclusivement sur l’ordinateur local de l’utilisateur ou sur du matériel sécurisé. Dans le cas contraire, l’utilisateur ne ferait que confier à MEGA les informations sensibles qu’il aurait dû remettre au fournisseur d’inférence.
Lors de la publication du livre blanc ces derniers jours, Yilong Li, cofondateur de MegaETH (@yilongl_megaeth), a également déclaré : « Accroître les capacités de calcul de l’IA ne résout que la moitié du problème. Même si un fournisseur dispose du bon modèle, d’une grande capacité de calcul disponible et de tarifs plus bas, les utilisateurs ne passeront pas à l’achat s’ils ne peuvent pas être sûrs que le fournisseur exécute bien le modèle annoncé et protège leurs données. »
Le deuxième atout majeur est la capacité de calcul à terme (Future Capacity). Le livre blanc de MEGA imagine un mécanisme permettant aux acheteurs de réserver à l’avance, pour une période déterminée et à un prix fixé, un modèle précis, un volume d’appels défini et des performances minimales (notamment en matière de vitesse de réponse et de stabilité). À l’avenir, ces contrats de capacité à terme pourraient aussi être transférés sur un marché secondaire.
On peut comparer cela à une entreprise qui réserve des chambres d’hôtel plusieurs mois à l’avance pour un grand sommet sectoriel. Les acheteurs peuvent ainsi garantir des capacités de calcul suffisantes avant le lancement d’un produit phare et, si leurs plans changent, les revendre. De leur côté, les fournisseurs de calcul peuvent utiliser ces engagements de demande comme garantie pour obtenir des prêts et acheter davantage de GPU afin d’accroître leurs capacités.
Si les échanges de ce type de contrats prennent de l’ampleur, le marché fera émerger une « courbe transparente des prix à terme de l’inférence ». Les contrats à terme sur les capacités de calcul des GPU que des géants de la finance traditionnelle comme l’Intercontinental Exchange (ICE) prévoient de lancer peuvent certes couvrir le coût horaire de location des puces, mais ils ne permettent pas de préciser quel modèle sera exécuté ni la qualité des résultats. À l’inverse, les contrats à terme de MEGA sont directement indexés sur le « résultat même » du modèle.
Parmi tous les marchés d’inférence sur chaîne que j’ai évalués jusqu’à présent, aucun ne propose de mécanisme similaire. C’est précisément là que la blockchain peut le mieux exprimer sa valeur en matière d’établissement et de transfert des droits.
Mais une contradiction profonde se cache toujours ici : le coût de l’inférence de l’IA chute rapidement et les principaux modèles sont entièrement renouvelés tous les quelques mois. Pourquoi les acheteurs voudraient-ils alors verrouiller dès aujourd’hui un prix fixe, voire un modèle précis, pour plusieurs mois plus tard ?
Peut-être que les entreprises n’achètent pas un prix bas, mais la garantie d’avoir une « place assurée, sans interruption, pendant les périodes de pointe ». Ou peut-être cherchent-elles à se protéger contre l’explosion des factures d’utilisation lorsque les subventions extravagantes des grands fournisseurs d’IA prendront fin. Pour l’instant, je n’ai pas encore de réponse claire à cette question.
Les pièces essentielles du puzzle qui manquent encore
Pour l’instant, ces deux atouts majeurs n’en sont encore qu’au stade d’esquisses dans le livre blanc. L’équipe n’a publié aucun code, et le document n’explique pas clairement quels fournisseurs de calcul pourront être admis, qui sera chargé des vérifications et des audits, ni où les outils d’anonymisation finiront par être exécutés.
Le livre blanc ne mentionne pas non plus une seule fois le jeton natif. Interrogée sur le rôle du jeton MEGA dans le marché de l’inférence, Shuyao Kong a répondu à The Block : « Chaque fois qu’il y aura une possibilité de donner de l’utilité au jeton MEGA, nous l’exploiterons. »
Quant à l’allocation de 30 millions de dollars provenant du trésor, qui représente plus de la moitié de la capitalisation actuelle de MEGA en circulation, aucun budget détaillé n’a encore été publié.
Une partie des réponses devrait se dévoiler au fil du mois de décembre prochain. Je suivrai de près trois indicateurs de mise en œuvre : l’identité des premiers fournisseurs signataires et les critères d’admission, une solution d’anonymisation qui fonctionne réellement hors de portée de MEGA, et le premier contrat de capacité à terme conclu avec une contrepartie réelle.
En définitive, la vérifiabilité ne peut que placer MEGA sur la ligne de départ de la course à l’inférence. Seule la résolution des problèmes de confidentialité réelle et de livraison des capacités de calcul à terme déterminera si le projet parviendra à vraiment se démarquer.