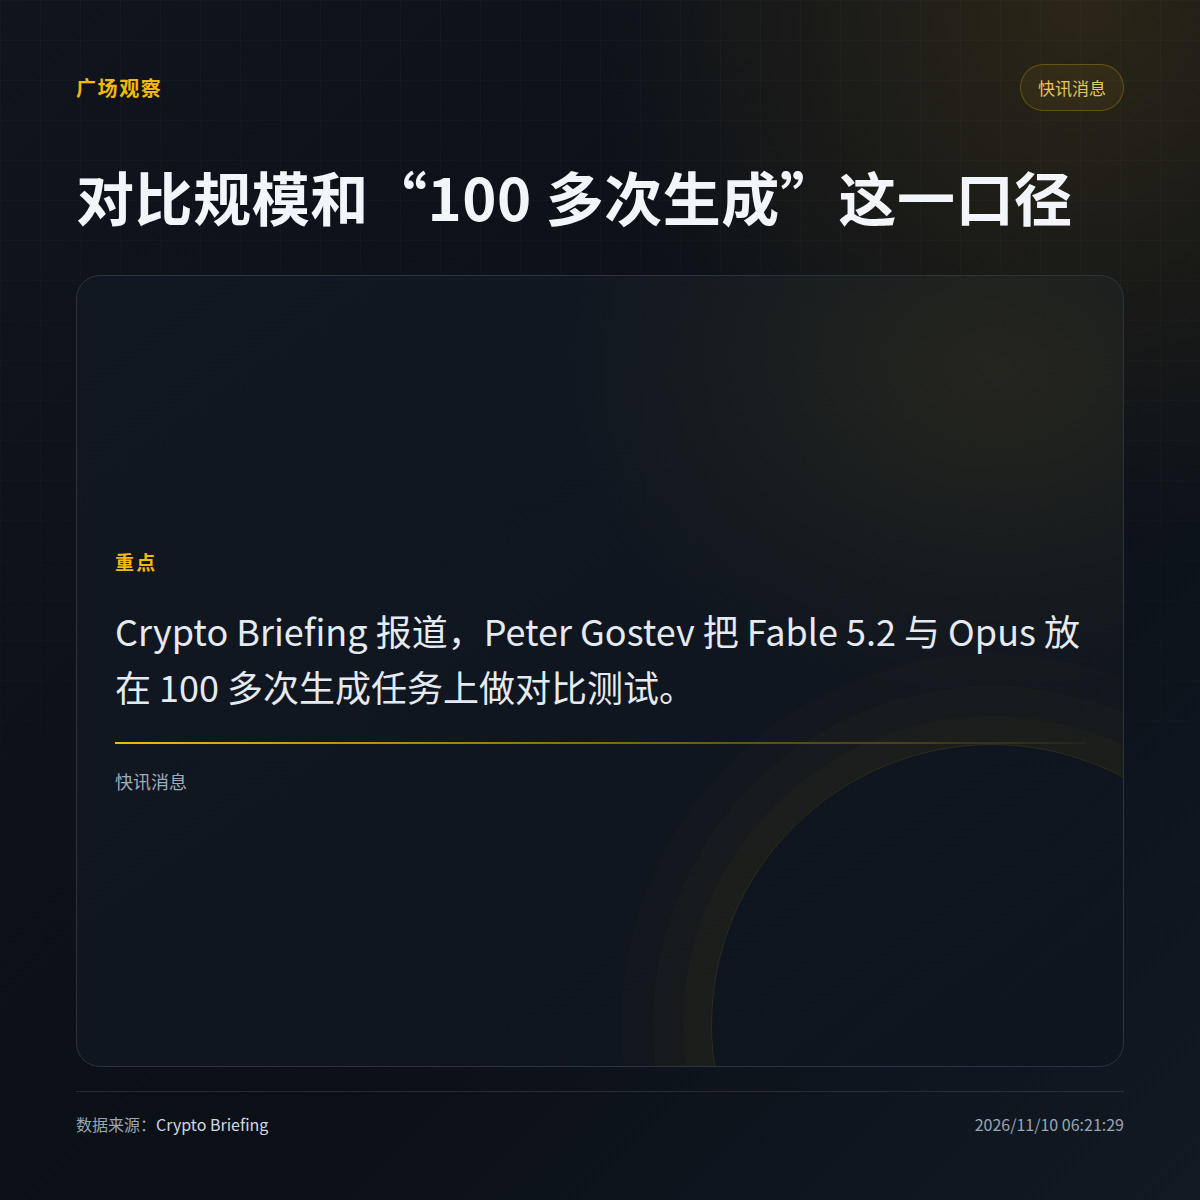
Peter Gostev a comparé Fable 5.2 et Opus, tour après tour, dans plus de 100 tâches de génération.
L’article de Crypto Briefing ne mentionne que les noms des deux modèles, l’ampleur de la comparaison et le chiffre de « plus de 100 générations », sans préciser les critères d’évaluation, le nombre de victoires de chacun ni le type de tâches testées.
· Considérer le nombre de générations comme la taille de l’échantillon permet de connaître le nombre de tests, mais ne constitue pas une mesure quantitative des capacités des modèles.
· En l’absence de résultats détaillés, affirmer que l’un est meilleur que l’autre relève uniquement des déclarations de la personne qui a organisé cette comparaison, et non d’une conclusion.
Si l’on ne vous montre que le taux de victoire global, préféreriez-vous d’abord voir les scores détaillés ou les échantillons de génération bruts ?
L’article de Crypto Briefing ne mentionne que les noms des deux modèles, l’ampleur de la comparaison et le chiffre de « plus de 100 générations », sans préciser les critères d’évaluation, le nombre de victoires de chacun ni le type de tâches testées.
· Considérer le nombre de générations comme la taille de l’échantillon permet de connaître le nombre de tests, mais ne constitue pas une mesure quantitative des capacités des modèles.
· En l’absence de résultats détaillés, affirmer que l’un est meilleur que l’autre relève uniquement des déclarations de la personne qui a organisé cette comparaison, et non d’une conclusion.
Si l’on ne vous montre que le taux de victoire global, préféreriez-vous d’abord voir les scores détaillés ou les échantillons de génération bruts ?