
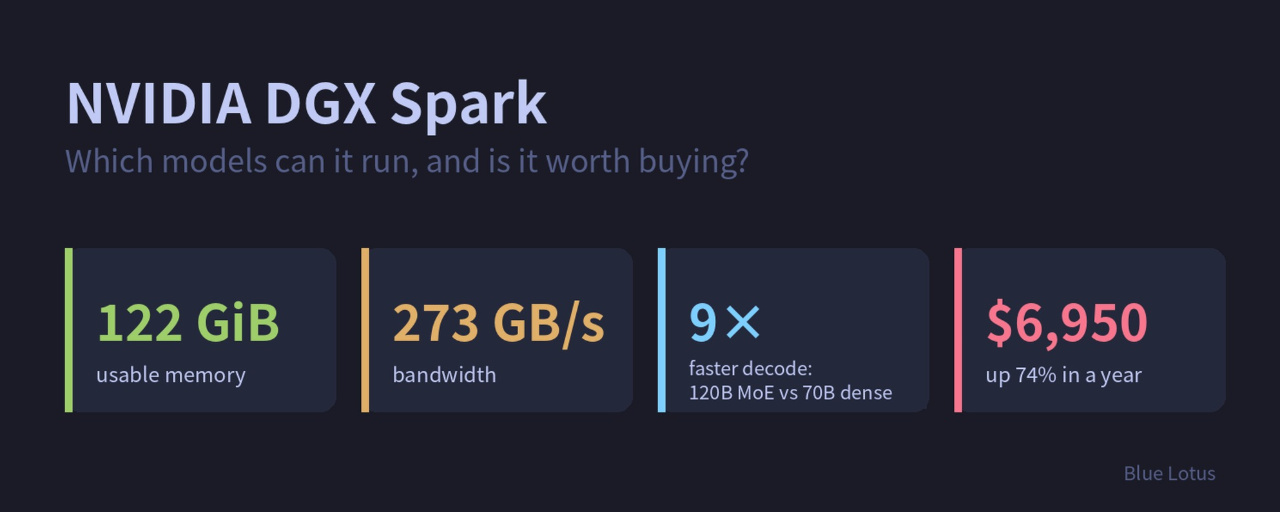
Le NVIDIA DGX Spark tient dans la paume de la main, et le système indique 121,93 Gio de mémoire utilisable. Ce chiffre peut donner envie de tirer une conclusion séduisante : si les 128 Go peuvent servir de mémoire GPU, il devrait forcément pouvoir exécuter n’importe quel grand modèle qu’on lui soumet, non ?
Pouvoir faire tenir un modèle en mémoire ne signifie pas qu’il s’exécutera rapidement. Ce que cette machine peut réellement faire dépend de deux chiffres, qui mesurent des choses très différentes.
Deux chiffres : capacité et bande passante
Le DGX Spark repose sur la puce GB10 de NVIDIA. Le CPU et le GPU se partagent un seul pool de 128 Go de mémoire LPDDR5x et, après la part réservée au système, il reste environ 122 Gio pour les modèles. À titre de comparaison, une RTX 5090 dispose de 32 Go de mémoire vidéo. En matière de capacité seulement, un Spark en offre autant que quatre cartes graphiques gaming haut de gamme.
Sa bande passante mémoire, en revanche, n’est que d’environ 273 Go/s. La RTX 5090 atteint 1,8 To/s, soit plus de six fois plus.
La capacité détermine si un modèle tient en mémoire. La bande passante détermine la vitesse à laquelle il répond.
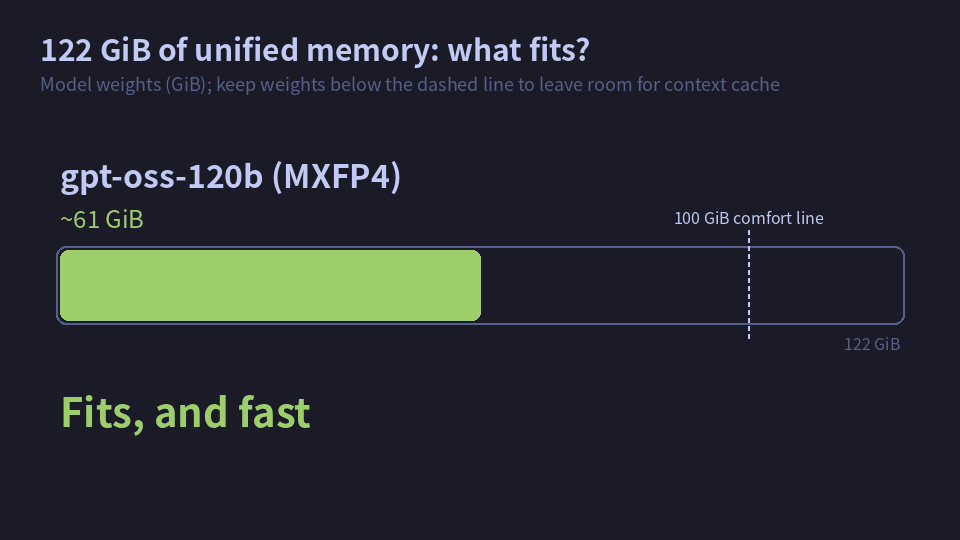
Classés par taille des poids : gpt-oss-120b occupe environ 61 Gio et GLM-4.5-Air en 4 bits environ 68 Gio. Les deux tiennent confortablement, avec plus de 40 Gio restants pour le cache de contexte. Qwen3-235B ne tient qu’en 3 bits, et l’espace vient alors à manquer. Un modèle de 671B comme DeepSeek V3 nécessite environ 380 Gio même en 4 bits : un seul Spark ne peut donc pas le faire tenir.
Règle pratique : gardez les poids sous les 100 Gio. Au-delà, il ne reste plus de place pour un cache de contexte long.
La vitesse se résume à une formule
Pour générer chaque jeton, le modèle doit lire en mémoire tous les poids utilisés à cette étape. Cela impose une limite stricte à la vitesse de génération pour un seul utilisateur :
Vitesse maximale de génération ≈ bande passante mémoire ÷ octets lus par jeton
Un Llama 70B en 4 bits (Q4_K_M) pèse environ 42,5 Go, et 273 ÷ 42,5 ≈ 6,4. C’est sa limite théorique, et les performances réelles sont inférieures.
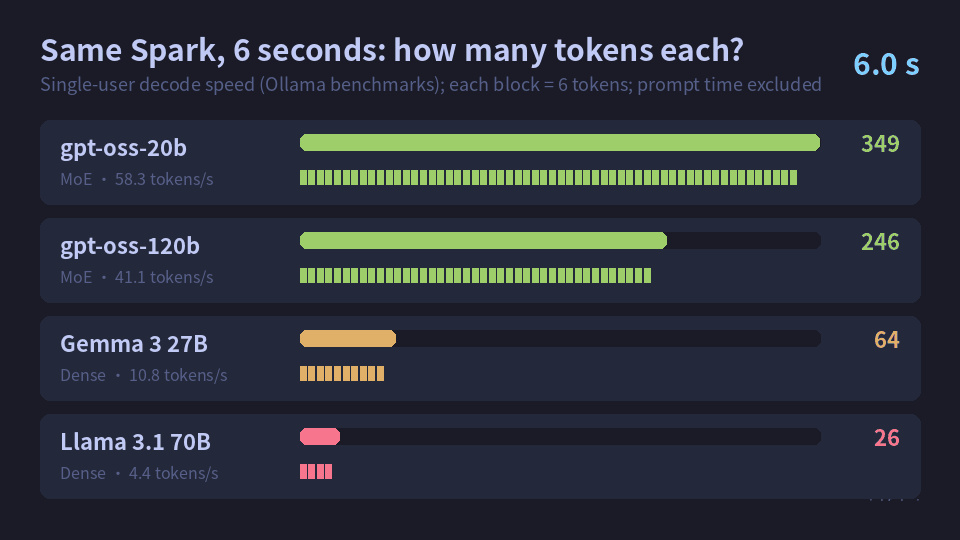
Tests de référence officiels d’Ollama sur le DGX Spark :
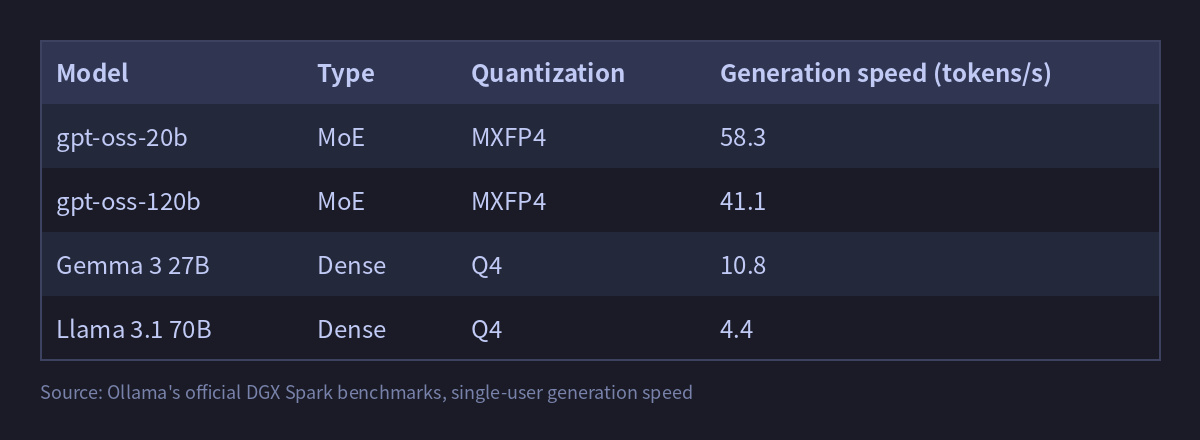
À 4 jetons par seconde, vous regardez la réponse s’écouler au compte-gouttes. L’utilisation interactive est pénible.
Le résultat contre-intuitif : le 120B est presque 10 fois plus rapide que le 70B
La ligne la plus intéressante de ce tableau est celle de gpt-oss-120b. Il compte environ 67 % de paramètres de plus que Llama 70B, et pourtant il génère plus de 9 fois plus vite.
La raison tient à l’architecture. Llama 70B est un modèle dense : chacun de ses 70 milliards de paramètres intervient pour chaque jeton, donc ils sont tous lus en mémoire à chaque fois. gpt-oss-120b est un modèle à mélange d’experts (MoE) : ses 117 milliards de paramètres sont répartis entre de nombreux « experts », et chaque jeton ne fait appel qu’à quelques-uns d’entre eux. Seuls environ 5,1 milliards de paramètres sont actifs par jeton.
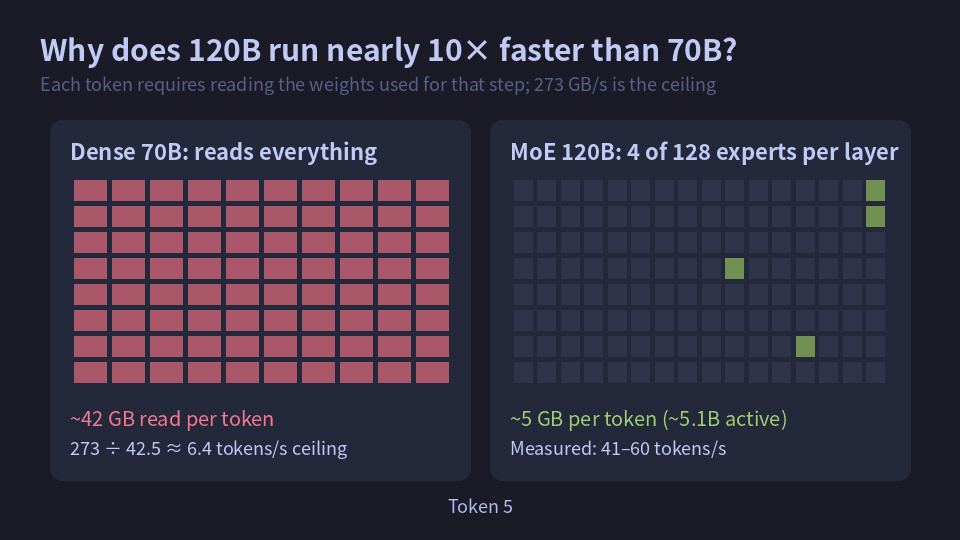
Le modèle dense 70B lit environ 42 Go par jeton. Le MoE 120B n’en lit qu’environ 5 Go : à peu près 2 Go pour les experts sélectionnés, plus environ 3 Go pour les couches d’attention et de sortie, qui sont conservées à une précision supérieure. Cela explique la différence de vitesse de près d’un facteur dix sur une machine limitée par la bande passante.
Cela donne aussi une règle pour choisir ses modèles : le Spark est une machine conçue pour le MoE. Le nombre total de paramètres peut être élevé, car la mémoire est abondante. Les paramètres actifs doivent être peu nombreux, car la bande passante est limitée.
Ce qu’il peut réellement exécuter
Selon cette logique, les modèles open weights courants se répartissent en sept catégories :
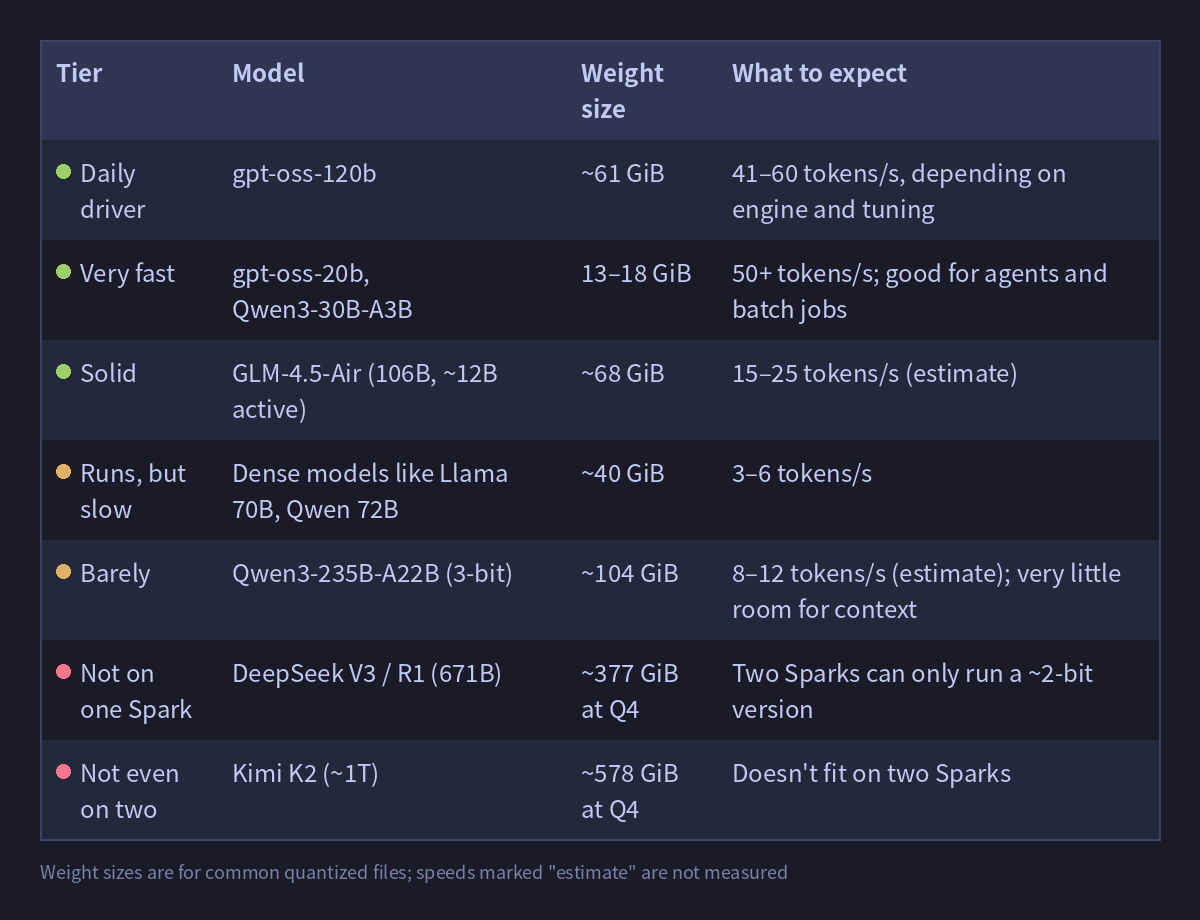
Le moteur d’inférence compte aussi. Des tests de référence publiés sur des forums pour gpt-oss-120b indiquent environ 46 jetons/s avec llama.cpp, environ 52 avec SGLang et jusqu’à 60 jetons/s avec une version optimisée de vLLM. Pour un seul utilisateur, llama.cpp est la solution la plus simple. Pour un usage partagé avec de nombreuses requêtes simultanées, choisissez vLLM.
En relier deux : 256 Go
Le Spark intègre une carte réseau haut débit ConnectX-7. Deux unités peuvent être reliées directement et utiliser le parallélisme tensoriel pour diviser un modèle en deux, chaque unité exécutant une moitié.
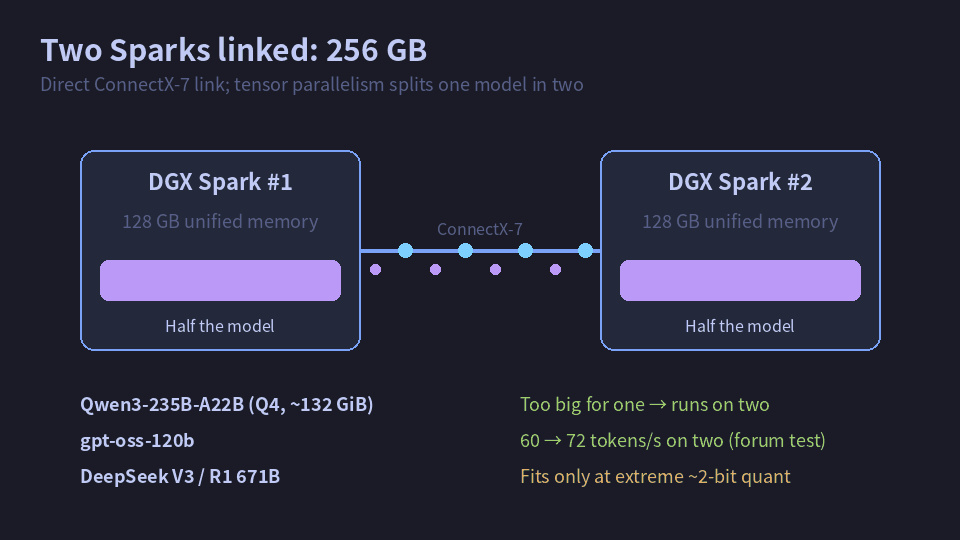
Avec 256 Go répartis sur deux unités, Qwen3-235B fonctionne en entier en 4 bits. Dans les tests de référence publiés sur des forums, gpt-oss-120b passe de 60 jetons/s sur un Spark à 72 sur deux, un gain modeste puisqu’il n’a jamais manqué de mémoire au départ. DeepSeek 671B ne tient toujours sur deux unités qu’avec une quantification extrême d’environ 2 bits ; la perte de qualité est notable, et le jeu n’en vaut guère la chandelle.
Est-ce que le prix en vaut la peine ?
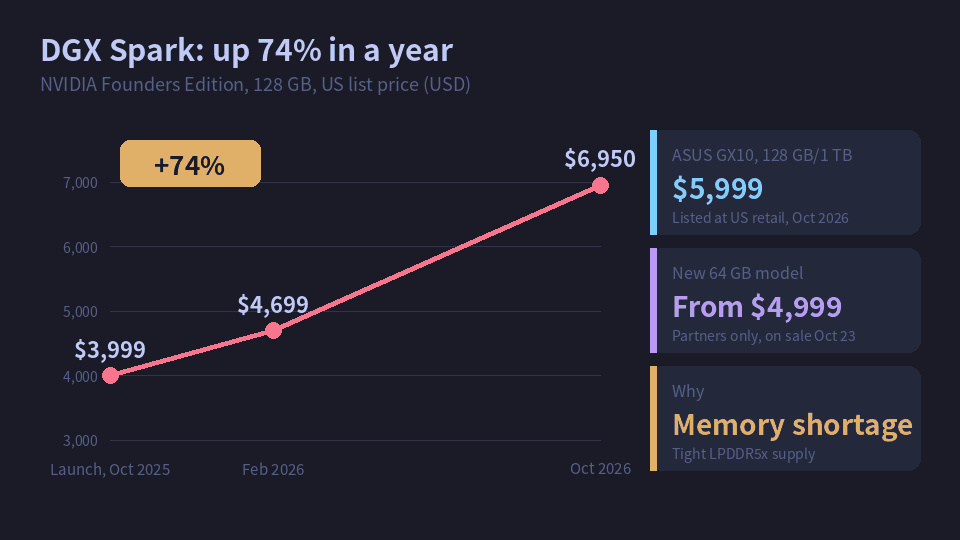
Cette machine n’a fait que devenir plus chère au cours de l’année écoulée. La NVIDIA Founders Edition avec 128 Go a été lancée à 3 999 $, est passée à 4 699 $ en février 2026, puis a bondi à 6 950 $ en octobre, soit une hausse de 74 % en un an. Lors de l’augmentation de février, NVIDIA a invoqué une offre limitée en mémoire ; pour celle d’octobre, les médias ont également pointé du doigt la pénurie mondiale de mémoire.
Comparons maintenant ces prix aux chiffres de bande passante auxquels nous revenons sans cesse :
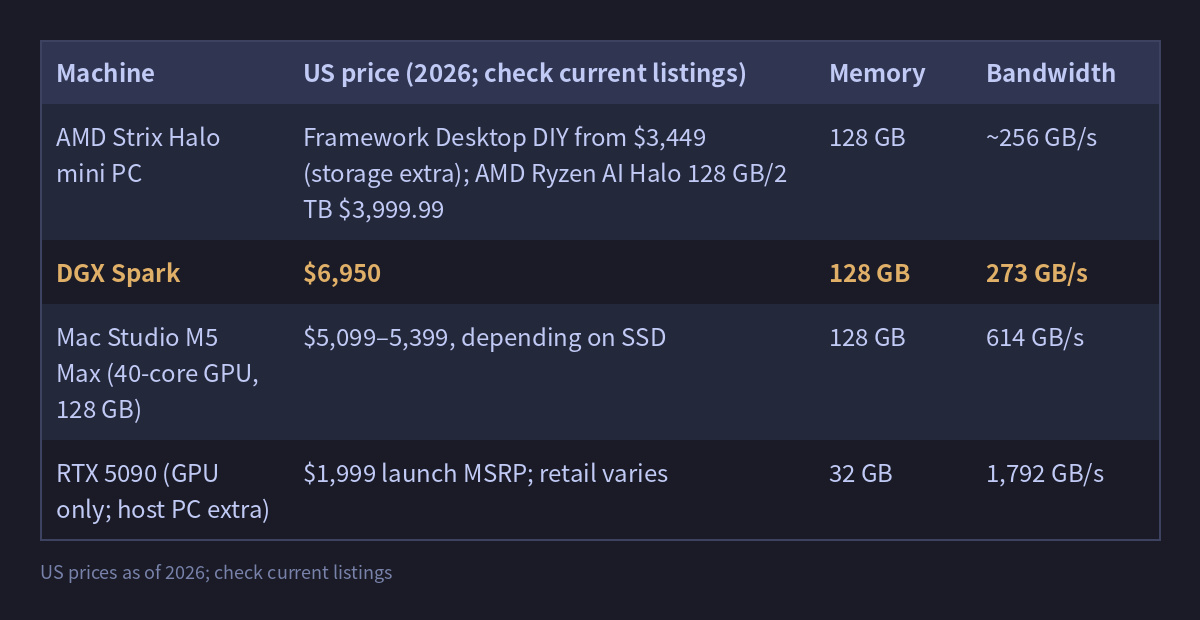
À capacité égale de 128 Go, un mini-PC AMD Strix Halo offre à peu près la même bande passante que le Spark pour environ la moitié du prix. Un Mac Studio M5 Max coûte désormais moins cher que le Spark et offre une bande passante 2,2 fois supérieure : il génère donc ses réponses nettement plus vite. Si tout ce que vous voulez, c’est exécuter de grands modèles en local, le Spark n’offre aucun avantage tarifaire évident.
Ce que cet argent supplémentaire vous achète, c’est la pile logicielle de NVIDIA : CUDA, vLLM, SGLang et TensorRT-LLM fonctionnent dès l’installation, les longues invites sont traitées rapidement, le fine-tuning fonctionne, et tout ce que vous développez ici peut être transféré tel quel sur les serveurs NVIDIA des centres de données. Si vous n’en avez pas besoin, le prix n’en vaut pas la peine.
À qui s’adresse-t-il ?
Voyez cette machine comme une station de travail capable de faire tourner de grands modèles, mais qui ne les fait pas répondre vite :
Pour les conversations quotidiennes et l’aide au codage, gpt-oss-120b est suffisamment rapide et performant ;
Pour les agents et le traitement de documents par lots, utilisez un modèle MoE plus petit ; dans les tests ci-dessus, gpt-oss-20b décode environ 40 % plus vite que gpt-oss-120b ;
C’est pour le fine-tuning de modèles allant jusqu’à 70B (QLoRA) que les 128 Go de mémoire sont vraiment rentabilisés ;
Les modèles denses de 70B ne conviennent qu’aux tâches hors ligne pour lesquelles l’attente n’a pas d’importance ; si vous devez en utiliser un, ajoutez un petit modèle brouillon pour le décodage spéculatif, ce qui accélérera sensiblement les choses.
Si ce que vous voulez surtout, c’est « une personne qui discute rapidement avec un grand modèle », un Mac Studio ou un GPU doté de beaucoup de VRAM conviendra mieux. Si vous voulez simplement faire tourner un modèle de classe 100B au coût le plus bas possible, un mini-PC AMD est une meilleure affaire. Le Spark ne vaut son prix que si votre travail dépend de CUDA, implique du fine-tuning ou nécessite d’utiliser la même pile logicielle que dans un centre de données.
Pour choisir un modèle, posez-vous seulement deux questions : le nombre total de paramètres tient-il dans 122 Gio ? Les paramètres actifs sont-ils suffisamment peu nombreux ? Si la réponse est oui aux deux, le modèle convient bien à cette machine.
Acheter du matériel ou prendre un abonnement ?
Après les calculs sur le matériel, il y a un calcul plus direct à faire.
Pour ma part, je choisis les abonnements : Claude Max 5x à 100 $ par mois, plus ChatGPT Plus (qui inclut Codex) à 20 $ par mois, soit 1 440 $ par an. Un Spark à 6 950 $ financerait les deux pendant près de 5 ans ; Max 5x seul, pendant près de 6 ans.
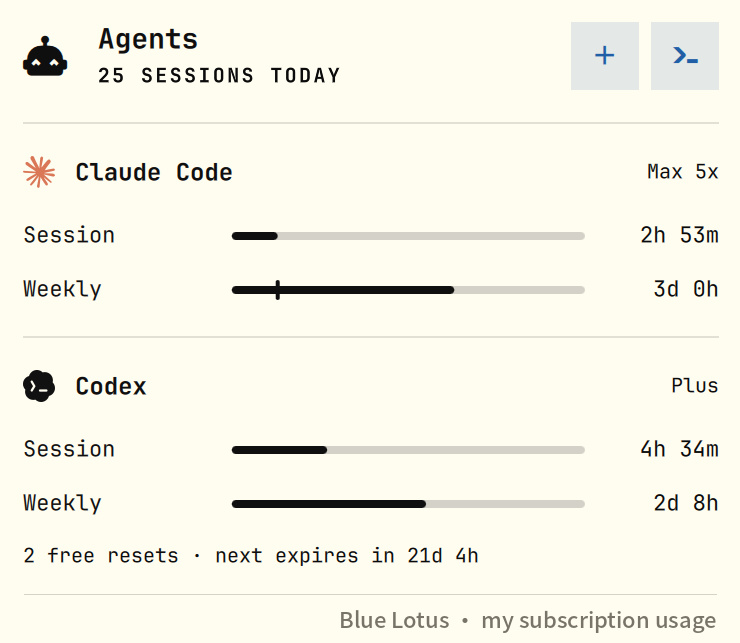
Voici mon utilisation sur une journée : 25 sessions d’agent, environ 60 % de mon quota hebdomadaire de Claude Code utilisé alors qu’il reste 3 jours avant la réinitialisation, et un peu plus de la moitié de mon quota hebdomadaire de Codex. À ce rythme, les deux abonnements couvrent généralement mes besoins, et ils donnent accès à des modèles de pointe. La meilleure option locale, gpt-oss-120b, reste en retrait face à eux pour le codage et les tâches de longue durée.
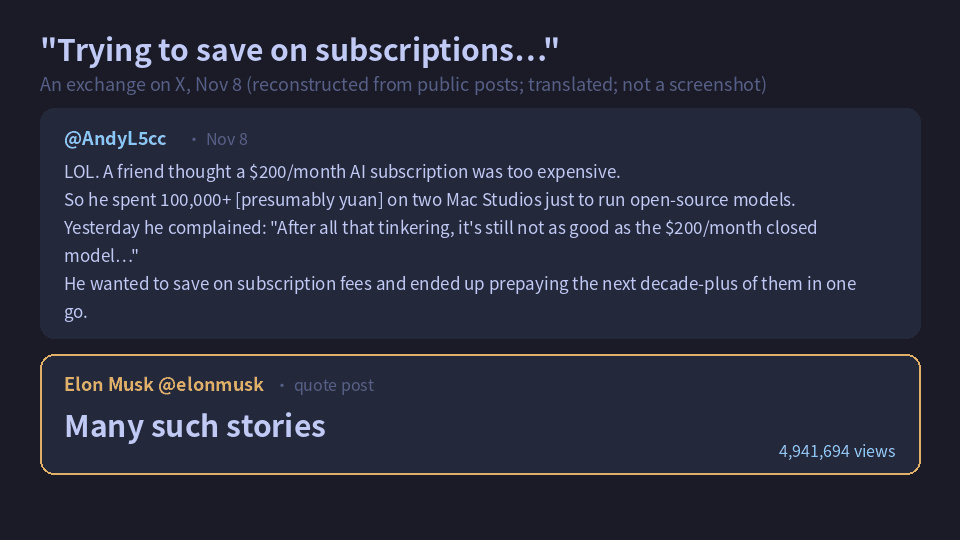
Je ne suis pas le seul à faire ce calcul. Le 8 novembre, une publication en chinois est devenue virale sur X : quelqu’un trouvait trop cher un abonnement à l’IA à 200 $ par mois, alors il a dépensé plus de 100 000 (probablement des yuans) pour deux Mac Studios afin d’exécuter des modèles open source. Après de nombreux réglages, il a découvert que « ce n’est toujours pas aussi bon que le modèle fermé à 200 $ par mois ». Résumé de l’auteur : « Il voulait économiser sur les frais d’abonnement et a fini par payer d’avance ceux de la prochaine décennie, voire plus, en une seule fois. » Elon Musk a cité la publication en ajoutant seulement trois mots : « Beaucoup d’histoires comme ça. » La citation a cumulé près de 5 millions de vues.
Sam Altman, d’OpenAI, a récemment expliqué la logique derrière tout cela dans un podcast : la mémoire des ordinateurs personnels n’est utilisée qu’environ 5 % du temps (selon sa propre estimation), tandis que le cloud, en regroupant les requêtes et en les traitant par lots, peut généralement accroître le taux d’utilisation et répartir les coûts. Il vend des abonnements cloud, donc il a tout intérêt à défendre cet argument, mais le raisonnement tient : dans le cloud, une seule lecture des poids peut servir tout un lot de requêtes à la fois, ce qui répartit le coût ; une machine personnelle sert une personne à la fois et reste inactive une bonne partie de la journée. Avant d’acheter du matériel local, estimez donc à quelle fréquence vous l’utiliserez vraiment : moins vous l’utilisez, moins l’affaire est intéressante.
Les modèles locaux offrent toutefois des avantages qu’un abonnement ne peut pas proposer :
Confidentialité : données clients, code interne, exigences de conformité ; les données ne quittent pas votre machine ;
Aucune restriction de plateforme : le modèle n’est pas soumis aux règles de contenu d’un fournisseur, et c’est vous qui décidez de ce qu’il peut répondre ;
Hors ligne et sans limites : il fonctionne sans connexion, et les tâches par lots ne sont pas décomptées d’un quota ;
Fine-tuning : si vous voulez entraîner votre propre modèle, un abonnement ne le permet pas.
Pour la plupart des gens, un abonnement coûte moins cher et donne accès à des modèles plus performants. Acheter un Spark n’a de sens que si au moins l’un des quatre besoins ci-dessus est incontournable.