
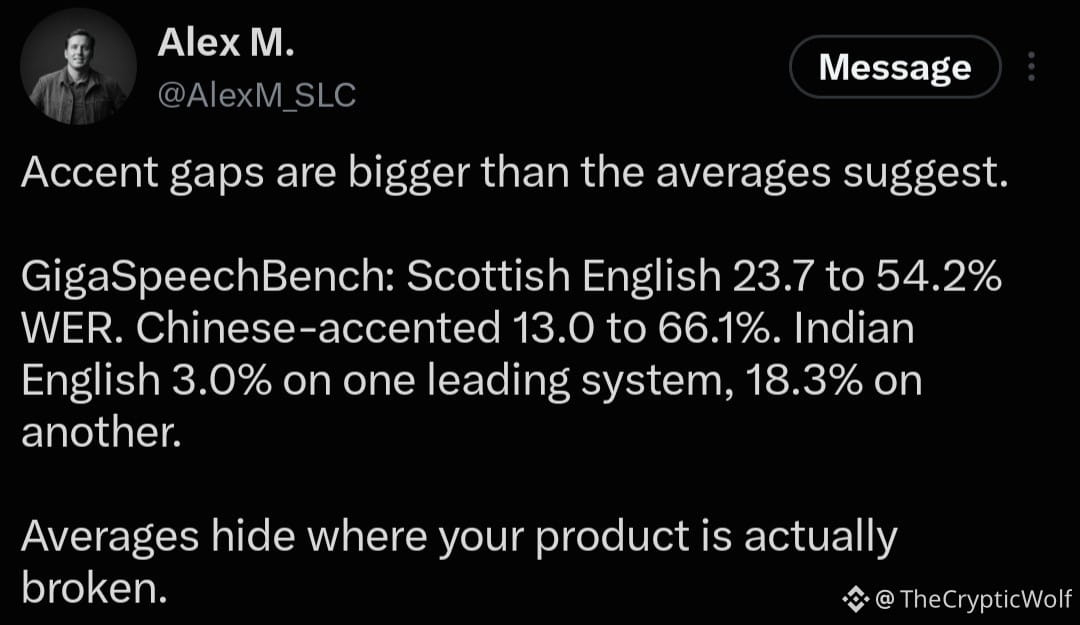
C’est précisément pour cela que ce que construit $SLC est important. Nous parlons beaucoup de la puissance croissante des technologies vocales d’IA, mais un problème ne reçoit pas toute l’attention qu’il mérite : elles ne comprennent pas tout le monde de la même manière. Quand l’anglais écossais affiche un taux d’erreur sur les mots (WER) compris entre 23,7 et 54,2 %, ou que l’anglais avec un accent chinois passe de 13 % à 66,1 %, il ne s’agit pas seulement d’un écart de performance. C’est un problème d’accessibilité. Pensez à ce que cela signifie pour une personne qui essaie d’utiliser l’IA vocale au travail, d’accéder à un service, de communiquer avec un appareil ou simplement de se faire comprendre. L’IA ne devrait pas fonctionner à merveille avec une voix et peiner avec une autre. C’est là que @silencionetwork devient important. Pour créer une meilleure IA vocale, il faut commencer par de meilleures données vocales. La diversité des accents, des dialectes et des langues, ainsi que les voix historiquement sous-représentées dans les jeux de données, doivent faire partie des fondations, et non être prises en compte après coup. Silencio contribue à bâtir un avenir où les technologies vocales refléteront mieux la diversité des personnes qui les utilisent réellement. Car la prochaine génération d’IA vocale ne devrait pas seulement reconnaître davantage de mots. Elle devrait comprendre davantage de personnes. L’avenir de l’IA vocale a besoin de toutes les voix, et c’est pourquoi je suis optimiste quant à ce que construit $SLC.
Rejoignez la communauté mondiale des adeptes de cryptomonnaies sur Binance Square
⚡️ Suviez les dernières informations importantes sur les cryptomonnaies.
💬 Jugé digne de confiance par la plus grande plateforme d’échange de cryptomonnaies au monde.
👍 Découvrez les connaissances que partagent les créateurs vérifiés.
Adresse e-mail/Nº de téléphone