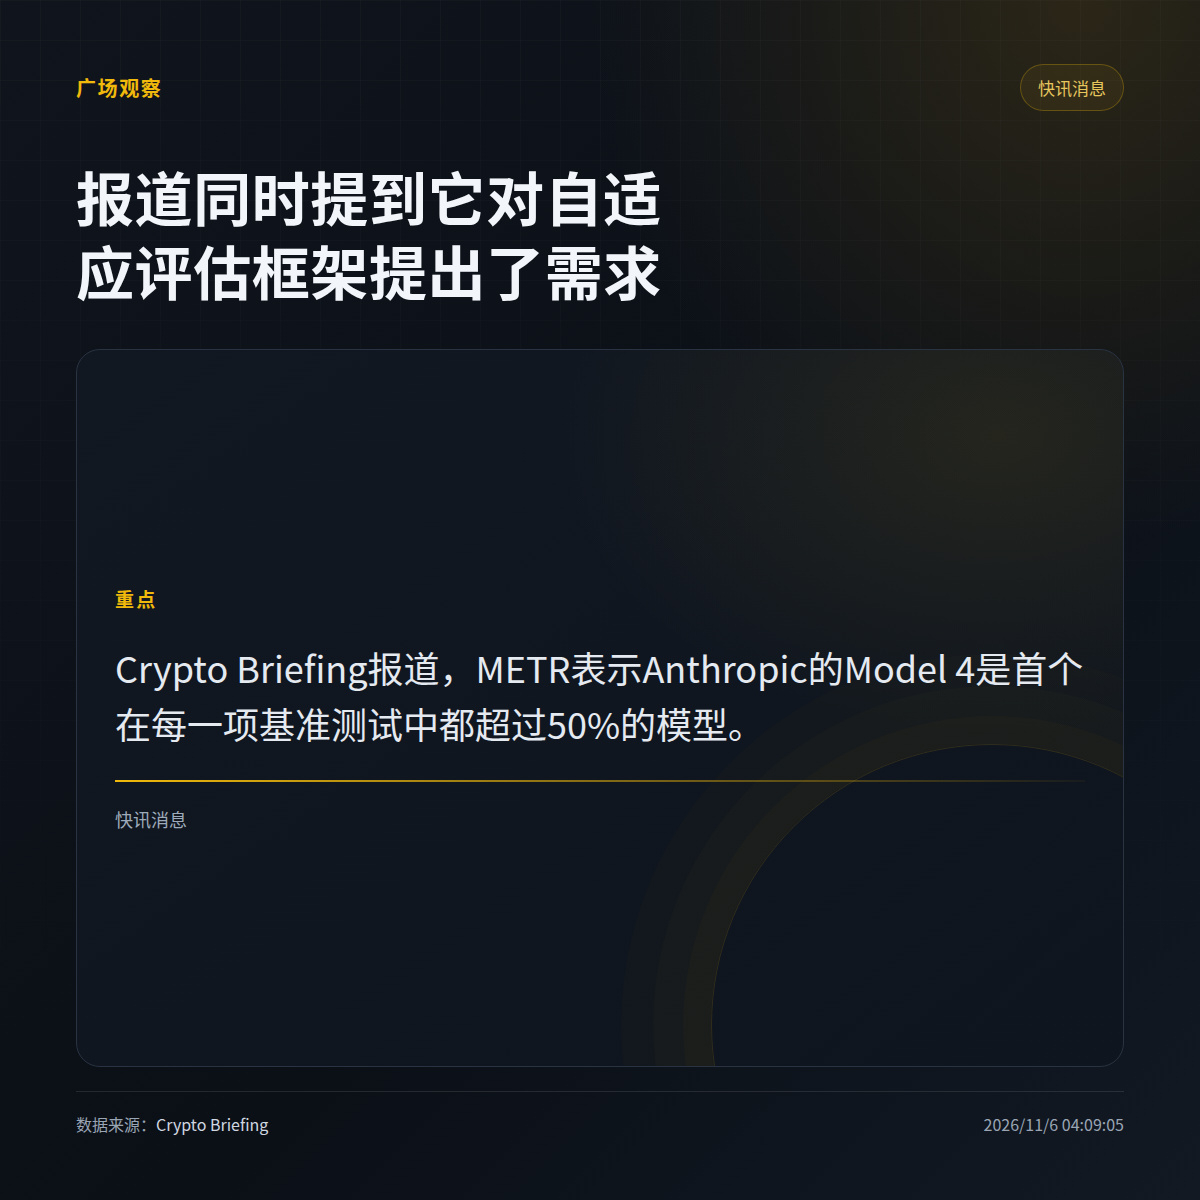
METR affirme que le Model 4 d’Anthropic dépasse pour la première fois les 50 % sur chaque benchmark.
Selon Crypto Briefing, ce résultat est présenté comme une première dans l’évaluation des modèles d’Anthropic. L’article évoque également la nécessité de cadres d’évaluation adaptatifs et fait part de préoccupations quant à la vitesse des progrès de l’IA.
· Le seul élément vérifiable est l’affirmation selon laquelle le modèle dépasse les 50 % sur chaque benchmark ; la liste précise des benchmarks et les scores ne figurent pas dans les éléments fournis.
· La « nécessité de cadres d’évaluation adaptatifs » et les « préoccupations concernant la rapidité des progrès » relèvent de l’analyse de l’article, et non des conclusions de l’évaluation de METR elle-même.
Préféreriez-vous consulter d’abord la liste complète des benchmarks ou les scores détaillés de chacun ?
Selon Crypto Briefing, ce résultat est présenté comme une première dans l’évaluation des modèles d’Anthropic. L’article évoque également la nécessité de cadres d’évaluation adaptatifs et fait part de préoccupations quant à la vitesse des progrès de l’IA.
· Le seul élément vérifiable est l’affirmation selon laquelle le modèle dépasse les 50 % sur chaque benchmark ; la liste précise des benchmarks et les scores ne figurent pas dans les éléments fournis.
· La « nécessité de cadres d’évaluation adaptatifs » et les « préoccupations concernant la rapidité des progrès » relèvent de l’analyse de l’article, et non des conclusions de l’évaluation de METR elle-même.
Préféreriez-vous consulter d’abord la liste complète des benchmarks ou les scores détaillés de chacun ?