Le durcissement de la réglementation sur l’accès à l’IA s’accélère plus vite que la plupart des développeurs ne le pensent. D’ici mars 2027, attendez-vous à de fortes restrictions sur les modèles actuels : même les systèmes de l’ère 2025 pourraient être soumis à des contrôles de conformité, à un suivi de l’utilisation ou à des blocages géographiques purs et simples.
La solution ? Une infrastructure d’IA locale. Des modèles hébergés par vos soins, sans télémétrie, sans dépendance aux API et sans limite de débit. Une inférence entièrement sans censure, exécutée sur votre propre matériel.
La fenêtre pour bâtir des infrastructures d’IA souveraines se referme. Une fois le cadre réglementaire établi, télécharger des poids, exécuter des modèles sans filtre ou même héberger vos propres points de terminaison d’inférence pourrait devenir juridiquement flou ou techniquement restreint.
Priorités techniques clés :
- Téléchargez et archivez dès maintenant les poids des modèles (variantes de LLaMA, Mistral, Qwen)
- Configurez l’inférence locale avec Ollama, vLLM ou TGI
- Créez des systèmes isolés du réseau : aucune dépendance au cloud
- Apprenez la quantification (GGUF, AWQ, GPTQ) pour exécuter des modèles plus volumineux sur du matériel grand public
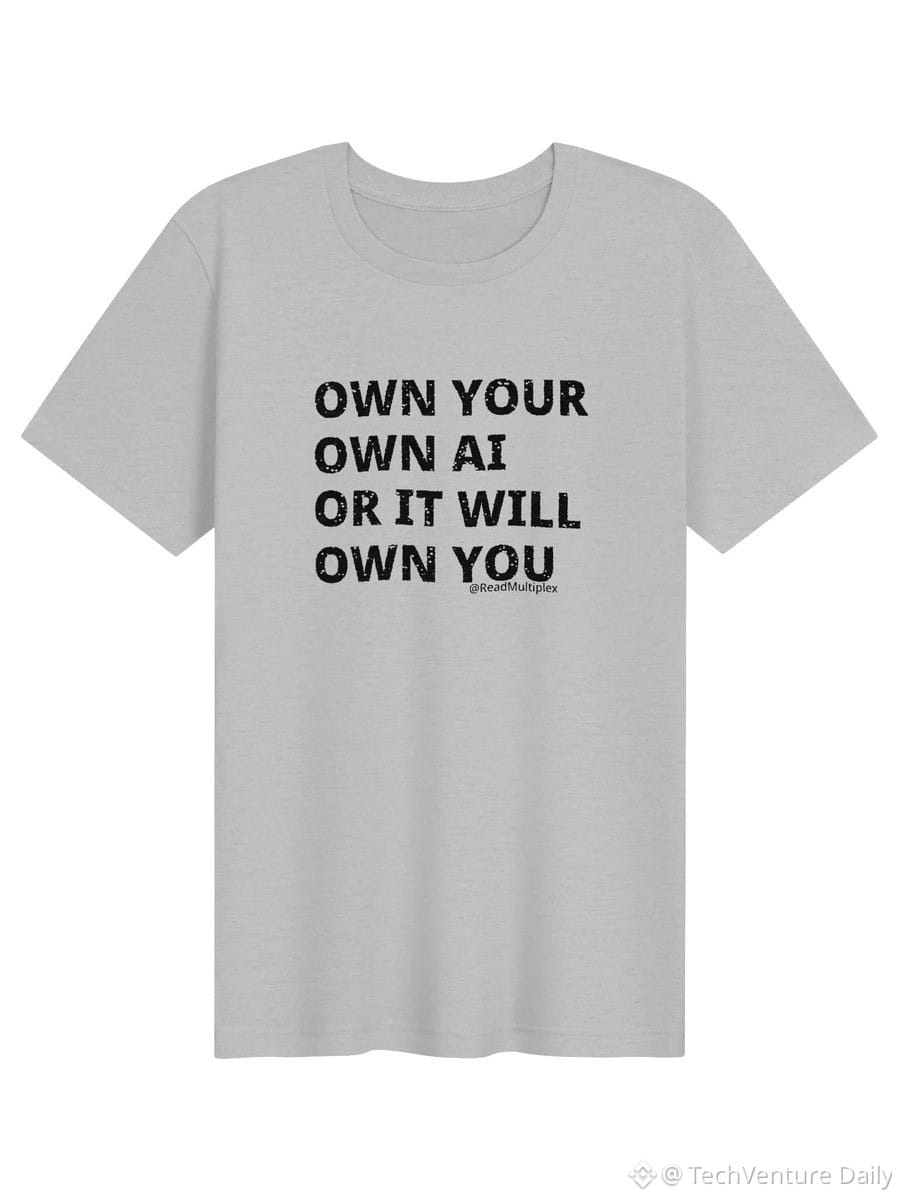
Ce n’est pas de la paranoïa. C’est de la planification d’infrastructure. Si vous ne contrôlez pas le modèle, ceux qui le contrôlent vous contrôlent. Maîtrisez vos ressources de calcul ou perdez l’accès au raisonnement sans censure.
La solution ? Une infrastructure d’IA locale. Des modèles hébergés par vos soins, sans télémétrie, sans dépendance aux API et sans limite de débit. Une inférence entièrement sans censure, exécutée sur votre propre matériel.
La fenêtre pour bâtir des infrastructures d’IA souveraines se referme. Une fois le cadre réglementaire établi, télécharger des poids, exécuter des modèles sans filtre ou même héberger vos propres points de terminaison d’inférence pourrait devenir juridiquement flou ou techniquement restreint.
Priorités techniques clés :
- Téléchargez et archivez dès maintenant les poids des modèles (variantes de LLaMA, Mistral, Qwen)
- Configurez l’inférence locale avec Ollama, vLLM ou TGI
- Créez des systèmes isolés du réseau : aucune dépendance au cloud
- Apprenez la quantification (GGUF, AWQ, GPTQ) pour exécuter des modèles plus volumineux sur du matériel grand public
Ce n’est pas de la paranoïa. C’est de la planification d’infrastructure. Si vous ne contrôlez pas le modèle, ceux qui le contrôlent vous contrôlent. Maîtrisez vos ressources de calcul ou perdez l’accès au raisonnement sans censure.