

Aujourd’hui l’IA, et demain l’IA
Si l’on découpe la chaîne de valeur de l’industrie IA en amont (équipements), milieu (éditeurs de cloud) et sociétés de grands modèles, puis en aval (applications). À l’heure actuelle, la quasi-totalité de la marge est concentrée dans l’amont : rien que $英伟达 (NVDA.US)$, plus les quatre grands fabricants de mémoire, captent environ 70 % des profits de l’industrie.
Ce type de répartition des profits présente des caractéristiques typiques des débuts d’une nouvelle révolution technologique. Mais si l’on y réfléchit : les points d’entrée de la tarification de l’industrie IA à l’avenir seront-ils toujours, au moment de la répartition des profits, soit des fournisseurs cloud, soit des applications en aval ?
Par exemple, dans une industrie Internet arrivée à maturité, la répartition approximative de la marge bénéficiaire économique est la suivante :
Équipements / technologies en amont : environ 20 %–30 %
Réseaux / cloud / opérateurs en aval : environ 10 %–20 %
Plateformes et applications en aval : environ 50 %–70 %
Il est évident que plus on se rapproche de l’entrée utilisateur, plus la part des bénéfices est élevée.
Les dépenses d’investissement importantes des fournisseurs de cloud ces dernières années convertissent, en substance, une partie des profits futurs des fournisseurs de cloud et les pré-positionnent en tant que profits des sociétés d’équipements hardware en amont. Et, à l’avenir, les revenus de l’industrie IA se dirigeront principalement vers les applications en aval et les fournisseurs de cloud.
Avec le ralentissement de la croissance des dépenses d’investissement, avec la croissance même des revenus liés à l’IA, la répartition des profits sur l’ensemble de la chaîne de valeur ira de plus en plus vers l’industrie Internet arrivée à maturité : elle se concentre progressivement sur les fournisseurs cloud du milieu et les applications en aval.
Aujourd’hui, la capitalisation totale de la chaîne de valeur IA sur le marché américain avoisine 25 000 milliards de dollars. Dans cet ensemble : l’amont (y compris les puces de calcul, les équipements de semi-conducteurs, la mémoire et la communication) représente 47 %, le milieu (les fournisseurs de cloud) 50 %, et l’aval (les applications) seulement 3 % ; l’espace de croissance est immense.
Si vous investissez dans l’IA d’aujourd’hui, bien sûr il faut continuer d’investir dans la capacité de calcul. Mais si vous investissez dans le futur de l’IA, alors il est sans aucun doute plus judicieux de se concentrer sur les applications en aval. Au cours des trois dernières années, l’amont a vu surgir d’innombrables actions multipliées par plusieurs dizaines ; mais une fois la période de pic des dépenses d’investissement terminée, la répartition des profits se fait davantage au milieu et en aval, ce qui augmente la probabilité d’obtenir des actions multipliées par dix.
Avant, j’avais l’impression que l’incertitude des applications IA était trop forte. En réalité, c’est surtout que le volume des revenus IA natifs en Chine restait trop petit ; mais aux États-Unis, c’est différent : les applications IA ont déjà plusieurs trajectoires clairement identifiées, et on voit apparaître des sociétés ayant une forte valeur d’investissement. Dans cet article, je prends encore comme exemple des sociétés cotées américaines d’applications IA pour passer en revue quelques directions clés.
La capacité de calcul reflète le niveau de conjoncture ; les applications reflètent le modèle économique.
Les applications IA ne constituent pas un segment homogène. En 2026, on observe une différenciation extrêmement marquée en interne : les logiciels d’infrastructure tirés par les charges de travail IA (y compris les plateformes de données, l’observabilité, la sécurité) surperforment fortement. « Miser sur les logiciels d’infrastructure et limiter l’exposition au SaaS » est devenu la stratégie consensuelle actuelle pour les investissements en logiciels aux États-Unis.
Mais toutes les sociétés SaaS ne sont pas en mesure de se faire « tuer » par la valorisation. D’après le rapport semestriel, de nombreuses valeurs logicielles voient leurs revenus liés à l’IA croître rapidement. En même temps, beaucoup de sociétés d’infrastructures logicielles ont des valorisations très élevées.
La conjoncture de la capacité de calcul se lit dans l’optimisme du secteur ; le modèle économique se lit dans les applications. Trois variables clés permettent de juger la qualité des sous-segments :
1. Modèle de facturation : facturation à l’usage/à la consommation, naturellement corrélée aux charges de travail IA ; elle permet de compenser le risque lié à la baisse des sièges, contrairement aux modèles uniquement basés sur les sièges.
2. Position dans la chaîne d’exécution IA de l’entreprise : contrôler les données critiques, les autorisations et l’entrée des workflows ; ces plateformes ont vocation à être revalorisées comme une infrastructure d’IA d’entreprise, plutôt que comme des logiciels d’application.
3. Les revenus IA sont-ils une « incrémentalité » : le marché paie uniquement pour des indicateurs d’ARR/ACV IA traçables et pour des indicateurs de charges de travail, et non pour une stratégie IA.
À partir de ces trois critères, les applications IA peuvent être classées en sept segments répartis sur trois niveaux.
Première catégorie : plateforme de données
Supposons qu’il y ait aujourd’hui une grande entreprise de commerce électronique qui décide d’« investir AII dans l’IA », et fasse en sorte de recruter le moins possible à l’avenir : que les Agents IA gèrent eux-mêmes cette entreprise.
Ce n’est pas résoluble simplement en ajoutant quelques points d’entrée avec des Agents. La première étape, que toutes les entreprises doivent faire, consiste à construire une plateforme de données IA. Pour que l’IA prenne des décisions et exécute des actions, elle doit d’abord savoir ce qui s’est passé dans l’entreprise, ce qui se passe actuellement.
Dans le passé, les exécutants du travail de l’entreprise étaient des employés. Donc les données étaient dispersées à différents endroits : les données utilisateurs dans le CRM, les commandes dans les bases e-commerce, les données inventaire et finance dans l’ERP, les traces du service client dans le système de support, les informations produits dans le PIM, les données publicitaires dans Meta et Google, les données employés dans le système RH, les comptes rendus de réunion dans les ordinateurs et les e-mails de chaque personne, et encore plus de données dans le cerveau des employés et dans leurs historiques de discussion (si c’est une entreprise chinoise)…
Au moment de l’exécution, ce sont ensuite les employés qui recherchent et consolident ces données via différents canaux. Par exemple, si le patron demande : « Pourquoi le profit de la région de Shanghai a-t-il baissé au cours des trois derniers mois ? », vous pouvez vous connecter séparément à différents systèmes pour vérifier. Si vous ne savez pas, vous demandez à un collègue, puis seulement vous pourrez analyser.
De la même manière, un Agent qui fonctionne vraiment doit connaître toutes les données ci-dessus en même temps. Sans données, l’IA n’est qu’un sous-traitant très intelligent, mais qui ignore ce qui se passe dans l’entreprise.
Donc, la première chose à faire dans une transformation IA, c’est de transformer toutes les informations de l’entreprise en données que l’IA peut comprendre, interroger et exploiter—le plus possible, donc la migration des données.
À l’avenir, chaque réunion d’un projet, chaque échange entre collègues, voire chaque phrase de discussion d’un employé, sera enregistrée et numérisée en continu, pour devenir des données d’analyse et des corpus destinés à l’IA. C’est ainsi qu’on s’assure que les décisions de l’IA reposent sur des informations d’exploitation en temps réel.
Aux États-Unis, les meilleures réussites sont $Snowflake (SNOW.US)$ et $MongoDB (MDB.US)$ ; bien sûr, il y a aussi une autre société moins typique mais plus connue : $Palantir (PLTR.US)$.
$Snowflake (SNOW.US)$ est passé d’un simple fournisseur de services de data warehouse à une plateforme cloud de données IA complète. Il a lancé une série de produits d’IA natifs comme Cortex Code et Snowflake Intelligence, simplifiant la migration des données des clients, catalysant la consommation du cœur de métier des données, et formant une puissante boucle de croissance.
Les sociétés de cette catégorie facturent toutes à l’usage/à la consommation. Les charges de travail IA sont naturellement corrélées. D’après le rapport semestriel, la croissance des revenus produit s’est accélérée sur trois trimestres consécutifs jusqu’à 37 % au T2. L’entreprise a relevé ses perspectives de revenus produit pour l’année entière à 6,07 milliards de dollars (+36 %), ce qui valide que la « boucle de consommation du cœur de plateforme piloté par l’IA » entre dans une phase de concrétisation.
Mais la valorisation de ce type de société est elle aussi extrêmement élevée : SNOW a près de 20x de PS et une capitalisation d’environ 120 milliards de dollars. Elle intègre des attentes plus élevées à l’avenir. Le scepticisme du marché tient à la coopération concurrentielle avec des géants du cloud comme AWS, Microsoft et Google.
Deuxième catégorie : observabilité
Quand l’entreprise confie une part croissante de son activité à l’IA, elle découvre alors un problème grave : on ne sait pas exactement ce que l’IA fait. Les tokens consommés valent-ils vraiment la peine ? Quelles activités peut-on optimiser ?
Auparavant, les entreprises avaient un système complet d’enregistrement, d’évaluation et de notation du travail des employés. Le plus typique est la gestion des KPI. Même s’il y a beaucoup d’évaluations négatives, cela garantit qu’une entreprise de plusieurs dizaines de milliers de personnes fonctionne automatiquement selon les procédures. Mais le travail de l’IA est une « boîte noire » : l’IA peut aussi se la couler douce, faire du « travail inutile ». Pourtant, son workflow peut être complètement différent de celui des humains. Les KPI traditionnels ne fonctionneront plus ; il faut que les employés voient en continu ce que l’IA fait réellement.
C’est exactement le problème que résolvent les applications d’observabilité. C’est comme les RH de l’IA : les humains peuvent y voir quels outils un Agent IA appelle, quel API il appelle, combien de tokens il consomme, pourquoi il a pris cette décision, à quelle étape ça échoue, quel Agent est le plus performant, quel Agent a causé une perte, etc.
Un représentant de cette activité est $Datadog (DDOG.US)$. Cette société peut réaliser des tâches d’APM traditionnelles, comme la surveillance en temps réel des performances des infrastructures des clients (cloud, serveurs hybrides ou on-premise, serveurs, conteneurs, réseau, etc.). Elle peut aussi fournir un tracing distribué au niveau du code pour aider les clients à comprendre en profondeur les goulots d’étranglement de performance des applications et des microservices. De plus, elle peut collecter, traiter et analyser une énorme quantité de logs provenant des systèmes et applications pour le diagnostic d’incidents et l’analyse de performance.
Le modèle de tarification de ce type d’applications est également basé sur la consommation. Le revenu de DDOG au T2 a augmenté de +36 % ; sur quatre trimestres consécutifs, la croissance a accéléré. L’entreprise a aussi fortement relevé ses prévisions annuelles. Néanmoins, la valorisation de ce segment est elle aussi extrêmement élevée, ce qui rend le cours de bourse très sensible aux récits négatifs du secteur des logiciels.
Troisième catégorie : cybersécurité
La cybersécurité est un segment qui existait déjà à l’époque des logiciels traditionnels, mais à l’ère de l’IA, son importance explose. Car les attaques par IA ne visent pas seulement votre système : l’IA peut elle-même servir à induire des hackers.
Fondamentalement, l’IA remplace les employés. Elle dispose d’autorisations plus étendues que la plupart des employés : elle peut accéder à des bases de données, modifier des données, envoyer des e-mails, voire effectuer des actions à haut risque comme des transferts de fonds. Elle peut même écrire du code directement, déployer des programmes—comme si elle pénétrait directement le cerveau de vos employés, en « retournant » les employés.
Les Agents possèdent à la fois des capacités de raisonnement, d’accès aux données et d’action. Ainsi, la sécurité passera par le contrôle des autorisations, de l’identité, de l’auditabilité et des appels d’outils : ce sont de nouveaux sujets de sécurité.
Les entreprises de ce type ($ réseau sécurité concept (LIST2570.US)$) sont nombreuses, donc je ne vais pas donner d’exemples.
La sécurité est le secteur le plus élevé parmi les trois volets : c’est principalement parce que la demande est très déterministe. Et compte tenu du décalage entre les dépenses en IA et les dépenses en « IA pour la sécurité », les attentes de croissance des revenus sont fortement positives.
Ces trois catégories—services de données, prédictibilité et cybersécurité—peuvent être regroupées sous l’expression d’« infrastructures numériques » pour les applications IA. Elles constituent le trio indispensable pour toutes les entreprises qui mettent en œuvre une stratégie IA. Les dépenses ont à la fois un caractère initial (en amont) et un caractère continu ; ce sont donc les applications qui explosent en premier.
Bâties sur ces trois types d’infrastructures numériques, les applications relèvent de la « couche d’exécution », c’est-à-dire les interfaces de travail de l’entreprise. Je les répartis en deux catégories : d’une part les plateformes de Workflow / Agent, et d’autre part la programmation IA.
Quatrième catégorie : plateforme Workflow/Agent
Avec les données et les autorisations, comment les Agents de cette entreprise e-commerce fonctionnent-ils vraiment ?
Aujourd’hui, les solutions se divisent en deux catégories. La première consiste, sur la base des workflows existants, à utiliser des Agents IA, combinés à divers logiciels sectoriels existants, pour effectuer le travail. On parle de « plateforme Workflow / Agent ».
Par exemple, pour cette société e-commerce qui gère les retours clients : dans les processus traditionnels, le service client valide, consulte la commande, identifie la cause, vérifie le stock, traite le remboursement, s’occupe de la logistique, notifie l’entrepôt, etc. À chaque étape, l’humain opère le logiciel.
Et dans le modèle « Workflow / plateforme Agent », le workflow reste le même ; seule la Customer Agent spécialisée le traite automatiquement.
Dans ce modèle, au-delà du grand modèle lui-même, le plus important est la manière d’intégrer de façon raisonnable des appels d’outils, des permissions et des approbations humaines dans les workflows existants. Le défi se situe dans la collaboration entre les employés et les agents.
Ainsi, ce type d’entreprise d’applications est généralement issu d’une transformation de l’éditeur de logiciels existant. Par exemple $赛富时 (CRM.US)$, $ServiceNow (NOW.US)$, $微软 (MSFT.US)$, etc. Le modèle de facturation adopte aussi une double approche : « facturation par siège + par jeton (Token) ».
Mais ces éditeurs d’applications non natives IA sont donc aussi davantage remis en cause. Deux points principalement : premièrement, leur croissance vient-elle réellement de l’IA ou non ? Deuxièmement, le modèle de tarification : les revenus additionnels liés à un trafic nouveau facturé pourront-ils compenser la baisse des revenus traditionnels de sièges ?
Des sociétés qui se transforment de manière plus agressive : par exemple $ServiceNow (NOW.US)$. Celle-ci positionne même aujourd’hui sa plateforme comme une infrastructure d’IA d’entreprise reliant les données, les workflows et les Agents IA. Sa plateforme peut connecter des données externes comme $SAP SE (SAP.US)$, $赛富时 (CRM.US)$, ainsi que $Snowflake (SNOW.US)$, Databricks, etc.
Si « Workflow / plateforme Agent » est le modèle permettant d’entraîner des logiciels traditionnels avec l’IA, alors « programmation IA » consiste, elle, à écrire un programme pour réaliser une tâche.
Cinquième catégorie : programmation IA
En réalité, c’est le tout premier scénario B que les grands modèles ont réussi à faire tourner. Cela a déclenché une flambée de l’ARR sur la première moitié de l’année.
Dans l’idée, un Agent IA doit appeler des logiciels existants. Mais dans la pratique, une grande partie des logiciels n’ont pas d’interface. Or, c’est justement ce que les grands modèles savent faire le mieux : écrire des programmes. Face à ce type de problème, il vaut mieux écrire soi-même un programme pour le résoudre. C’est l’évolution des grands modèles : de l’autocomplétion de code à la programmation conversationnelle, puis aux agents de programmation.
Cette catégorie d’applications inclut à la fois GitHub Copilot et Cursor, ainsi que Claude Code, Codex, etc., lancés par des laboratoires de grands modèles.
Je préfère distinguer la programmation IA des fonctionnalités des logiciels traditionnels et des grands modèles. Si l’on veut vraiment transformer une entreprise avec l’IA, il faut sortir entièrement des workflows existants : créer soi-même des « outils de production », et rompre la frontière entre les travailleurs et les outils de production. C’est seulement ainsi qu’on peut réellement améliorer l’efficacité du travail et engendrer une entreprise comme Anthropic, valorisée à plus d’un billion.
Ce type de logiciel a totalement basculé d’une facturation par siège vers une tarification par tokens. Il s’attaque directement à la couche applicative et crée une concurrence frontale avec « la plateforme Workflow / Agent ». Quel sera le mode de travail IA dominant dans le futur ? Il est très possible que ce segment donne naissance à des actions multipliées par dix.
Sixième catégorie : industries verticales et IA de la publicité
Les cinq premières catégories d’applications IA sont des infrastructures et des outils de production dans des environnements de travail génériques. La sixième catégorie, elle, cible des scénarios commerciaux spécifiques : les grands modèles généralistes ne répondent pas aux exigences de conformité et de précision de ces industries. D’où la constitution de « fossés » plus profonds pour les logiciels verticaux.
Ces « applications IA » se situent en réalité au-dessus des cinq premières couches. Aujourd’hui, la forme la plus mature est l’IA de publicité de $Meta Platforms (META.US)$ / $谷歌-A (GOOGL.US)$ / $Applovin (APP.US)$.
La publicité est le tout premier cas d’usage commercialisé pour l’IA. En augmentant la durée de consultation, le taux de conversion ciblé et le CTR créatif, l’IA pousse la hausse de l’eCPM/ROAS.
Les revenus publicitaires de Meta FY26T1+ (T1 2026) ont augmenté de 33 %. Meta affirme que l’exposition a progressé de +19 % et le prix unitaire de +12 %, et attribue cela à l’IA. Mais encore plus convaincant : Google. Les revenus de recherche FY26T1+ ont augmenté de +19 %, avec un niveau record du volume de requêtes, ce qui contredit la perception selon laquelle la recherche assistée par IA affaiblirait la solidité des publicités.
Investir dans ce type de sociétés est surtout difficile pour une raison : distinguer la réalité de la manière dont l’IA entraîne l’activité. Beaucoup d’entreprises d’applications IA dominées par les revenus publicitaires ont une faible part de revenus réellement générés par l’IA ; en revanche, elles courent un risque d’être renversées par l’IA. À l’opposé, des applications publicitaires natives de l’IA comme AppLovin tirent presque chaque dollar de revenus de la publicité pilotée par l’IA. Même si la valorisation est élevée, le potentiel d’augmentation réelle reste peut-être sous-estimé.
Outre la publicité, les avancées des applications IA progressent assez vite dans des secteurs verticaux comme la médecine, la fiscalité/finance, l’éducation et le design. Ces secteurs quantifient souvent facilement le ROI et les utilisateurs sont plus enclins à payer pour l’IA ; toutefois, pour investir, il vaut mieux utiliser une approche fondée sur l’analyse par secteur vertical concerné.
Renversés : SaaS et services IT
Les sociétés e-commerce « All in AI » dépensaient auparavant plusieurs millions par an pour acheter des logiciels lourds, car chaque employé devait disposer de sièges pour des logiciels utilisés fréquemment. Mais avec l’arrivée de l’IA : après avoir affecté à chaque employé une pile d’Agents, on s’est rendu compte qu’on n’avait finalement pas besoin de autant de logiciels.
C’est le « modèle qui avale les logiciels ». Ce n’est pas qu’une narration : c’est une réalité en train de se produire dans l’industrie logicielle. Les grands modèles peuvent reproduire plus vite et à moindre coût les fonctionnalités SaaS, et réduire le nombre de sièges en remplaçant des employés. Gartner estime qu’en 2030, au moins 40 % des dépenses SaaS des entreprises passeront à une facturation à l’usage / Agent / résultat, et que les revenus basés sur les sièges tomberont à moins d’un cinquième. Cette revalorisation prospective comprime d’abord la valorisation, tant que les bénéfices des sociétés logicielles ne se détériorent pas. Intuit, Adobe et Workday sont les trois actions avec les pires performances du Nasdaq-100 au premier semestre 2026 : ce sont toutes des sociétés de logiciels.
Bien sûr, en 2S 2026, la réalité n’est plus « SaaS va mourir » de manière simple ; c’est plutôt la distinction entre ceux qui font la transformation IA et ceux qui sont en retard :
Des sociétés comme $赛富时 (CRM.US)$ transforment leurs Agents IA en un mode de facturation basé sur la consommation/la quantité utilisée : temporairement, c’est donc « sûr », et je les range dans la quatrième catégorie précédente « Workflow / Agent platform ». En revanche, des sociétés comme Intuit, Adobe et Workday : à court terme, leurs initiatives IA ont du mal à accélérer la croissance ; elles figurent donc, pour l’instant, sur la liste des candidats « de ceux qui seront renversés ».
Plus dangereux que SaaS, c’est le secteur des services IT : c’est un domaine où une disruption est en train de se produire.
Avant, cette entreprise e-commerce dépensait chaque année plusieurs millions pour des sociétés de services IT comme Accenture, IBM, Infosys, afin d’acheter des services tels que la mise en œuvre des systèmes, le développement de logiciels, la migration de données, la maintenance ERP et le conseil IT.
Il est évident que même s’il existe des réserves quant au remplacement des employés par l’IA, remplacer l’externalisation IT ne pose aucun obstacle.
Le chiffre d’affaires d’Accenture (T3 FY2026) a été inférieur aux attentes, et l’entreprise a revu ses prévisions de croissance annuelle à la baisse ; le cours de l’action a chuté d’environ 18 % en une seule journée. La cause en profondeur : les entreprises, pour acheter en urgence des matériels de calcul liés à l’IA, ont fortement réduit les budgets de mise à niveau des logiciels traditionnels et de services système. IBM fait face à un problème similaire.
Les résultats de recherche CIO de Morgan Stanley (2T 2026) indiquent que la croissance attendue du budget des services informatiques en 2026 n’est que de +1,8 %, contre +2,1 % en 2025 ; même si le budget IT global s’améliore, l’IA absorbe encore les budgets discrétionnaires.
Si le problème des sociétés SaaS est que le logiciel lui-même peut être redéfini par les Agents, alors le problème des services IT, c’est que le rôle de l’humain peut être remplacé par les Agents. Cette dernière situation est évidemment plus problématique.
Bien sûr, ces entreprises de services IT ont aussi de nouveaux business. Les clients pourraient rencontrer des difficultés sur leur ROI IA, comme c’est le cas pour la migration vers le cloud, ce qui génère de nouveaux besoins en services IA. La question est de savoir s’ils peuvent remplacer la contraction des activités existantes.
Résumé
On peut dire que l’industrie des logiciels traditionnels est le premier secteur à avoir été frappé de plein fouet par l’IA, et aussi le premier à prospérer avec des applications nées avec l’IA. Au début, le marché divisait les sociétés logicielles en IA et non-IA. Aujourd’hui, la classification est : gagnants, perdants et groupe indéterminé. La majorité est dans la catégorie « indéterminée ».
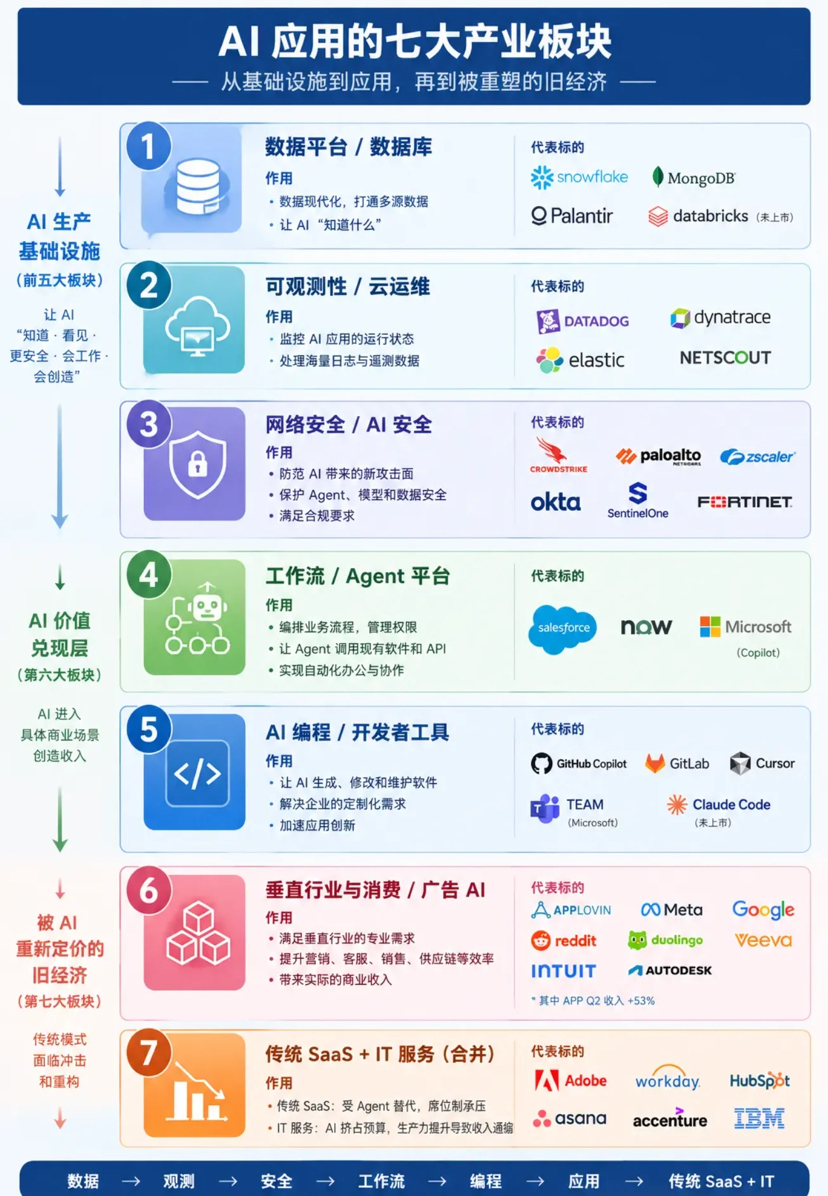
Sur les sept catégories d’applications ci-dessus, les trois premières appartiennent aux « gagnants ». Il s’agit des services de données, de la prédictibilité et de la cybersécurité. Leurs caractéristiques sont une demande structurellement nécessaire : plus l’IA se généralise, plus les systèmes deviennent complexes, et plus les besoins augmentent.
Quatrième et cinquième catégories : plateformes Workflow/Agent et programmation IA. Pour l’instant, elles sont encore « indéterminées » ; mais à mesure que l’IA se généralise, leur rôle devient de plus en plus grand. Elles pourraient même devenir un nouveau système d’exploitation d’entreprise, changeant complètement le modèle économique de l’industrie logicielle.
Sixième catégorie : applications verticales. La différenciation est très forte : il faut examiner cas par cas pour distinguer qui mène réellement des activités pilotées par l’IA et qui n’est qu’un emballage marketing pseudo-IA.
Enfin, le dernier groupe de « ceux qui sont bousculés » : aujourd’hui, ce sont des « perdants » potentiels. Plus l’IA se généralise, plus les anciens modèles commerciaux deviennent dangereux, même s’il ne faut pas croire qu’il n’y a aucune chance.
Les applications logicielles pilotées par l’IA ne constituent plus un simple secteur. En particulier, des applications natives comme la programmation sont une remise en cause complète des méthodes de production existantes des entreprises. À l’avenir, le cadre de valorisation des logiciels ne doit pas se limiter aux taux de croissance des revenus et aux marges bénéficiaires : il faut aussi prendre en compte le volume d’appels à l’IA, le volume d’exécution des tâches, le taux de pénétration des workflows automatisés, le degré de dépendance aux Agents et l’avancement de la migration vers une architecture de tarification.
