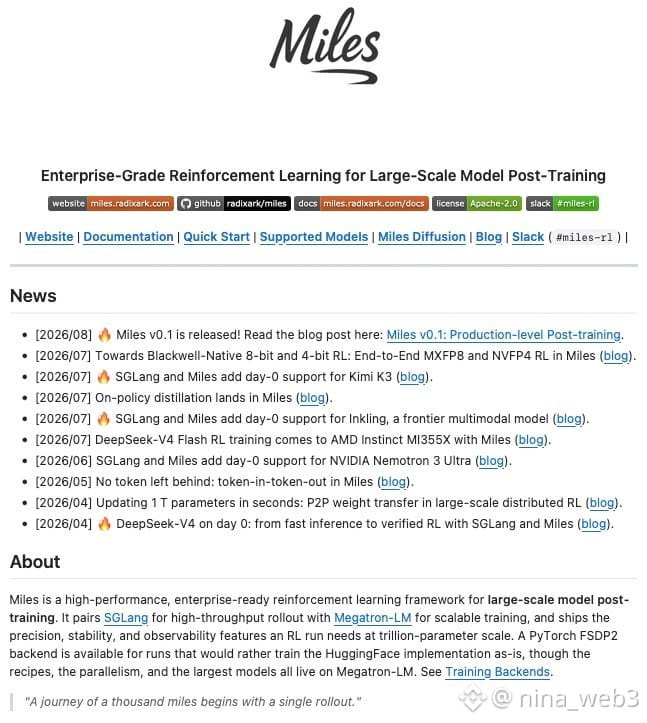
Un nouveau framework d’apprentissage par renforcement (RL) open-source vient d’être publié pour entraîner des modèles de pointe à grande échelle
Miles s’occupe des points difficiles :
• Déploiements rapides + entraînement distribué
• Synchronisation des poids à travers d’immenses clusters
• Gestion de la mémoire pour les LLM et les VLM
Déjà validé sur un modèle de 744 Md de paramètres avec 64 GPU
Prend en charge GRPO, PPO, le RL agentique et les architectures MoE
C’est une alpha au niveau infrastructure pour toute personne qui construit ou ajuste finement de grands modèles. Le open-source signifie que vous pouvez réellement l’exécuter sans dépendre d’un verrouillage fournisseur
Dépôt lié dans le post original
Miles s’occupe des points difficiles :
• Déploiements rapides + entraînement distribué
• Synchronisation des poids à travers d’immenses clusters
• Gestion de la mémoire pour les LLM et les VLM
Déjà validé sur un modèle de 744 Md de paramètres avec 64 GPU
Prend en charge GRPO, PPO, le RL agentique et les architectures MoE
C’est une alpha au niveau infrastructure pour toute personne qui construit ou ajuste finement de grands modèles. Le open-source signifie que vous pouvez réellement l’exécuter sans dépendre d’un verrouillage fournisseur
Dépôt lié dans le post original