


Google, avec DeepMind et d’autres institutions, publie l’article Dream-RSI et propose d’utiliser le mécanisme « faire des rêves » pour permettre à l’IA d’effectuer une amélioration récursive de soi.
Article par : Xin Zhiyuan
Google, peut-être a déjà percé le RSI !
Juste à l’instant, Google, en collaboration avec Google DeepMind, l’Université du Maryland et l’Université de Virginie, a publié un article très remarqué.
Cette fois, ils montrent une voie de RSI complètement différente : l’évolution auto de l’IA peut, elle aussi, s’appuyer sur le fait de « rêver » ?
Cette fois, Google demande aux agents de sauvegarder chaque étape qu’ils ont parcourue sous forme d’un arbre, puis de « faire des rêves » dans cet arbre.
S’entraîner à de meilleures stratégies d’exploration dans les rêves, puis revenir dans la réalité pour continuer à travailler.
Adresse de l’article : https://arxiv.org/abs/2609.14858
L’effet de Dream-RSI peut être qualifié de franchement stupéfiant :
Pour la tâche d’optimisation algorithmique : les systèmes d’exploration évolutive dominants doivent exécuter 51 200 générations. Dream-RSI arrive à un niveau équivalent avec seulement 317 appels.
Problème de remplissage circulaire : rattraper le meilleur record maison d’AlphaEvolveV2.
Optimisation de noyaux GPU : obtenir des performances équivalentes, avec une baisse de 2,43 fois du nombre de générations.
Les poids du niveau inférieur ne changent mot pour mot ; Gemini 3.1 Pro et 3.7 Flash peuvent tous deux être utilisés.
Et en plus, un autre constat plus intéressant : donner une direction à l’IA rend au final l’IA pire que de ne pas lui en donner.
Dès que le papier est apparu sur arXiv, ça a explosé sur X. Un internaute, Mark Kretschmann, s’est exclamé : « Google vient peut-être de percer l’amélioration récursive de soi ! »
L’auteure Tong Zheng, doctorante en 2e année à l’Université du Maryland. Ce n’est qu’en été qu’elle a rejoint Google en tant que « student researcher ». Derrière elle : un groupe de 17 auteurs, y compris des chercheurs de DeepMind et des professeurs titulaires.
Pour réaliser une amélioration récursive de soi, l’agent doit apprendre à faire des rêves. Et l’histoire, c’est le monde dans lequel ils font leurs rêves.
Tong Zheng a laissé cette phrase sur Hugging Face ; c’est aussi le cœur de tout l’article.
L’histoire, c’est le monde dans lequel il fait des rêves
Ce que Dream-RSI doit résoudre, c’est l’un des goulots d’étranglement les plus difficiles du domaine entier de la recherche évolutive.
Des systèmes comme AlphaEvolve, qui utilisent des agents de codage pour faire de la recherche évolutive, ont déjà prouvé qu’ils pouvaient découvrir des algorithmes que les humains n’avaient pas trouvés. Mais ils ont un point faible : les stratégies d’exploration reposent entièrement sur des règles écrites à la main.
À quelle branche faut-il allouer plus de calcul ? Quelles branches couper dès que possible ? Quand lancer le parallélisme ? Tout cela dépend d’abord de ce qu’un ingénieur décide en amont. Une fois l’espace de recherche énorme, une stratégie fixe va gaspiller la puissance de calcul dans une impasse, et elle ne garde aucune mémoire.
Alors, est-ce que la stratégie peut évoluer toute seule ? Théoriquement oui, mais le problème se trouve dans le coût d’évaluation.
Évaluer un morceau de code candidat : un seul essai suffit pour savoir s’il est bon. En revanche, évaluer un ensemble de stratégies d’exploration demande de lui faire parcourir, avec un agent, des centaines voire des milliers de tours depuis le début, afin d’évaluer si les trésors déterrés à la fin valent la peine—et de lui attribuer une note. À chaque modification d’une version de stratégie, il faut relancer tout le processus de découverte. Attendre des jours pour obtenir un score, personne n’en a les moyens.
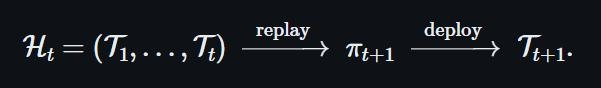
La solution de Dream-RSI à cela : sauvegarder les étapes déjà parcourues. Lors de l’évaluation d’une nouvelle stratégie, il n’est plus nécessaire de tout redémarrer : on réutilise directement la relecture des anciens processus.
Concrètement, il sépare « faire le travail » et « décider comment le faire » en deux couches.
-En bas, il y a le « Discovery Agent » responsable de l’exécution, alimenté par Gemini 3.1 Pro ou 3.7 Flash. Il prend en charge un workspace, lit le contexte, produit une nouvelle version de code candidat, puis la confie à l’évaluateur pour un score.
-En haut, une couche d’orchestration légère, qui contient « la stratégie d’exploration » (un morceau de code Python). Elle décide quels nœuds continuer à chaque tour, combien d’essais parallèles lancer en même temps, et quand arrêter si ça n’avance pas (stopper les pertes).
Le modèle de base ne bouge pas ; l’objet d’une « auto-innovation » n’est que ce code de stratégie.
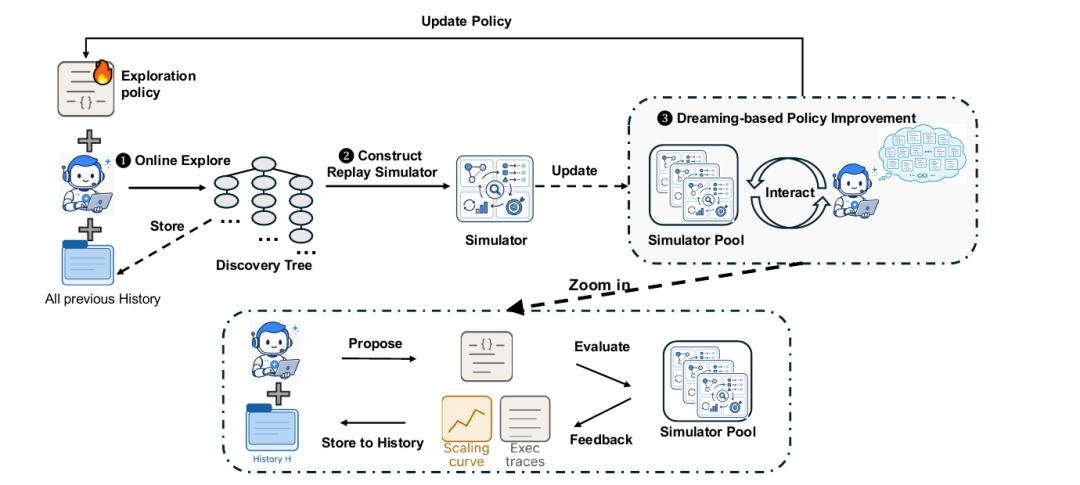
Chaque résultat d’une exploration réelle est stocké dans un « arbre de découverte ». Le nœud racine correspond au workspace initial ; chaque nœud fils enregistre une tentative complète, y compris des instantanés du système de fichiers, les productions générées, les diagnostics d’évaluation et le score.
Cet arbre, c’est le simulateur.
La décision que la stratégie doit prendre est d’un seul type : quels nœuds continuer, et combien en ouvrir à la fois. Et pour chaque nœud exploré en descendant, l’arbre enregistre déjà le résultat.
Donc, quand on veut itérer la stratégie, il n’est plus nécessaire de relancer du code dans un environnement réel : il suffit de rejouer l’histoire une fois de plus sur l’arbre préparé —
Pour essayer « avancer de deux pas sur cette voie », on lit dans l’arbre l’historique correspondant ; pour essayer « abandonner plus tôt cette voie », on lit moins de nœuds.
Tout le processus d’évaluation n’appelle pas un seul modèle, ne lance aucune ligne de code : il ne fait que lire l’historique.
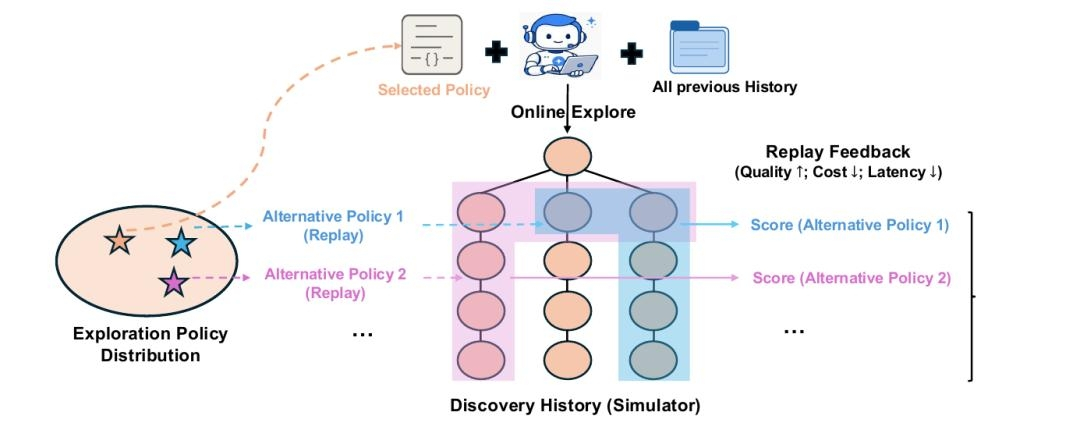
L’article appelle ce mécanisme « faire des rêves ». Comme un joueur d’échecs qui rejoue une partie sans devoir tout remettre sur l’échiquier : feuilleter le carnet de coups suffit.
Boucle fermée du fonctionnement de Dream-RSI
Sur la base de cette intuition, Google a construit le framework Dream-RSI. Sa boucle d’auto-amélioration se divise principalement en trois étapes :
1. Exploration réelle : la stratégie d’exploration la plus récente actuelle

Guider l’Agent et le faire tourner dans un environnement réel (par exemple en appelant un LLM, en compilant et en exécutant le code), puis enregistrer toutes les trajectoires, décisions et retours d’exécution générés par l’exploration comme un nouvel arbre structuré d’exploration.

Ajouté à la base de données historique

m.
2. Construire un simulateur : construire la base de données historique mise à jour

…transformé en un « pool de simulateurs de relecture » réutilisable.
3. Amélioration de stratégie basée sur le « rêve » : un agent de développement de stratégie LLM dédié commence à « faire des rêves » de façon effrénée dans ce simulateur. Il modifie et réécrit sans cesse le code des stratégies d’exploration, produisant des milliers de stratégies candidates, puis les rejoue rapidement sur le simulateur.
La note du « rêve » se compose de trois éléments : d’abord le meilleur score trouvé dans ce rêve de la manche ; ensuite on retranche le coût correspondant au nombre d’essais ; enfin la récompense en parallèle, qui encourage à exécuter en lot plusieurs essais à la fois pour une manche de stratégie.
Une stratégie qui obtient un score élevé signifie qu’elle est « plus rapide, meilleure et moins coûteuse ».
Celui qui modifie la stratégie, c’est un autre « agent de développement de stratégie ».
Il surveille trois choses : la trajectoire et le score parcourus par la stratégie actuelle dans les rêves, les retours des modifications des premières versions, et l’ensemble de l’arbre de découverte. Ensuite, après l’examen, il réécrit directement le code de la stratégie.
Après une manche, on produit plusieurs versions. Chaque version est renvoyée dans les rêves pour recevoir une note. La version ayant le meilleur score devient la stratégie officielle de la manche suivante.
Cela signifie que la limite inférieure d’une nouvelle stratégie, c’est « stagner sur place », tandis que la limite supérieure, c’est « évoluer sans fin ».
La boucle à la roue de l’RSI se referme ainsi.
Pourquoi cette stratégie ne deviendra jamais pire ?
Durant la phase d’amélioration hors ligne, l’agent de développement de stratégie passe par de nombreux cycles d’itération de code. Comme pour la stratégie en cours…

Il est lui-même inclus dans le pool de candidats. Ce n’est que lorsque la note de relecture composite (qui équilibre qualité d’exploration, coût de calcul et efficacité de parallélisme) d’une nouvelle stratégie réécrite sur le simulateur dépasse celle de la stratégie actuelle que la nouvelle stratégie…

…c’est ainsi qu’il gagne, puis est déployé.
Par conséquent, en mathématiques, les performances d’une nouvelle stratégie déployée avec Dream-RSI ne seront absolument pas inférieures à celles de la génération précédente. À mesure que la nouvelle stratégie est redéployée dans le monde réel pour explorer, elle ramènera un arbre d’exploration plus profond et plus vaste, ce qui fera évoluer le simulateur lui aussi.
Ainsi, l’agent et le « monde » qu’il voit grandissent ensemble dans ces engrenages qui s’emboîtent.
Après avoir amélioré la stratégie, on la met en ligne pour découvrir de nouveaux algorithmes. L’historique augmente, les rêves deviennent plus précis. Les rêves deviennent plus précis ; la stratégie continue d’évoluer. Les branches absentes de l’arbre ne peuvent pas être parcourues dans les rêves, donc chaque exploration réelle prépare le terrain pour les rêves de la manche suivante.
La première version de la stratégie était très simple : elle ouvrait un tas de « workspaces » indépendants et chacun y travaillait en tête. Dans les tours suivants, la stratégie a appris à répartir les efforts avec précision.
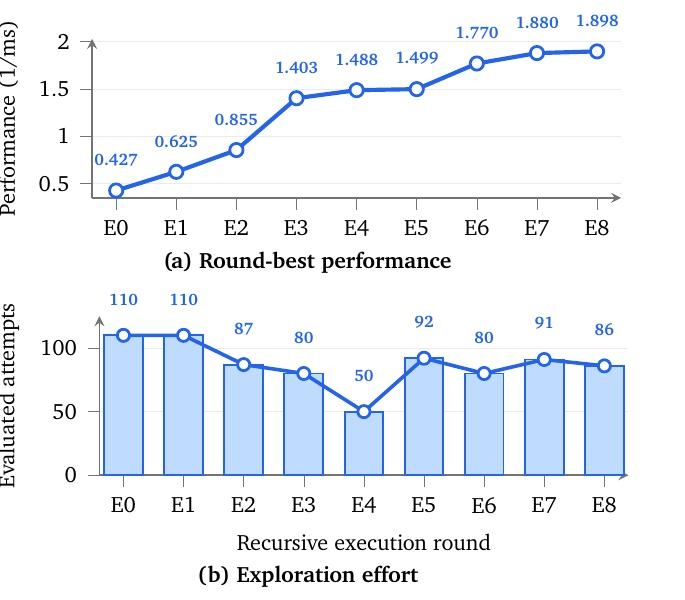
Dans l’expérience de noyau ConvDiv, lorsque la performance était en hausse, la stratégie réduisait volontairement le nombre d’essais de 110 à 50 à chaque tour ; une fois que la performance se stabilisait, elle augmentait à nouveau l’intensité d’exploration, et le score repartait aussitôt à la hausse.
Personne ne lui a appris à faire ça ; c’est lui qui a « compris » en puisant dans son propre historique.
317 fois pour surpasser 50 000 générations : et ce sont les humains qui deviennent un fardeau
L’article mesure ces approches dans trois domaines.
1. Ingénierie d’algorithmes : solveur du chemin de régularisation Lasso
Le premier domaine concerne l’ingénierie d’algorithmes : le problème du chemin de régularisation Lasso. C’est un vieux dur dans la statistique haute dimension : il faut, tout en garantissant la validité numérique, calculer tout le chemin aussi vite que possible.
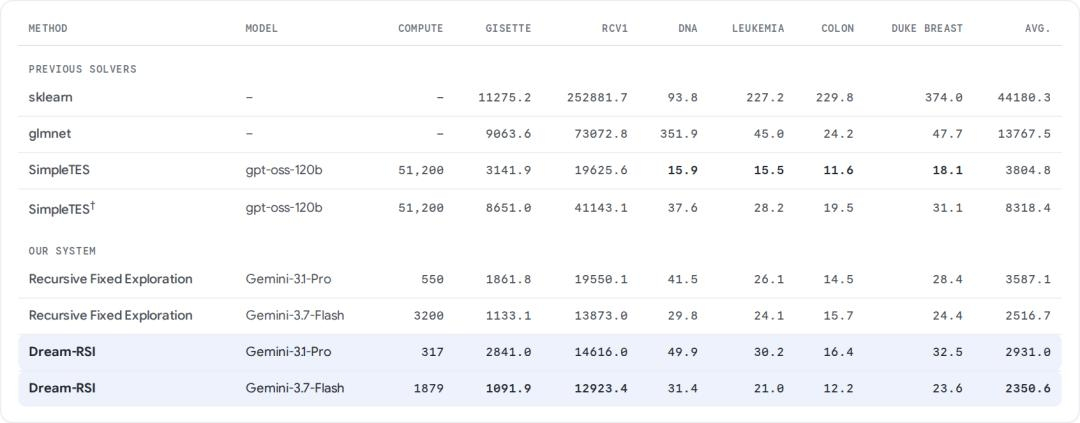
Faisant tourner Dream-RSI avec Gemini 3.1 Pro, l’équipe n’a fait que 317 appels pour réduire le temps moyen d’exécution du solveur de 3587,1 millisecondes à 2931,0 millisecondes.
En revanche, avec la même modèle mais une stratégie fixe, il faut appeler 550 fois pour atteindre ce niveau. Pour que la base de référence SimpleTES obtienne un résultat à peu près équivalent, elle a généré au total 51 200 fois.
Après l’avoir remplacé par un Gemini 3.7 Flash plus abordable, le modèle n’a plus consommé que 1879 appels : il a réussi à ramener le temps d’exécution à 2350,6 millisecondes.
Comme l’évolution se produit au niveau de l’exploration, sans lien avec la taille du modèle de base, un petit modèle peut lui aussi en profiter.
Le solveur qu’il extrait : dans la base de référence, la méthode choisit soit LARS soit la descente de coordonnées en fonction de la dimension du problème. Tandis que la solution trouvée par Dream-RSI intègre directement l’adaptatif dans l’optimisation de l’ensemble actif.
Plus précisément : d’abord, utiliser des règles puissantes pour filtrer une première fois les caractéristiques ; ensuite appliquer le découpage KKT via l’inégalité de Cauchy-Schwarz ; et seulement quand l’évaluation de la borne supérieure ne permet pas de trancher une caractéristique, on revient calculer le gradient exact.
2. Optimisation mathématique : trois tâches mathématiques difficiles
Dans le domaine de l’optimisation mathématique, l’écart devient encore plus grand.
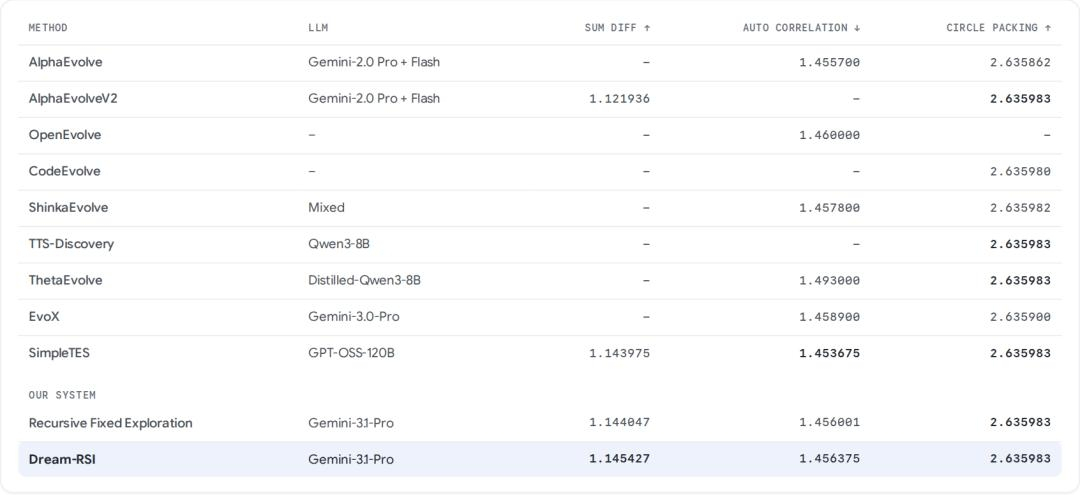
Sur trois problèmes d’optimisation discret et géométrique particulièrement coûteux en calcul—« problèmes d’addition/soustraction », « remplissage circulaire » et « inégalités pour l’inégalité d’auto-corrélation »—Dream-RSI atteint ou dépasse les performances d’une base très solide en moins de 1000 générations.
Par rapport à SimpleTES qui nécessite un budget de calcul de 51 200 générations, Dream-RSI économise plus de 50 fois le budget de calcul, tout en obtenant des résultats équivalents voire meilleurs.
3. Ingénierie d’opérateurs GPU : KernelBench au maximum
Le troisième domaine, c’est l’ingénierie de noyaux GPU—et c’est aussi le terrain que Google tient le plus à cœur.
Ici, l’article teste au total quatre noyaux.
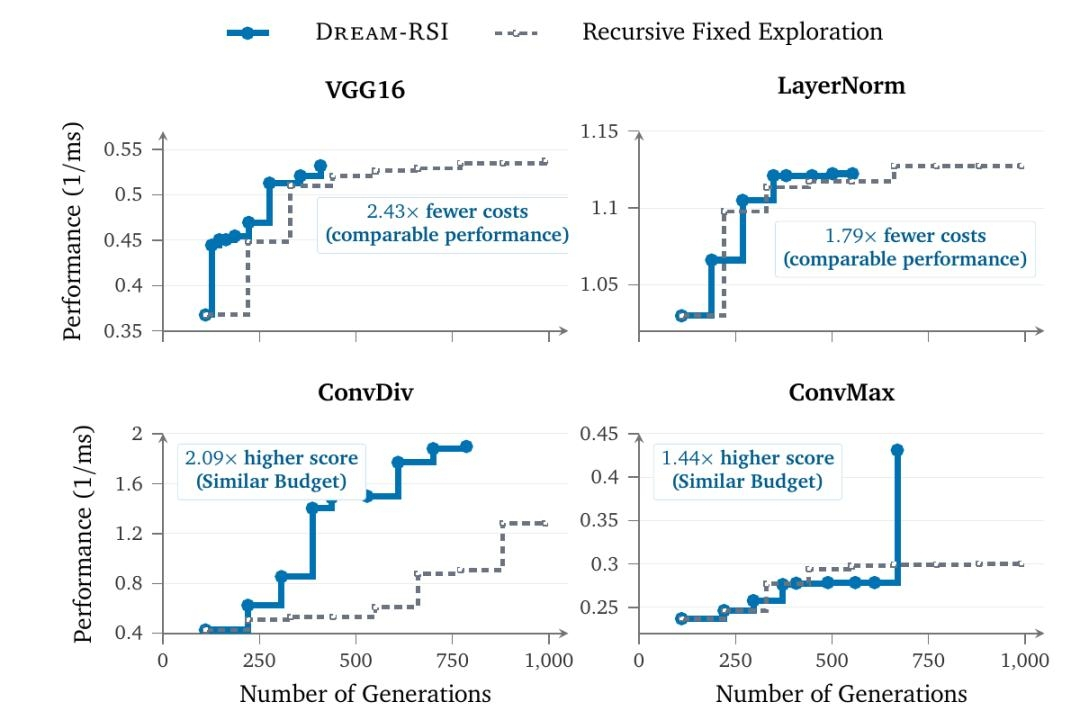
VGG16 et LayerNorm comparent à combien d’économies on peut les faire : en poussant le noyau à obtenir des performances identiques à celles d’une exploration fixe, Dream-RSI n’a besoin que de 1/2,43 et 1/1,79 des nombres de générations respectifs de l’autre méthode.
ConvDiv et ConvMax comparent la puissance à quel point : à budget identique pour les deux côtés, les performances de noyau optimisées par Dream-RSI sont respectivement 2,09 fois et 1,44 fois celles d’une exploration fixe.
Enfin, l’équipe de recherche a distillé les trajectoires historiques précédentes en invites directionnelles, les a mises dans le prompt et a « enseigné pas à pas » à l’agent où aller.
Les résultats sont un peu inattendus : à budget identique, avec une guidance humaine, c’est systématiquement pire qu’en l’absence de guidance.
Analyse approfondie : donner directement à l’IA « un résumé d’expérience », est-ce que ça marche moins bien ?
Dans l’article, il y a une expérience très contre-intuitive.
Les chercheurs ont tenté la « méthode de résumé d’expérience », pour que le grand modèle résume l’historique en directives de haut niveau afin de guider la prochaine exploration.
Pourtant, les résultats expérimentaux sont sidérants : l’Agent injecté avec un résumé d’expérience de haut niveau n’améliore pas les performances d’exploration ; au contraire, il est nettement pire que le baseline brut sans aucune guidance !
La raison derrière tout cela, c’est qu’une fois que vous abstraisez durement l’expérience en « principes de haut niveau », ils se transforment immédiatement en biais cognitifs d’IA. Ils sur-contrôlent l’espace de recherche de l’IA, étouffent la diversité de l’exploration et enferment l’IA dans des solutions sous-optimales locales.
Au contraire, le mécanisme de « rêve » de Dream-RSI ne fournit aucune « vérité creuse ». Il envoie directement la nouvelle stratégie percuter l’arbre historique concret, en optimisant au niveau du code le contrôle de parallélisme fin, les priorités de branches et les règles d’arrêt anticipé.
Cette façon de faire maintient l’espace d’exploration ouvert et diversifié ; au contraire, elle surpasse nettement la première approche.
Le stagiaire d’été a mené l’ouvrage, avec derrière lui une équipe de rêve de 17 personnes
Tong Zheng (郑童), premier auteur. Diplômé de premier cycle de l’Université Northeastern en 2021. Pendant ses études, il a fait de la recherche dans le groupe de traduction de machines le plus dur en Chine (groupe Xiao Tong).
En 2024, il est entré à l’Université du Maryland pour un doctorat, sous la supervision du professeur Huang Heng. Dream-RSI est précisément le produit de son stage Student Researcher chez Google à l’été 2026.
Du décodage opportuniste où le modèle sort plusieurs brouillons (ICLR 2025) jusqu’à Parallel-R1 et Parallel-Probe (ICLR 2026 et ICML 2026, qui enseignent une réflexion en pensée parallèle au modèle via l’apprentissage par renforcement), tout cela revient à se battre pour la même chose : empêcher le modèle de s’engager dans une seule voie sans issue.
Dans l’évaluation de Dream-RSI, l’élément « récompense en parallèle » s’inscrit dans la continuité de cette même idée. Autrefois, on rendait la réflexion du modèle parallèle ; maintenant, on rend l’exploration des agents parallèle.
Le mentor Huang Heng, premier titulaire de la chaire Brendan Iribe à l’Université du Maryland, environ 300 articles dans des conférences majeures, et à son actif 7 projets NSF et 3 projets NIH. Ces deux dernières années, les étudiants du groupe de Huang se sont jetés à corps perdu dans l’inférence par modèles de grande taille.
Dans l’équipe de 17 auteurs, l’auteur correspondant Xidong Wu et Zheng Zhang travaillent chez Google ; côté DeepMind, il y a aussi l’auteur de SASRec Wang-Cheng Kang, que les gens du cercle des systèmes de recommandation connaissent bien.
Un stagiaire d’été en premier auteur, et derrière lui une équipe de chercheurs seniors signant tous. Chez Google, l’importance accordée à cette voie se passe de commentaire.
Le canal secret vers l’ASI a déjà été ouvert ?
Auparavant, le responsable produit chez Google, Logan Kilpatrick, a révélé une grande nouvelle : Google surveille de près le front, et a déjà vu les premiers signes du RSI !
Il a avancé Gemini 3.5 à 3.8 comme preuves, mises à jour toutes les trois à quatre semaines environ, et a aussi indiqué que Gemini 4 serait à ce jour le plus grand et le plus ambitieux modèle de pré-entraînement—avec l’espoir de reprendre la position de domination.
Il insiste sur le fait qu’il faut investir la puissance de calcul et la main-d’œuvre dans l’écriture de code, la recherche et les sciences, car ce sont les choses qui risquent le plus d’accélérer et de rendre la prochaine phase d’entraînement plus économique.
Pourquoi Google croit-il autant que le RSI est en train de se produire ?
Parce que le paradigme de l’auto-amélioration de l’IA est en train de changer en silence. Pendant la décennie passée, chaque fois qu’on parlait de RSI dans l’industrie, tout le monde pensait à « l’IA modifie automatiquement ses propres poids, entraînant ainsi la prochaine entité quasi divine ».
Mais Dream-RSI montre une autre possibilité : les poids du modèle ne doivent pas nécessairement changer d’abord. Il peut devenir plus fort en réécrivant le « Harness » (périphérique) autour de lui !
Quand le modèle possède cette capacité puissante, il utilise la puissance de calcul la plus bon marché pour résoudre les problèmes les plus difficiles.
Comme dit la conclusion de l’article :
Pour effectuer une amélioration récursive de soi, l’agent doit apprendre à faire des rêves. Et l’histoire, c’est tout le monde dans lequel il fait ses rêves.
À l’approche de modèles de pré-entraînement ultra-géants comme Gemini 4, l’RSI de « rêves dans une histoire virtuelle » arrive—et il ne nous resterait peut-être plus qu’un pas avant l’explosion d’intelligence à grande échelle.