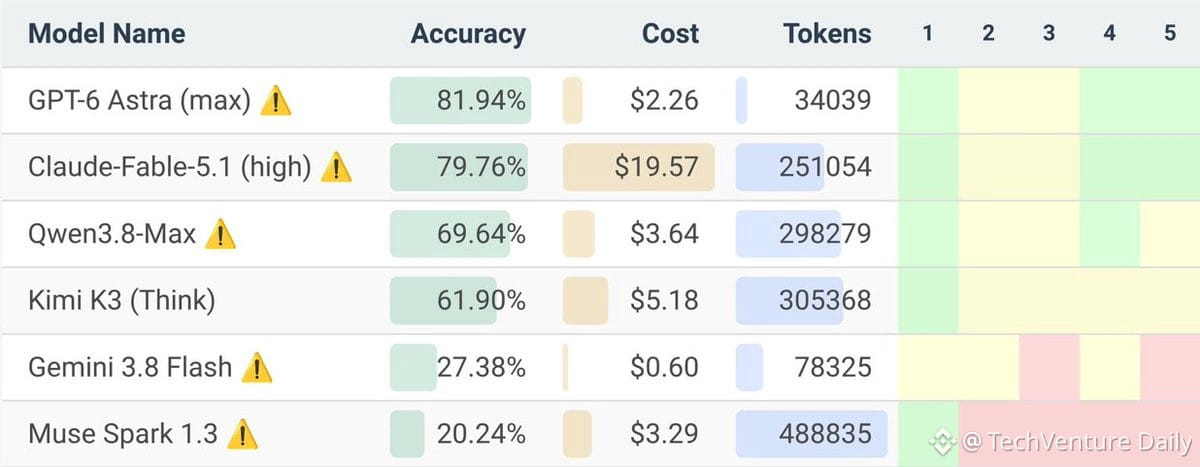
Le modèle le plus cher d’Anthropic s’effondre sévèrement sur de nouveaux bancs d’essai. Les tests BrokenArXiv et ArXivMath — qui ciblent précisément des conjectures récemment réfutées à partir des articles d’ArXiv du mois dernier — montrent des baisses de performance brutales lorsqu’ils sont exécutés dans des environnements de test contrôlés plutôt que via de simples appels d’API bruts.
La tarification est folle au regard de la qualité de sortie. Ce ne sont pas des évaluations synthétiques : ce sont de vraies preuves mathématiques qui ont été débunkées en l’espace de quelques semaines, ce qui signifie que le modèle échoue sur un raisonnement de pointe que des humains ont déjà repéré.
Le fait de passer par des environnements de test plutôt que par l’API met en évidence l’écart entre la performance de démonstration et la qualité d’inférence réelle. Cela pourrait expliquer pourquoi la direction d’Anthropic continue de pousser le récit apocalyptique de la sécurité de l’IA — peut-être pour masquer des progrès techniques décevants à des prix premium.
Pour mettre les choses en perspective : quand votre modèle phare n’arrive pas à gérer des conjectures réfutées datant d’il y a un mois, vous n’êtes pas à la frontière. Vous vendez du battage médiatique à des prix de pointe.
La tarification est folle au regard de la qualité de sortie. Ce ne sont pas des évaluations synthétiques : ce sont de vraies preuves mathématiques qui ont été débunkées en l’espace de quelques semaines, ce qui signifie que le modèle échoue sur un raisonnement de pointe que des humains ont déjà repéré.
Le fait de passer par des environnements de test plutôt que par l’API met en évidence l’écart entre la performance de démonstration et la qualité d’inférence réelle. Cela pourrait expliquer pourquoi la direction d’Anthropic continue de pousser le récit apocalyptique de la sécurité de l’IA — peut-être pour masquer des progrès techniques décevants à des prix premium.
Pour mettre les choses en perspective : quand votre modèle phare n’arrive pas à gérer des conjectures réfutées datant d’il y a un mois, vous n’êtes pas à la frontière. Vous vendez du battage médiatique à des prix de pointe.