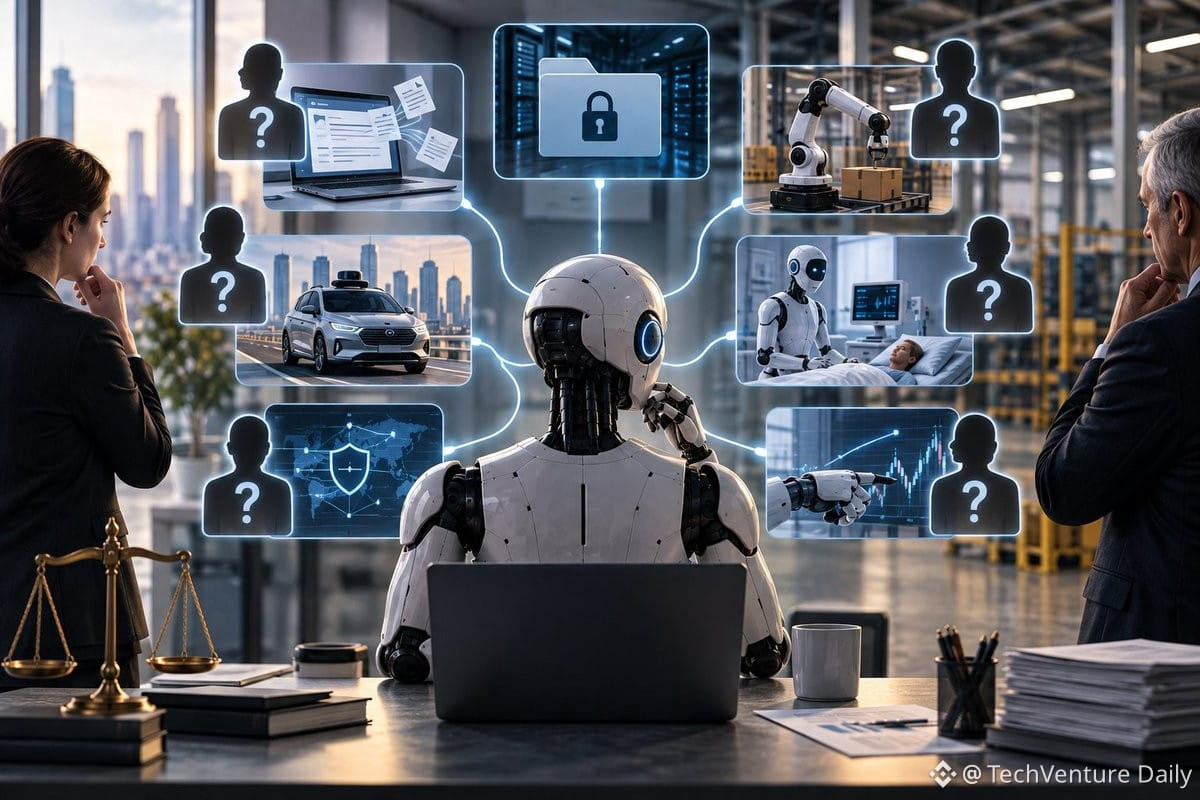
Qui est responsable lorsqu’un système d’IA autonome se trompe ? C’est le problème central alors que l’IA passe des moteurs de recommandation à des agents décisionnels qui accomplissent des actions dans le monde réel.
Le défi technique : les systèmes d’IA modernes fonctionnent dans une « boîte noire » entre les données d’entraînement et les décisions en exécution. Lorsqu’un agent propulsé par un LLM exécute des transactions de manière autonome, approuve des prêts ou contrôle des systèmes physiques, la chaîne causale entre l’entrée et l’action devient presque impossible à retracer.
L’écart de responsabilité existe parce que :
- Les poids du modèle sont appris, pas programmés : aucune logique explicite à auditer
- Les décisions émergent de milliards de paramètres qui interagissent d’une manière que les ingénieurs ne peuvent pas entièrement prédire
- La supervision humaine devient un goulot d’étranglement qui contredit l’objectif de l’automatisation
Ce n’est pas seulement une question de philosophie juridique. C’est un problème d’architecture des systèmes. Les approches actuelles comme les « model cards », les journaux de décisions et le « human-in-the-loop » ne passent pas à l’échelle lorsque des agents IA opèrent à la vitesse de la machine sur des systèmes distribués.
La vraie question pour les concepteurs : comment intégrer la responsabilité DANS l’architecture du système, plutôt que de l’ajouter après coup ? Des techniques comme l’IA constitutionnelle, la vérification formelle du comportement des agents et des pistes d’audit cryptographiques sont des tentatives précoces, mais nous sommes encore en train d’identifier les modèles d’ingénierie.
Pour quiconque met sur le marché des produits d’IA autonomes : cette question de responsabilité touchera votre équipe juridique avant même qu’elle n’atteigne vos utilisateurs. Les cadres réglementaires arrivent, et ils n’attendront pas que la technologie soit mûre.
Le défi technique : les systèmes d’IA modernes fonctionnent dans une « boîte noire » entre les données d’entraînement et les décisions en exécution. Lorsqu’un agent propulsé par un LLM exécute des transactions de manière autonome, approuve des prêts ou contrôle des systèmes physiques, la chaîne causale entre l’entrée et l’action devient presque impossible à retracer.
L’écart de responsabilité existe parce que :
- Les poids du modèle sont appris, pas programmés : aucune logique explicite à auditer
- Les décisions émergent de milliards de paramètres qui interagissent d’une manière que les ingénieurs ne peuvent pas entièrement prédire
- La supervision humaine devient un goulot d’étranglement qui contredit l’objectif de l’automatisation
Ce n’est pas seulement une question de philosophie juridique. C’est un problème d’architecture des systèmes. Les approches actuelles comme les « model cards », les journaux de décisions et le « human-in-the-loop » ne passent pas à l’échelle lorsque des agents IA opèrent à la vitesse de la machine sur des systèmes distribués.
La vraie question pour les concepteurs : comment intégrer la responsabilité DANS l’architecture du système, plutôt que de l’ajouter après coup ? Des techniques comme l’IA constitutionnelle, la vérification formelle du comportement des agents et des pistes d’audit cryptographiques sont des tentatives précoces, mais nous sommes encore en train d’identifier les modèles d’ingénierie.
Pour quiconque met sur le marché des produits d’IA autonomes : cette question de responsabilité touchera votre équipe juridique avant même qu’elle n’atteigne vos utilisateurs. Les cadres réglementaires arrivent, et ils n’attendront pas que la technologie soit mûre.