J’ai récemment mieux compris KGeN : ce dont l’IA manque peut-être vraiment, ce n’est pas plus de données —
En étudiant KGeN récemment, mon plus grand ressenti est le suivant : plus il y a de données, plus il est peut-être important de savoir si elles proviennent réellement d’humains.
Avant, quand je voyais des projets d’IA parler de données, je n’y restais généralement pas longtemps. Après tout, il y a de tout sur Internet aujourd’hui.
Mais le problème, c’est précisément là.
Les articles, images et sons générés par IA sont de plus en plus nombreux, et les comptes de robots deviennent aussi de plus en plus courants. Si, à l’avenir, l’IA devait apprendre massivement à partir de contenus déjà générés par l’IA, est-ce qu’on pourrait entrer dans une boucle ?
IA génère → IA apprend → re-génère → re-entraine l’IA.
Le volume augmente, mais l’expérience réelle des humains pourrait, elle, diminuer.
C’est aussi pour cela que j’ai commencé à regarder KGeN sérieusement.
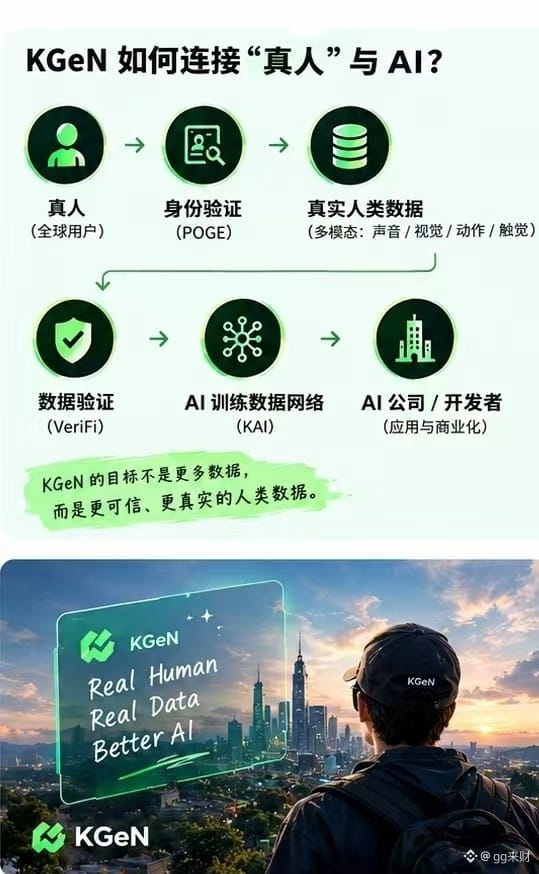
Pour l’instant, KGeN se positionne comme un Verified Human Network (Réseau d’Humains Vérifiés). Son axe principal est d’obtenir des données multimodales réelles, provenant d’humains vérifiés, afin de soutenir la Physical AI et les LLM. Les types de données mentionnés officiellement incluent la voix, la vision, les mouvements et le toucher, et le réseau couvre 60+ pays.
Je pense que le point le plus intéressant à réfléchir ici n’est pas le concept “IA”, très tendance, mais plutôt :
À l’avenir, pour que l’IA comprenne vraiment le monde réel, doit-elle d’abord comprendre de vrais humains ?
Par exemple, pour qu’un robot apprenne à vivre dans un environnement réel, se contenter de regarder des images trouvées sur Internet ne suffit probablement pas.
Il doit savoir comment les humains parlent, agissent et observent l’environnement, et même quelles réactions les humains peuvent avoir dans différents contextes.
À ce moment-là, les données humaines réelles ne posent plus seulement un problème de quantité : c’est surtout une question d’origine et de qualité des données.
L’approche actuelle de KGeN consiste à relier des données multimodales de personnes réelles, vérifiées, et des besoins d’entraînement de l’IA. Dans son système de produits, on trouve aussi K-Quest : des tâches réalisées par des humains vérifiés pour collecter les données multimodales nécessaires à la Physical AI et aux LLM.
Bien sûr, je ne dis pas pour autant que KGeN réussira forcément dès maintenant.
Pour moi, il est surtout important de continuer à observer :
Est-ce que le nombre d’utilisateurs réels pourra croître durablement ?
Les besoins en données pourront-ils continuer à générer des données ?
Ces données pourront-elles être réellement utilisées par des entreprises d’IA ?
Et enfin, pourra-t-on former une boucle commerciale durable ?
Ces questions sont bien plus intéressantes que de simplement regarder les prix à court terme.
Je continue donc à observer la réponse…
#KGen
En étudiant KGeN récemment, mon plus grand ressenti est le suivant : plus il y a de données, plus il est peut-être important de savoir si elles proviennent réellement d’humains.
Avant, quand je voyais des projets d’IA parler de données, je n’y restais généralement pas longtemps. Après tout, il y a de tout sur Internet aujourd’hui.
Mais le problème, c’est précisément là.
Les articles, images et sons générés par IA sont de plus en plus nombreux, et les comptes de robots deviennent aussi de plus en plus courants. Si, à l’avenir, l’IA devait apprendre massivement à partir de contenus déjà générés par l’IA, est-ce qu’on pourrait entrer dans une boucle ?
IA génère → IA apprend → re-génère → re-entraine l’IA.
Le volume augmente, mais l’expérience réelle des humains pourrait, elle, diminuer.
C’est aussi pour cela que j’ai commencé à regarder KGeN sérieusement.
Pour l’instant, KGeN se positionne comme un Verified Human Network (Réseau d’Humains Vérifiés). Son axe principal est d’obtenir des données multimodales réelles, provenant d’humains vérifiés, afin de soutenir la Physical AI et les LLM. Les types de données mentionnés officiellement incluent la voix, la vision, les mouvements et le toucher, et le réseau couvre 60+ pays.
Je pense que le point le plus intéressant à réfléchir ici n’est pas le concept “IA”, très tendance, mais plutôt :
À l’avenir, pour que l’IA comprenne vraiment le monde réel, doit-elle d’abord comprendre de vrais humains ?
Par exemple, pour qu’un robot apprenne à vivre dans un environnement réel, se contenter de regarder des images trouvées sur Internet ne suffit probablement pas.
Il doit savoir comment les humains parlent, agissent et observent l’environnement, et même quelles réactions les humains peuvent avoir dans différents contextes.
À ce moment-là, les données humaines réelles ne posent plus seulement un problème de quantité : c’est surtout une question d’origine et de qualité des données.
L’approche actuelle de KGeN consiste à relier des données multimodales de personnes réelles, vérifiées, et des besoins d’entraînement de l’IA. Dans son système de produits, on trouve aussi K-Quest : des tâches réalisées par des humains vérifiés pour collecter les données multimodales nécessaires à la Physical AI et aux LLM.
Bien sûr, je ne dis pas pour autant que KGeN réussira forcément dès maintenant.
Pour moi, il est surtout important de continuer à observer :
Est-ce que le nombre d’utilisateurs réels pourra croître durablement ?
Les besoins en données pourront-ils continuer à générer des données ?
Ces données pourront-elles être réellement utilisées par des entreprises d’IA ?
Et enfin, pourra-t-on former une boucle commerciale durable ?
Ces questions sont bien plus intéressantes que de simplement regarder les prix à court terme.
Je continue donc à observer la réponse…
#KGen