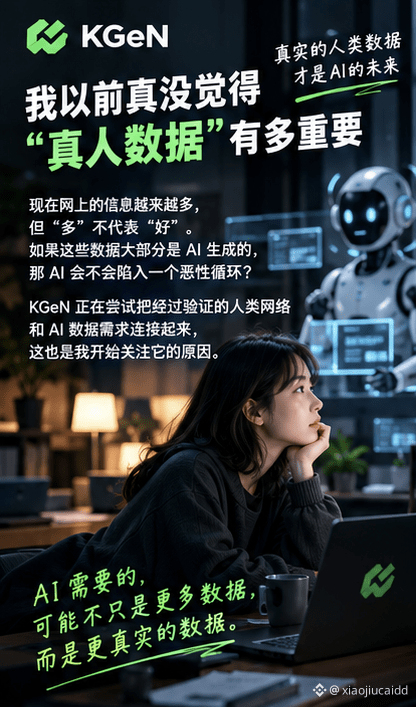
Je ne pensais vraiment pas avant à quel point les « données réelles » étaient importantes
Avant, quand je voyais des projets d’IA parler de données, je les survolais essentiellement.
Le volume de données, la taille du modèle, avec qui ça collabore… à force, tout se ressemblait.
Mais récemment, en découvrant KGeN, je me suis au contraire intéressé à une question très simple :
Si, à l’avenir, les données d’entraînement de l’IA deviennent de plus en plus générées par l’IA, qui pourra alors prouver que ces données viennent au départ de vrais humains ?
C’est en fait assez fascinant.
En ligne, il y a de plus en plus d’informations, mais « plus » ne veut pas dire « mieux ».
Un article peut être écrit par une IA, une image peut être générée par une IA, et même un commentaire peut être produit en masse par des robots.
Si on continue à utiliser ce type de contenu pour entraîner la génération suivante d’IA, on risque au final d’entrer dans une boucle très étrange :
Données générées par l’IA → apprentissage par l’IA → génération de encore plus de données → entraînement de l’IA.
Il y a de plus en plus de données, mais les expériences humaines réelles deviennent au contraire de plus en plus rares.
C’est aussi pour ça que je commence à m’intéresser à KGeN récemment.
L’orientation de KGeN n’est pas simplement de créer un autre « data platform », mais de relier un réseau humain vérifié aux besoins en données de l’IA.
Les axes mis en avant par l’officiel incluent actuellement Verified Human, ainsi que des données multi-modales de Sound / Sight / Motion / Touch, et aussi Physical AI et LLM.
Je trouve que le vrai intérêt de cette direction ne tient pas aux deux mots « IA ».
Mais plutôt à :
Quand il y aura de plus en plus d’IA, est-ce que les humains eux-mêmes ne deviendront pas, au final, une ressource rare ?
À mon avis, cette question mérite d’être observée en continu chez KGeN.
#KGEN
Avant, quand je voyais des projets d’IA parler de données, je les survolais essentiellement.
Le volume de données, la taille du modèle, avec qui ça collabore… à force, tout se ressemblait.
Mais récemment, en découvrant KGeN, je me suis au contraire intéressé à une question très simple :
Si, à l’avenir, les données d’entraînement de l’IA deviennent de plus en plus générées par l’IA, qui pourra alors prouver que ces données viennent au départ de vrais humains ?
C’est en fait assez fascinant.
En ligne, il y a de plus en plus d’informations, mais « plus » ne veut pas dire « mieux ».
Un article peut être écrit par une IA, une image peut être générée par une IA, et même un commentaire peut être produit en masse par des robots.
Si on continue à utiliser ce type de contenu pour entraîner la génération suivante d’IA, on risque au final d’entrer dans une boucle très étrange :
Données générées par l’IA → apprentissage par l’IA → génération de encore plus de données → entraînement de l’IA.
Il y a de plus en plus de données, mais les expériences humaines réelles deviennent au contraire de plus en plus rares.
C’est aussi pour ça que je commence à m’intéresser à KGeN récemment.
L’orientation de KGeN n’est pas simplement de créer un autre « data platform », mais de relier un réseau humain vérifié aux besoins en données de l’IA.
Les axes mis en avant par l’officiel incluent actuellement Verified Human, ainsi que des données multi-modales de Sound / Sight / Motion / Touch, et aussi Physical AI et LLM.
Je trouve que le vrai intérêt de cette direction ne tient pas aux deux mots « IA ».
Mais plutôt à :
Quand il y aura de plus en plus d’IA, est-ce que les humains eux-mêmes ne deviendront pas, au final, une ressource rare ?
À mon avis, cette question mérite d’être observée en continu chez KGeN.
#KGEN