Quand j’ai suivi une mise à niveau de la blockchain auparavant, j’avais surtout tendance à négliger quelque chose qui n’est en réalité pas la notion de consensus, mais plutôt ces contrôles de données qui paraissent incroyablement ennuyeux.
Cette fois, en relisant les dernières mises à jour de développement de Dusk, je me suis arrêté un moment sur la partie Merkle.
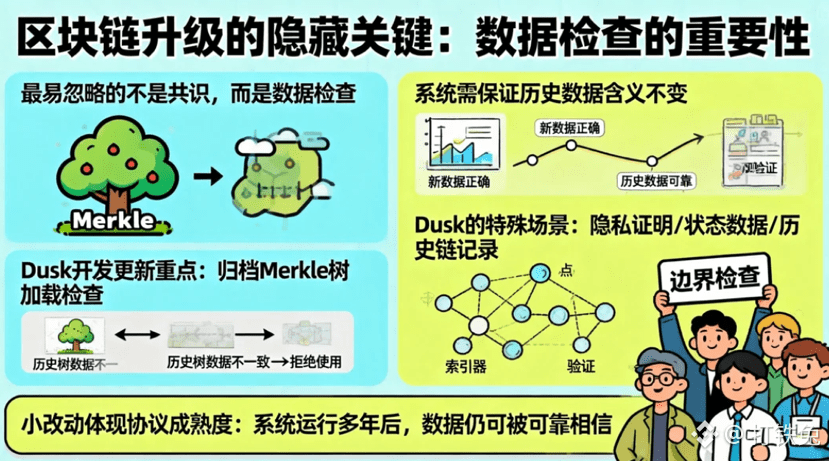
Récemment, l’officiel a renforcé spécialement les contrôles lors du chargement des arbres Merkle archivés :
Si les données historiques de l’arbre ne concordent pas, on refuse simplement de continuer à les utiliser.
À première vue, il n’y a vraiment pas de « narration ».
Mais je pense au contraire que ce type de modification mérite davantage d’attention que l’ajout d’une nouvelle fonctionnalité.
Parce que l’un des problèmes les plus pénibles d’une blockchain, c’est que le système ne peut pas se contenter de garantir que « les nouvelles données sont correctes ».
Il faut aussi garantir que :
**les données déjà écrites auparavant ne changent pas silencieusement de sens quand on les relit aujourd’hui.**
Et surtout pour un réseau comme Dusk, qui doit traiter des preuves de confidentialité, des données d’état et des enregistrements historiques on-chain : les données archivées ne sont pas de simples fichiers.
Elles peuvent continuer d’être utilisées par des nœuds, des indexeurs et dans les processus de vérification.
Dès que les données historiques deviennent problématiques, le vrai souci n’est pas qu’une API renvoie une erreur.
C’est que différents composants peuvent commencer à croire des versions différentes de l’état.
Avant, j’avais plutôt l’habitude de juger une chaîne à partir de grands indicateurs comme le TPS, la finalité ou le ZK.
Aujourd’hui, je me dis plutôt que ce qui permet vraiment de voir la maturité d’un protocole, ce sont parfois ces petites modifications pour lesquelles personne ne veut faire de publicité.
Parce que cela montre que l’équipe de développement commence à traiter un problème très concret :
**Ce n’est pas seulement « le système peut-il fonctionner », mais « une fois que le système aura fonctionné pendant des années, les données passées pourront-elles encore être fiables et crédibles ».**
C’est d’ailleurs un type de mise à jour que j’aime particulièrement quand je reviens récemment sur Dusk.
Pas de grande narration.
Même pas de données spectaculaires.
Juste des contrôles de limites plus stricts ajoutés à un arbre Merkle historique.
Mais si une telle chose est mal faite, tout ce qui a été construit sur l’état historique peut ensuite devenir compliqué.
C’est pourquoi, quand je juge une chaîne aujourd’hui, je ne regarde pas seulement combien de nouvelles fonctionnalités elle a publiées.
Je regarde aussi si elle est prête à consacrer du temps à traiter ces problèmes que personne n’applaudit sur une scène de lancement.
Pour l’infrastructure, la vraie fiabilité se cache souvent dans ce genre de détails.
#dusk $DUSK @Dusk
Cette fois, en relisant les dernières mises à jour de développement de Dusk, je me suis arrêté un moment sur la partie Merkle.
Récemment, l’officiel a renforcé spécialement les contrôles lors du chargement des arbres Merkle archivés :
Si les données historiques de l’arbre ne concordent pas, on refuse simplement de continuer à les utiliser.
À première vue, il n’y a vraiment pas de « narration ».
Mais je pense au contraire que ce type de modification mérite davantage d’attention que l’ajout d’une nouvelle fonctionnalité.
Parce que l’un des problèmes les plus pénibles d’une blockchain, c’est que le système ne peut pas se contenter de garantir que « les nouvelles données sont correctes ».
Il faut aussi garantir que :
**les données déjà écrites auparavant ne changent pas silencieusement de sens quand on les relit aujourd’hui.**
Et surtout pour un réseau comme Dusk, qui doit traiter des preuves de confidentialité, des données d’état et des enregistrements historiques on-chain : les données archivées ne sont pas de simples fichiers.
Elles peuvent continuer d’être utilisées par des nœuds, des indexeurs et dans les processus de vérification.
Dès que les données historiques deviennent problématiques, le vrai souci n’est pas qu’une API renvoie une erreur.
C’est que différents composants peuvent commencer à croire des versions différentes de l’état.
Avant, j’avais plutôt l’habitude de juger une chaîne à partir de grands indicateurs comme le TPS, la finalité ou le ZK.
Aujourd’hui, je me dis plutôt que ce qui permet vraiment de voir la maturité d’un protocole, ce sont parfois ces petites modifications pour lesquelles personne ne veut faire de publicité.
Parce que cela montre que l’équipe de développement commence à traiter un problème très concret :
**Ce n’est pas seulement « le système peut-il fonctionner », mais « une fois que le système aura fonctionné pendant des années, les données passées pourront-elles encore être fiables et crédibles ».**
C’est d’ailleurs un type de mise à jour que j’aime particulièrement quand je reviens récemment sur Dusk.
Pas de grande narration.
Même pas de données spectaculaires.
Juste des contrôles de limites plus stricts ajoutés à un arbre Merkle historique.
Mais si une telle chose est mal faite, tout ce qui a été construit sur l’état historique peut ensuite devenir compliqué.
C’est pourquoi, quand je juge une chaîne aujourd’hui, je ne regarde pas seulement combien de nouvelles fonctionnalités elle a publiées.
Je regarde aussi si elle est prête à consacrer du temps à traiter ces problèmes que personne n’applaudit sur une scène de lancement.
Pour l’infrastructure, la vraie fiabilité se cache souvent dans ce genre de détails.
#dusk $DUSK @Dusk